设计模式——代理:动态代理的成本与边界
代理保持调用方手里的类型不变,中间多插一层。日志、鉴权、重试、延迟加载、远程调用都落在这一层上。
手写静态代理的问题是类数按「接口数 × 关注点数」涨,每个类里都是逐方法转发的样板。Proxy.newProxyInstance把这件事挪到运行时:一次调用生成一个实现全部接口的类,一个InvocationHandler接管所有方法。
代价在生成的字节码里:每个方法开头一次anewarray,每个基本类型参数一次装箱。下面用 1 亿次调用把这份代价量出来,再单独量类生成与缓存。
一、代理解决的问题
静态代理的算术
三个接口、四个关注点。日志、鉴权、重试、指标,每个都要包一层,静态写法就得写这么多个类:
    classDiagram
    direction LR
    class OrderService
    class UserService
    class PayService
    class LoggingOrder
    class AuthOrder
    class RetryOrder
    class MetricsOrder
    OrderService <|.. LoggingOrder
    OrderService <|.. AuthOrder
    OrderService <|.. RetryOrder
    OrderService <|.. MetricsOrder
    note for LoggingOrder "OrderService 一侧 4 个,UserService 与 PayService 各再来 4 个,合计 12 个类,方法体全是同样的转发"
3 × 4 = 12。叠加顺序不用再乘一遍,链式包装就够:new LoggingOrder(new RetryOrder(real))。类数只涨一层,和装饰器一样。
12 个类的内容才是负担:每个方法照抄一遍签名,转发一次调用。接口加一个方法,12 个类都要跟着改。
动态代理消掉这层样板:一个 InvocationHandler 覆盖任意接口的任意方法,代理类在运行时生成,仓库里不留一个类。
和相邻模式的分界
适配器换的是接口:调用方手里的类型和已有对象提供的类型不一致,中间加一层做转换。装饰器和代理都保持接口不变,区别在被包装对象的来源与目的:装饰器由调用方把对象传进来,加的是调用前后的行为,比如缓冲、校验;代理决定「能不能访问、访问到哪里去」,目标对象常常由代理自己创建,远程对象和延迟加载是典型场景。桥接把两个维度的变化拆开,一个维度持有另一个维度的引用,处理的是类层次结构,和单次调用路径无关。
三个模式的边界只取决于两件事:接口有没有变,被包的对象从哪来。接口变了是适配器;接口没变、对象从外面来是装饰器;接口没变、对象由包装者掌握是代理。
一次调用经过谁
动态代理的调用链比静态代理长,因为中间多了两次「通用」的跳转:
    flowchart TD
    A["调用方:proxy.calc(7)"] --> B["$Proxy0.calc(long)<br/>运行时生成的类"]
    B --> C["anewarray Object[1]<br/>Long.valueOf(7)"]
    C --> D["InvocationHandler.invoke(proxy, m3, args)"]
    D --> E["Method.invoke(target, args)"]
    E --> F["Impl.calc(long)"]
    F --> G["checkcast Long<br/>longValue()"]
    G --> H["返回 long"]
$Proxy0.calc 是生成的,InvocationHandler.invoke 是自己写的,Method.invoke 是反射入口。三段都在每次调用上,代理类的生成只发生一次,要量的是前一种。
二、动态代理生成的类长什么样
Proxy.newProxyInstance(ClassLoader, Class<?>[], InvocationHandler) 返回的实例,类型是运行时生成的 $Proxy0。它是普通类:public final,父类 java.lang.reflect.Proxy,实现调用方传入的接口。
本次实验把生成的类 dump 出来,类头是这样(javap -p,JDK 25 生成):
1 | public final class jdk.proxy1.$Proxy0 extends java.lang.reflect.Proxy implements ProxyBench$Calc { |
四个 Method 静态字段:m0 到 m2 是 hashCode、equals、toString,m3 是接口里的 calc。连 Object 的三个方法也路由到 handler,proxy.toString() 会进你的 invoke,写 handler 时要留意。
这条路由有代价:handler 若对 toString 返回一个 Integer,调用方打印代理时拿到的是异常:
1 | proxy.toString() -> ClassCastException: class java.lang.Integer cannot be cast to class java.lang.String |
生成的 toString 是 checkcast String; areturn,只要 handler 返回的不是 String,异常就抛在调用方。hashCode、equals 同理。第六节还会看到另一面:this 调用绕开代理。
handler 字段 h 在父类上,JDK 25 Proxy.java:307 一行:
1 | protected InvocationHandler h; |
所以 $Proxy0 自己只持有方法表,实例状态只有一个 handler 引用。equals 也走 handler(m1),生成的类里没有比较目标对象的逻辑,两个代理实例何时相等由 handler 决定。
calc 的方法体(javap -c):
1 | 0: aload_0 |
不到 20 条指令,做了四件事:新建参数数组、装箱参数、调 handler、拆箱返回值。
方法末尾还有一张异常表,把 Error 与 RuntimeException 原样抛出,其余全部包进 UndeclaredThrowableException。限制来自 InvocationHandler.invoke 的签名:它只声明了 Throwable,如果 handler 抛出接口方法没声明的受检异常,代理只能包一层再抛。调用方看到的是运行时异常,catch 原始受检异常会漏掉。
参数数组为什么每次新建
生成的代码在方法开头 anewarray,不复用实例上的数组。handler 可以把 args 存起来(日志、队列、重试),代理实例可能被多个线程同时调用,Method.invoke 对可变参数方法还会克隆数组;这些行为都要求数组内容在调用期间稳定,复用一个数组会把它们变成竞态。
handler 一侧
handler 最自然的写法是反射:
1 | public Object invoke(Object proxy, Method method, Object[] args) throws Throwable { |
成本结构到这里定型:每次调用一次数组分配、一次装箱、一次接口调用、一次反射调用、一次拆箱。要不要付这笔开销,取决于调用频率。
三、实验设计
被测接口一个方法,long calc(long x),实现是 x * 3 + 1。六条路径:
- 直接调用:
impl.calc(x) - 手写静态代理:一个实现
Calc的类,方法体是return target.calc(x) MethodHandle绑定句柄:MethodHandles.lookup().unreflect(Calc.class.getMethod("calc", long.class)).bindTo(impl),循环里invokeExact(i)- 动态代理 +
MethodHandle处理器:handler 里不反射,直接invokeExact - 裸
Method.invoke:不经过代理,只量反射本身 - 动态代理 +
Method.invoke处理器:最常见的写法
测量方式:
- 每条路径一个独立的循环方法。六条路径不能共用一个调用点,否则调用点变成多态,JIT 的内联决策会被污染
- 每条路径 1 亿次调用,预热 2 轮,测 5 轮取中位数
- 每轮跑在新建的线程里,用
com.sun.management.ThreadMXBean.getThreadAllocatedBytes(threadId)取循环前后的分配字节差,除以调用次数。这个计数器是每个线程的累计值,不受其他线程影响 - 计时循环持全局锁。这台机器同时跑着 22 组同类实验,不串行化的话测到的是 CPU 争抢
- 六条路径对同一组输入算出来的结果都是 145,确认循环没有被优化掉
- 机器:Apple M1 Pro,macOS Darwin 25.6.0。JDK 用
21.0.8+12-LTS-250与25+37-LTS-3491,都是 arm64
循环的样子(三条路径各一份,这里是直接调用与动态代理):
1 | static long loopDirect(Calc c, long n) { long s = 0; for (long i = 0; i < n; i++) s += c.calc(i); return s; } |
两个方法体字面一样,作用不同:它们各自是一个调用点,接收者的实际类型分别是 Impl 与 $Proxy0,JIT 在各自的位置上看到的 profile 是单态的。合并成一个方法会让那个调用点同时见到两种接收者,两边都退化成多态调用。
运行方式:
1 | $JDK21/bin/java -cp out21 ProxyBench 100000000 5 |
第二组实验(第四节的分配形状)用另一个接口,三个方法 long calc(long)、long now()、void ping(),handler 走反射并把代理传来的 args 原样转发。每个方法单独一个循环、单独一个代理实例,各跑 5000 万次 × 3 轮。为了避开包装类缓存,now() 返回 10 亿,ping() 什么都不做。
局限有三条。这不是 JMH,没有 fork、没有黑盒消费框架,只有手写的循环与一次异或归约。数据只在同一台机器、同一次运行内可比,绝对值不要搬到别处。测的是 C2 编译完成之后的稳态,JIT 之前的前几千次调用不在数里,那一段的形态与稳态不同。中位数只压掉偶发抖动,压不掉持续的 CPU 争抢。
四、实测一:1 亿次调用的六条路径
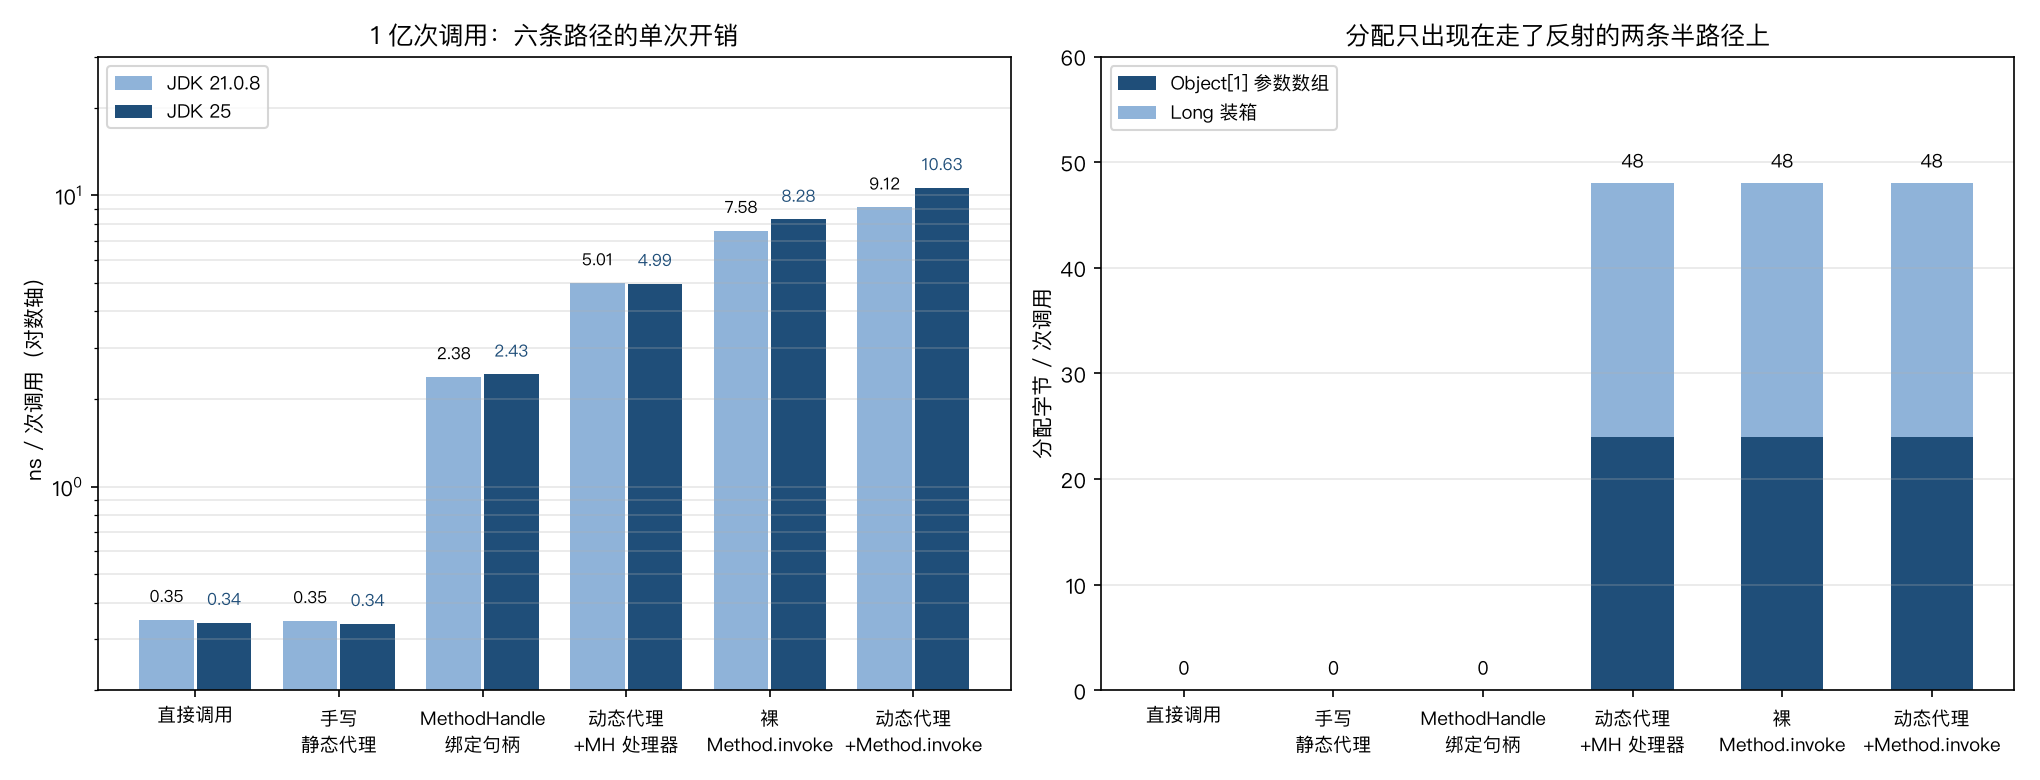
| 路径 | JDK 21 ns/次 | JDK 25 ns/次 | 分配 B/次 |
|---|---|---|---|
| 直接调用 | 0.35 | 0.34 | 0 |
| 手写静态代理 | 0.35 | 0.34 | 0 |
MethodHandle 绑定句柄 |
2.39 | 2.43 | 0 |
动态代理(MethodHandle 处理器) |
5.01 | 4.99 | 48 |
裸 Method.invoke |
7.58 | 8.28 | 48 |
动态代理(Method.invoke) |
9.12 | 10.63 | 48 |
一层转发不花钱
直接调用和手写静态代理在两个 JDK 上都是 0.35 与 0.34 纳秒,没有可分辨的差别。这个数贴着空循环本身的地板:x * 3 + 1 的累加在 JIT 之后可以被约简,它不代表一次虚调用的真实价格,只代表本次实验的时间分辨率下限。能确定的是,单态调用点上多一层转发,JIT 把它内联掉了,量不出来。
动态代理贵出来的是反射
动态代理 9.12 与 10.63 纳秒,是地板值的 26 倍与 31 倍。裸 Method.invoke 是 7.58 与 8.28,代理壳本身只占 1.5 与 2.4 纳秒。
一层转发 ≈ 0,代理壳 1.5 到 2.4 纳秒,剩下 7.6 到 8.3 纳秒全在反射上。要优化动态代理的调用路径,动 Method.invoke 的收益远大于动生成的类。
48 字节每次调用,从哪来
分配字节的中位数在两个 JDK 上都是 48.000,两笔组成:
Object[],一个元素。对象头 12 字节加长度 4 字节,加一个压缩引用 4 字节,对齐到 24 字节Long装箱。对象头 12 字节加一个 long 字段 8 字节,对齐到 24 字节
24 + 24 = 48,对应字节码里第 9 行的 anewarray 与第 15 行的 Long.valueOf。参数是 long,值超出 Long 缓存范围时每次都要新建对象,而循环变量 i 一路递增,命中不了缓存。
48 字节不是固定税
同一个代理类,换三种方法签名,分配跟着变。每组的分配字节取 5000 万次 × 3 轮的中位数,两个 JDK 与两种 handler(方法对象存字段、直接用传入的 Method)结果一致:
| 方法签名 | 生成的方法体 | 分配 B/次 |
|---|---|---|
long calc(long) |
anewarray + Long.valueOf |
48 |
long now() |
aconst_null + Long.valueOf |
24 |
void ping() |
aconst_null + pop |
0 |
数组只在方法有参数时分配。没有参数时生成的是 aconst_null,handler 收到 args == null,这也是 InvocationHandler 的契约写明的。装箱只在参数或返回值是基本类型、且值落在包装类缓存之外时发生。把 now() 的返回值换成 42(在 Long 缓存里),同一段循环的分配掉到 0。
缓存范围写在源码里,JDK 25 Long.java:994-1001:
1 |
|
动态代理每次调用分配多少,没有统一答案:有参数、基本类型、值在缓存外,是 48 字节;无参数的查询方法返回缓存内的值,是 0。返回类型、参数类型和取值范围怎么定,成本的形状就怎么变。
换成 MethodHandle 的 handler,省 CPU 不省字节
handler 换成 MethodHandle 之后,单次耗时从 9.12 降到 5.01(JDK 21),10.63 降到 4.99(JDK 25),省掉 45% 与 53%。分配仍是 48 字节,一次都没少。
原因在 InvocationHandler 的签名里:invoke(Object proxy, Method method, Object[] args) 决定了参数必须打成数组,返回值是 Object,long 必须装箱再拆箱。省下的是反射的开销,数组与装箱由 InvocationHandler 的签名强制,省不掉。要连分配一起省,只能绕开这个接口:写自己的字节码,或者用 MethodHandle 直接在调用点展开,那就不算 JDK 动态代理了。
MethodHandle 自身也不免费
绑定句柄 2.39 与 2.43 纳秒,是地板值的 7 倍。这个数字比裸反射好,也远好于代理,但不是零。调用点单态、句柄稳定时才有这个数,句柄类型一变就会退化。
两个 JDK 上的差
反射那两行,JDK 25 都比 JDK 21 慢 0.7 到 1.5 纳秒:9.12 对 10.63,7.58 对 8.28。每一轮的最小值与中位数方向一致(10.634 与 10.533 这种差别),不是单轮抖动。不追这一步的归因,只记下来:Method.invoke 的实现在两个版本之间有可测的差异,把绝对数当常数用会出错。
组内的波动很小。动态代理那一行 JDK 25 的五轮最小值是 10.534,中位数 10.633,差 1%。分配字节的五轮中位数全部是 48.000,没有一位小数的抖动。
五、实测二:类生成与缓存
首次生成,之后命中缓存
Proxy.newProxyInstance 内部先查缓存,键是「类加载器 + 接口列表」:
    flowchart TD
    A["Proxy.newProxyInstance(loader, 接口数组, handler)"] --> B["proxyCache.sub(I).computeIfAbsent(loader)"]
    B -->|命中| C["Constructor.newInstance(handler)"]
    B -->|未命中| D["ProxyGenerator.generateProxyClass"]
    D --> E["JLA.defineClass<br/>绑定到动态模块"]
    E --> C
缓存挂在类加载器对象上(ClassLoaderValue,JDK 25 ClassLoader.java:2545-2559),加载器被回收时缓存跟着走,不需要额外的弱引用簿记。
三个接口分别有 1、10、50 个方法,量三种操作的耗时。纯拼字节码直接调 ProxyGenerator;首次 newProxyInstance 换新加载器,生成类之后立刻实例化,触发静态初始化;缓存命中是同一个加载器上的第二次调用。首次那两行各取 40 个独立样本的中位数,纯拼字节码取 300 个,缓存命中取 50000 次的中位数。
| 量的是什么 | 1 个方法 | 10 个方法 | 50 个方法 |
|---|---|---|---|
| 只拼字节码,JDK 21 | 56 µs | 111 µs | 410 µs |
| 只拼字节码,JDK 25 | 113 µs | 154 µs | 446 µs |
首次 newProxyInstance,新加载器,JDK 21 |
0.49 ms | 0.62 ms | 1.03 ms |
首次 newProxyInstance,新加载器,JDK 25 |
0.77 ms | 0.70 ms | 1.51 ms |
第二次 newProxyInstance,命中缓存,JDK 21 |
375 ns | 209 ns | 208 ns |
第二次 newProxyInstance,命中缓存,JDK 25 |
375 ns | 250 ns | 208 ns |
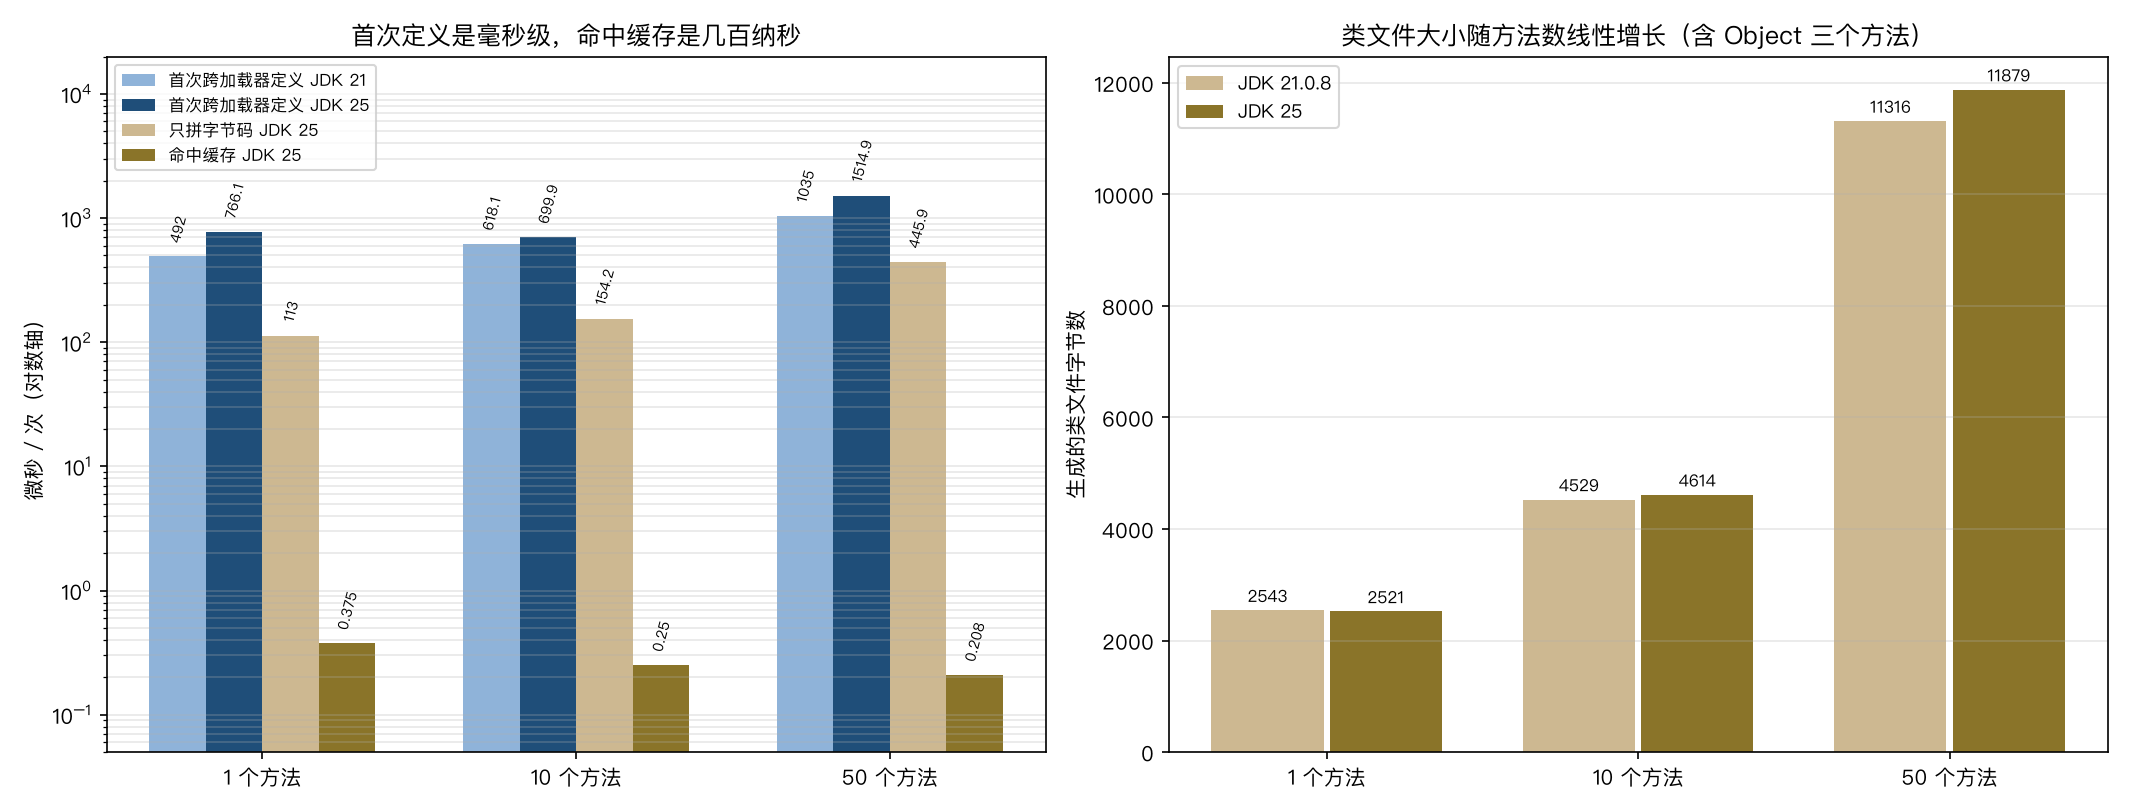
前两行是纯字节码拼接,反射调用包内可见的 ProxyGenerator.generateProxyClass,300 次取中位数。50 个方法花 0.41 到 0.45 毫秒,比 1 个方法的 56 到 113 微秒贵 4 到 8 倍。方法是逐条拼的,这条线大致线性。
第三、四行是真实的首次 newProxyInstance,每次换一个新的类加载器,40 次取中位数。单次样本的最小值与最大值差两倍以上,getProxyClass 与 newProxyInstance 的差别在这个噪声里分辨不出来,所以这两行只说明量级:首次定义一组接口在半毫秒到一毫秒半之间,其中拼字节码占 10% 到 40%,其余花在定义类、建立动态模块和类初始化上。
第五、六行是同一个加载器上的第二次调用,命中缓存,200 到 375 纳秒。首次与命中差约三个数量级,缓存挡掉的就是这一段。
类文件多大
同一个类加载器上,三个接口生成的字节码大小(ProxyGenerator 直接返回的字节数组):
| 接口方法数 | JDK 21 | JDK 25 |
|---|---|---|
1(加 Object 三个方法) |
2,543 B | 2,521 B |
| 10 | 4,529 B | 4,614 B |
| 50 | 11,316 B | 11,879 B |
折算下来每多一个方法约 175 到 190 字节,两个 JDK 的差别在 5% 以内。构成是每个方法一份转发代码、一个 Method 字段,加上静态初始化里的装载指令。
静态初始化里每个方法一次 getMethod
生成的类第一次被实例化时跑一段静态初始化,里面为每个方法准备一个 Method 对象。dump 出来的 $Proxy0 的 <clinit> 就是这么写的:hashCode、equals、toString 三次 getMethod,接口里的 calc 一次 Class.forName 加一次 getMethod。
一个 50 方法的接口,这段初始化要付 53 次方法查找。50 次 getMethod 的开销落在首次定义那半毫秒的噪声里,表里量不出来,知道就行,不用为它优化。接口的方法数才是变量:转发代码、Method 字段、静态初始化的查找次数,三项都随方法数线性增长。
同一个接口 + 同一个加载器 = 同一个类
缓存键是「类加载器 + 接口列表」,实测两个 JDK 结果一致:
1 | sameClass=true // 同一个加载器,两次 newProxyInstance |
同一个加载器上重复请求同一组接口,拿到同一个 Class。换加载器就是另一个类,名字里的序号来自全局原子计数器,一路递增。动态模块同理:每个「加载器 + 包」组合一个模块,批量测试里跑到后面,模块名会排到 jdk.proxy32、jdk.proxy63。
这条性质有个直接后果:缓存键里含加载器,热部署每换一次类加载器,代理类就要重新生成一遍,缓存帮不上忙。
dump 生成的类:JDK 25 上会失败
JDK 自带一个开关,-Djdk.proxy.ProxyGenerator.saveGeneratedFiles=true,把生成的类写到当前目录。JDK 21 上它按预期工作:类文件出现在 jdk/proxy1/$Proxy0.class,程序继续运行。同一个命令换到 JDK 25:
1 | java.lang.NullPointerException: Cannot read the array length because "b" is null |
类文件还是写出来了,代理的创建却失败了。原因在两个版本的同名方法里。JDK 21 的 ProxyGenerator.java 里,return null; 是 PrivilegedAction 的返回值,方法末尾 :204 正常返回字节数组:
1 | Files.write(path, classFile); |
JDK 25 重写后,return null; 变成了方法本身的返回语句(ProxyGenerator.java:225),原来那句 return classFile; 留在了后面的 :231,走不到了。空指针一路传到 System$1.defineClass 的 b.length(System.java:2046)。
要稳定地看生成的字节码,写一个能访问内部 API 的程序,直接调包内可见的 java.lang.reflect.ProxyGenerator.generateProxyClass(ClassLoader, String, List, int):
1 | java --add-exports java.base/java.lang.reflect=ALL-UNNAMED \ |
本文第二节的字节码来自这条路。JDK 21 与 JDK 25 生成的方法体逐条指令一致,只有常量池下标不同。
六、两条语义边界
成本之外,动态代理还有两条容易踩的语义边界,和接口规模、调用频率都无关。
目标对象内部的 this 调用绕开代理
接口两个方法,first() 内部调用 second(),走的是 this:
1 | class Impl implements Pair { |
handler 记录它看到的方法名,两个 JDK 上的输出一致:
1 | first() 返回 42,handler 看到的调用 [first] |
调用 first() 时,内部那次 second() 没有进 handler。this 是目标对象自己的引用,不经过代理,写在 handler 里的逻辑(事务、鉴权、日志)在这条路径上都不生效。这是 Java 方法调度的直接后果,谈不上缺陷,但它划定了代理的覆盖范围:跨对象边界有效,对象内部无效。
handler 里回调代理会递归
handler 里要重试,转发目标应该是被包装的对象,而不是传进来的 proxy:
1 | (proxy, method, args) -> ((Pair) proxy).second(); // 递归 |
proxy 是代理实例本身,调用它会再次进入同一个方法的 handler,没有任何终止条件:
1 | 递归调用 depth=1024 (JDK 25,默认栈深打印上限) |
结果是 StackOverflowError,打印出的 1024 层来自 JVM 的栈深打印上限(MaxJavaStackTraceDepth 默认 1024),不是真实深度。加 -XX:MaxJavaStackTraceDepth=100000 再看,递归深度是一万多层。JDK 25 三次运行都是 10746;JDK 21 每次都不一样,六次运行落在 10302 到 15808 之间。传进 handler 的第一个参数是代理实例,用途是区分同一个 handler 服务的不同代理;拿它去转发,就是自己调自己。
七、JDK 源码里的两段
缓存在哪
JDK 25 Proxy.java:299-300:
1 | private static final ClassLoaderValue<Constructor<?>> proxyCache = |
getProxyConstructor 先按接口数分流,单接口走一条快路径(Proxy.java:382-392):
1 | private static Constructor<?> getProxyConstructor(ClassLoader loader, |
未命中时走到 defineProxyClass,起名、生成字节码、定义类(Proxy.java:469-473):
1 | byte[] proxyClassFile = ProxyGenerator.generateProxyClass(loader, proxyName, interfaces, |
JDK 25 里生成的代理类是普通类:isHidden() 返回 false,Proxy.isProxyClass() 返回 true,修饰符是 public final,类所在模块是动态模块 jdk.proxy1(named=true,包已导出)。按名字查这个类能否成功,取决于谁来查:用定义它的加载器 Class.forName(name, false, loader) 拿到同一个 Class,换一个看不到它的加载器按名字找就是 ClassNotFoundException。类名里的序号全局递增,同一个加载器上每定义一组新接口就加一,跨加载器的第二个接口组会落到 jdk.proxy2.$Proxy1 这样的名字上。
公开的 getProxyClass 已经标了 @Deprecated(Proxy.java:361),理由是命名模块把代理类封装起来,外部代码拿不到(JDK 9 起)。newProxyInstance 是入口。
方法体里的数组是谁写的
每次调用都要建参数数组,ProxyGenerator 负责拼这段字节码。JDK 25 ProxyGenerator.java:689-697:
1 | cob.aload(cob.receiverSlot()) |
没有参数的方法走另一个分支,传 null 而不是空数组(ProxyGenerator.java:705 的 cob.aconst_null())。装箱归 codeWrapArgument(ProxyGenerator.java:742-747):基本类型查 PrimitiveTypeInfo,再调 Long.valueOf 这类包装方法。
同一段代码还负责生成静态初始化里的 getMethod 调用(ProxyGenerator.java:775-793):
1 | private void codeFieldInitialization(CodeBuilder cob) { |
一个方法一次 Class.forName 加一次 getMethod。接口方法越多,类初始化越慢,这笔开销只在第一次创建实例时付。
八、结论
什么时候用
代理把「谁在调用、能不能调用、调用去哪」和「被调用的逻辑」分开。下面几类场景适合动态代理:
跨接口的横切关注点,比如给 12 个接口的实现统一加事务、日志、鉴权。手写要 12 个类,动态代理要一个 handler,代价是每次调用多花约 10 纳秒,外加按签名算的 24 到 48 字节分配。
被代理的对象在运行时才确定,或者需要延迟创建。远程调用、懒加载、访问控制都属于这一类,代理自己掌握目标对象的生命周期。
调用频率不高,但覆盖面要广。管理端接口、定时任务、RPC 客户端这类场景,单次调用的纳秒数无所谓,代码里少掉 12 个样板类才是收益。
什么时候不用
调用出现在热路径里,每次几纳秒的预算。10.6 纳秒是地板值的 31 倍,每次还要多分配 48 字节,1 亿次调用就是 4.8 GB 的分配和一次可观测的 GC 压力。
只有一两个类、一两个方法要加行为。直接写一个类,或者用一个 Function 包一层,比引入 Proxy 便宜。
需要按名字或按签名精确控制生成的代码。JDK 动态代理只能代理接口,生成的类固定 extends Proxy,Object 的方法也一并走 handler。要代理实现类、要更细的控制,换字节码生成库。
指望对象内部的方法互调也被拦住。第六节验过,this 调用不经过代理,横切逻辑在这条路径上静默失效。
另外两条路
JDK 动态代理之外还有两个方向。一是生成子类:运行时写一个继承目标类的类,覆盖要拦截的方法,代价是要求目标类的方法可覆写、构造函数可调用,收益是能代理没有接口的类型。二是 MethodHandle 或 LambdaMetafactory 在编译期或启动期把调用点固化,省掉反射与参数数组,代价是每个方法都要单独构造句柄,接口一多,启动期的准备工作就变重。三条路的取舍点相同:拦截的宽度、单次调用的开销、启动期的准备成本,三者之间换。
一条判断顺序
先数接口和关注点:只有一个类要包,手写。再数调用频率:热路径上的每秒百万次调用,先量再决定。然后看 handler 里的反射:把 Method.invoke 换成 MethodHandle 能拿回 45% 到 53% 的 CPU,拿不回那 48 字节。类生成放在最后:它是一次性的,有缓存,接口方法数是主要变量,不值得为它优化。
总结
- 动态代理的调用成本集中在反射。单次 9.12(JDK 21)与 10.63(JDK 25)纳秒,其中转发层约 0,代理壳 1.5 到 2.4 纳秒,剩下的全在
Method.invoke。 - 每次调用的分配随签名变化:
long calc(long)是 48 字节(24 字节的参数数组加 24 字节的Long装箱),无参数的long now()是 24 字节,void ping()是 0;值落在Long缓存(-128..127)里时装箱那一笔也消失。换成MethodHandle处理器能省 45% 到 53% 的 CPU,省不掉这 48 字节,数组与装箱由InvocationHandler的签名与生成的方法体决定。 - 类生成是一次性成本,缓存键是「类加载器 + 接口列表」,缓存存在加载器对象上,加载器回收时一起消失。同一个加载器重复请求同一组接口拿到同一个类,换加载器就重新生成。
- dump 开关
-Djdk.proxy.ProxyGenerator.saveGeneratedFiles=true在 JDK 21 上正常,在 JDK 25 上会把生成的字节数组置空(ProxyGenerator.java:225),代理创建以NullPointerException结束(System.java:2046)。要 dump 就用--add-exports直接调ProxyGenerator。
参考资料
- Proxy (Java SE 25)
- InvocationHandler (Java SE 25)
- MethodHandle (Java SE 25)
- MethodHandles.Lookup (Java SE 25)
- Proxy (Java SE 21)
- ThreadMXBean.getThreadAllocatedBytes (Java SE 25)
系列索引:设计模式系列