设计模式——被语言吃掉的那些模式
GoF 那本书写于 1994 年,示例语言是 C++ 与 Smalltalk。Java 要到 1995 年才发布,lambda 要等到 2014 年。
23 种模式里有一部分在补语言的窟窿:用接口加实现类代替一等函数,用抽象方法代替传入函数,用两次分派代替模式匹配,用建造者代替命名参数。
这篇文章把其中六组摆在一起对照,并且跑三组实验:Visitor、Strategy、Template Method,在 JDK 21.0.8 与 JDK 25 上各测一遍。
数据里有个反直觉的结果——写得短的那个版本在两个 JDK 上都没有更快,Visitor 那一组甚至慢了 17.8%。测量方法与环境写在第一节末尾。
1994 年缺的那些东西
GoF 的示例用 C++ 写成,Smalltalk 补充。当时的语言没有这些东西:
- 一等函数(Java 8,JSR 335 引入 lambda 与方法引用)
- 语言的 for-each(Java 5 才有,靠
Iterable支撑) - record(JEP 395,JDK 16 转正)
- sealed 继承层次(JEP 409,JDK 17 转正)
- switch 上的模式匹配与记录解构(JEP 440、JEP 441,JDK 21 转正)
- 命名参数与默认参数(到 JDK 25 仍然没有)
一个模式是不是在补窟窿,可以问三个问题。
第一个问题:这个模式的参与者,是不是某个语言特性的替身?
Strategy 里的实现类,是”函数不能当值”的替身。Template Method 里的抽象方法,是”函数不能当参数传”的替身。Visitor 里的 accept / visit 两次分派,是”没有模式匹配”的替身。Builder 里的建造者对象,是”没有命名参数”的替身。替身一旦被语言本身接走,模式的这一部分就变薄了。
第二个问题:模式在管什么?
只补语法的模式会变薄;管边界(跨进程、跨库、跨版本)、管顺序(多个处理的叠加次序)、管生命周期(谁创建、谁持有、谁释放)的模式不会,因为这些东西不在类型系统里。
第三个问题:换掉之后,编译期检查是变多还是变少?
把 Strategy 换成 lambda,检查没变少;把 Visitor 换成 sealed 加 switch,多了一条穷尽性检查:漏掉一种节点就编译不过。
    graph LR
    subgraph A[语法可替 语言已经给了更短的写法]
        V[Visitor 双分派]
        S[Strategy 策略]
        C[Command 命令]
        T[Template Method 模板方法]
        I[Iterator 迭代器]
        F[Abstract Factory 抽象工厂]
    end
    subgraph B[半可替 只覆盖了读 没覆盖写]
        B1[Builder 建造者]
    end
    subgraph C2[管边界 留下]
        AD[Adapter 适配器]
        DE[Decorator 装饰器]
        PR[Proxy 代理]
        OB[Observer 观察者]
    end
后面六节都是同一套顺序:老写法的最小代码、新写法、实测、什么时候仍然用老写法。文中行数的统计口径是”非空行数,含 import 与 main“,对象是每一组的两个最小对照文件,都能编译执行。
Visitor:最该被吃掉的一个,实测却更慢
Visitor 是 23 种模式里最像补丁的一个:它的全部结构就是”绕开没有模式匹配的语法”。
老写法:两个接口换一次类型判断
表达式求值的最小例子。节点层次是 Lit(字面量)、Add、Neg,操作是求值。
1 | import java.util.List; |
33 行。两个接口:Node 提供 accept,Visitor 每种节点一个 visit 方法。新增一种操作只要加一个 Visitor 实现;新增一种节点要改所有 Visitor,编译器不会提醒漏改,这是 Visitor 最常被诟病的点。
EVAL 写成 static final 是刻意的,能不能复用访问者决定了它每秒分配几百万个对象还是零分配。
新写法:一个 sealed 层次加一个 switch
1 | public class VisitorNew { |
21 行,少了 36%。sealed 把”一共有哪几种节点”写进类型系统,switch 消费这个封闭集合时,编译器检查穷尽性:少写一个 case,或者 sealed 接口新增一个 permit,都是编译错误而不是运行期的 MatchException。
Lit(int v) 是记录模式(JEP 440,JDK 21 转正),它在同一个 case 里完成类型判断和字段提取。
两个版本都编译运行
1 | $ javac -d out VisitorOld.java VisitorNew.java |
1 | Add.accept(v) -> Eval.visitAdd(add) -> add.l().accept(v) -> ... |
这两次跳转是”双分派”的由来:第一次分派选中 Add.accept,第二次选中 Eval.visitAdd。操作与节点各自都能独立扩展,代价是每个节点走两次动态分派;sealed 加 switch 把这两次分派换成一次类型测试。
实测:两个 JDK 上更慢的都是新写法
探针构造一棵 755 个节点的表达式树反复求值,getThreadAllocatedBytes 记录每次求值的分配量。
环境与方法:Apple M1 Pro(10 核)、macOS、JDK 21.0.8 与 JDK 25(build 25+37-LTS-3491)。没有 JMH,是一次性手写探针:每个配置一个全新 JVM,5 轮预热,7 轮测量取中位数,两遍独立重复。
| 写法 | JDK 21.0.8(ns/次求值) | JDK 25(ns/次求值) | 分配字节/次 |
|---|---|---|---|
| sealed + switch | 2380 | 2405 | 0 |
| visitor,复用实例 | 2261 | 1976 | 0 |
visitor,每轮 new |
2253 | 2000 | 16 |
两遍重复的偏差:除”每轮 new”在 JDK 25 上差 4.2% 之外,其余都在 0.1% ~ 2.1%。
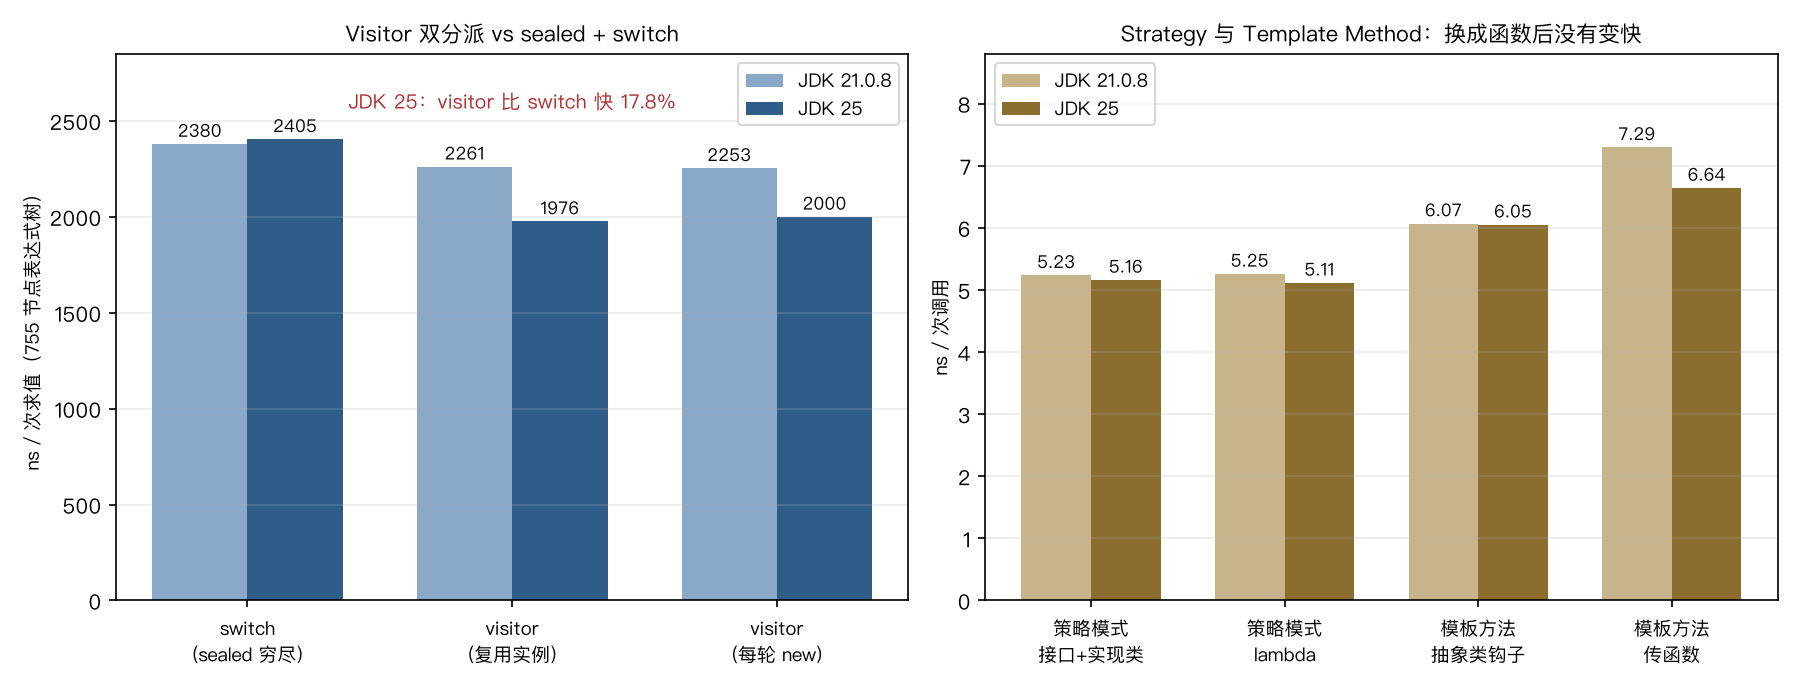
- JDK 21 上访问者快 5.0%(2261 对 2380),JDK 25 上快 17.8%(1976 对 2405)。
- switch 版本在两个 JDK 之间几乎没有变化(2380 → 2405,1.0%),访问者的路径在 JDK 25 上快了 12.6%。差值是被后者拉开的。
- “每轮 new 一个访问者”每次分配 16 字节(
getThreadAllocatedBytes记到 16.00),说明 JIT 没做标量替换;但时间代价远小于预期,JDK 25 上 1976 → 2000 ns(+1.2%,第二遍 +3.8%),JDK 21 上落在噪声里。贵的是每轮重建访问者的状态,不是那 16 字节对象头。
为什么:读字节码和内联日志
javac 为 evalSwitch 生成的代码是这样的(JDK 25,javap -p -c):
1 | static long evalSwitch(VisitorBench$Expr); |
每个节点一次 Objects.requireNonNull、一次 invokedynamic 上的 typeSwitch(SwitchBootstraps.typeSwitch,一个由 LambdaForm 实现的类型测试器)、一次 tableswitch 跳转,再加一次 checkcast。四种节点,四个分支。
访问者一侧的字节码短得多:
1 | public long accept(VisitorBench$EvalVisitor); |
访问者的 visitAdd 长这样:
1 | public long visitAdd(VisitorBench$Add); |
一个节点两次 invokeinterface(accept 的接收者是四种记录类型,visitX 只有一个实现),没有任何类型测试。理论上这更贵——接口调用要走 itable。实测相反,原因在 C2 的内联决策里。用 -XX:+PrintInlining 看两类调用点:
1 | $ java -XX:+UnlockDiagnosticVMOptions -XX:+PrintInlining -cp out25 VisitorBench visitor_reuse 2 30000 12 2>&1 | grep -E "Eval::visit(Add|Neg) \(" | grep "inline (hot)" | sort -u |
1 | $ java -XX:+UnlockDiagnosticVMOptions -XX:+PrintInlining -cp out25 VisitorBench switch 2 30000 12 2>&1 | grep -E "evalSwitch \(220 bytes\).*failed to inline" | grep -oE "failed to inline: .*" | sort -u |
profile 里的计数每次运行不同,上面是一次的原始输出。
两边的差别在调用点上:
- 访问者的
visitAdd、visitNeg被内联了,类型 profile 是 100% 单一实现(Eval是final类,visitX只有这一个实现)。accept那一侧是四个记录类型,profile 太散,C2 报failed to inline: no static binding,但至少有一半的调用点被展开。 - switch 版本的递归是
evalSwitch调自己,方法体 220 字节,C2 拒绝把大方法内联进自身,四条不同的拒绝理由都是同一个意思:220 字节的递归方法不能再摊开了。
把递归拆到两个方法上,accept 与 visit 各管一层,反而给了内联器展开的空间。这是访问者在这个形状下更快的原因。
这只解释了机器码为什么不同,不等于差值全部来自内联——那需要看 C2 的汇编输出,这一步没做。结论只对 755 节点、单线程、预热充分的这棵树成立。
什么时候仍然应该写访问者
- 操作比节点多,而且要独立扩展操作。 一个层次上挂着几十种分析(求值、打印、类型检查、常量折叠),Visitor 把每种操作收在一个类里;switch 写法会让每种操作各占一个 30 行的 switch,节点每加一种就要改几十处。
- 访问需要携带状态。 作用域栈、符号表、当前文件位置需要一个宿主对象,访问者天然是宿主,
static的 switch 函数没有地方放它们。 - 节点层次是别人给的,改不动。 处理第三方 AST 时,sealed 需要修改类型声明,Visitor 不需要。
生态里的实际例子:ElementVisitor(注解处理器)、com.sun.source.tree.TreeVisitor、ASM 的 ClassVisitor。它们的层次都开放给使用者。
Strategy 与 Command:接口加实现类换 lambda
老写法,接口加两个实现类:
1 | public class StrategyOld { |
新写法:
1 | import java.util.function.LongUnaryOperator; |
1 | $ java -cp out StrategyOld |
20 行对 12 行,少了 40%,省掉的是类声明这一层。java.util.function 有 43 个预置接口,策略只有一个方法、参数与返回值对得上现成形状时,自定义接口没有增加信息量。
实测:没有差别
1 亿次调用(100 万条订单,3 种策略轮转,100 轮):
| 写法 | JDK 21.0.8(ns/次调用) | JDK 25(ns/次调用) |
|---|---|---|
| 接口 + 实现类 | 5.233 | 5.158 |
| 函数式接口 lambda | 5.255 | 5.111 |
差值在 0.9% 以内,两遍重复之间符号还会翻转。两种写法的运行期结构相同。lambda 不是零成本语法,它编译成一个 final 类加 invokedynamic 上的 LambdaMetafactory 引导,调用点上照样是一次接口分派。换掉实现类只减少了源码字符,生成的机器码没有变化。
反过来看也一样成立:这一组里 lambda 没有变快,所以”为了性能把策略类改成 lambda”这个理由站不住。
什么时候仍然写实现类
- 策略有状态。 lambda 捕获的变量必须 effectively final,带累计计数、连接或缓冲区的策略写成对象更自然。
- 策略接口有多个方法。 一旦有
price和refund,java.util.function里找不到现成形状。 - 策略要能被框架发现,或者要出现在日志里。
List<Pricing>的注入靠类型匹配,lambda 没有类型信息可注入,toString也只是Strategy$$Lambda/0x...。
Command 是同一类问题,lambda 能替掉骨架。但它还带撤销栈、重放日志、事务边界,那些是管生命周期的部分,换写法时要另找地方放。
Template Method:语法收益最小的一组
抽象类钩子:
1 | public class TemplateOld { |
传函数:
1 | import java.util.function.LongUnaryOperator; |
1 | $ java -cp out TemplateOld |
27 行对 24 行,只省了 11%。钩子在抽象类里只占两行声明,换成 record 的两个组件,长度差不多。
实测:传函数更慢
3 千万次行处理(10 万行,3 个实现轮转,300 轮):
| 写法 | JDK 21.0.8(ns/行) | JDK 25(ns/行) |
|---|---|---|
| 抽象类钩子 | 6.066 | 6.047 |
| 传函数 | 7.293 | 6.638 |
传函数的版本慢 20.2%(JDK 21)与 9.8%(JDK 25),两遍重复偏差在 1.7% 以内,方向与 Visitor 那组一致。
字节码能解释一部分差别。抽象类的模板方法生成的是两个 invokevirtual(parse、transform);传函数的版本生成的是两个 getfield 加两个 invokeinterface(LongUnaryOperator.applyAsLong)。接口分派与类虚调用在单条指令上的开销差异我没有单独测过,两种写法都落在同一数量级(6 ns 与 7 ns),差值来源没有定位到具体一条指令。把钩子换成函数,不要指望性能。
什么时候仍然用抽象类
- 钩子超过两三个。 四个函数参数拼成的构造调用已经不好读。
- 顺序与不可覆盖性重要。
final long run(...)把调用顺序写成类型层面的契约,子类改不掉。 - 框架的扩展点。
HttpServlet.service派发到doGet/doPost、InputStream.read()、AbstractList.get/size,这些是别人继承的 API。自己用的新类没有这条约束。
Iterator:早就被语言接管的一类
Iterator 是唯一一个被语言正式接管的模式:Java 5 引入 for-each,编译器把 for (T x : iterable) 展开成 iterator() 调用加 hasNext / next 循环。模式的名字还在,手工劳动没了。
1 | import java.util.Iterator; |
1 | $ java -cp out IteratorDemo |
Stream 之后连 iterator() 都可以不写,Spliterator 还支持并行拆分。剩下的是 fail-fast 语义与资源释放,都由 JDK 实现,调用方只是消费者。
Abstract Factory:被静态工厂与 sealed 族挤掉大半
抽象工厂解决问题:整套产品族(按钮、输入框)一起切换。老写法是每种产品一个工厂方法,每个平台一个具体工厂类。现代 Java 可以压成一段 sealed 层次加一个静态工厂:
1 | public class FactoryDemo { |
1 | $ java -cp out FactoryDemo |
老写法里”一族产品”靠两个类各实现同一个工厂接口来维持;新写法里一个 case 分支组装一整套。
还有价值的部分是运行期换实现:JDK 自带 java.sql 一套接口,驱动换实现;UIManager 换 LookAndFeel。抽象工厂把”换哪一套”收在一个地方,与语法无关。产品族写死在代码里时,静态工厂加 sealed 族就够了。
Builder:缺命名参数时代的产物,而且还没等到替代品
record 覆盖了读,没覆盖写。JEP 395(JDK 16 转正)给了透明载体,模式匹配给了字段提取,”拿到数据之后怎么读”这一半解决了。写的那一半没有进展:
- 没有命名参数。
new Point(x = 1, y = 2)不是 Java。 - 没有默认参数。重载是唯一手段。
- 没有 wither。JEP 468 “Derived Record Creation” 的目标是
p with { x = 1 }这种派生创建,状态是 Candidate,没有挂到任何 JDK 版本上。它的 Non-Goals 明确写了三条:不做任意复杂表达式的 Pascal 风格with、不提供特殊的一类 wither 方法、不为非 record 值提供派生创建。
Builder 目前没有语言级替代品,它稳定的存在理由是:
- 可选参数多、必填参数少。 四个以上参数时,构造器的位置参数已经不可读。
- 构造过程需要收口校验。
build()是唯一检查点。 - 构造分步、跨调用栈完成。 分页查询、HTTP 请求、SQL 拼装的参数在不同层里逐步补齐,命名参数也解决不了。
三四个参数、没有可选值、校验简单的值对象,直接写 record 的规范构造器就够了。
没有被吃掉的那一类
Adapter:边界在,适配器就在
适配器出现在两侧接口都不由你决定的地方:一边是第三方库、老系统、外部协议。语言没有语法能把 A.f() 变成 B.g(),因为对面那个签名改不了。JDK 里的例子:Arrays.asList、InputStreamReader。
两侧接口都由你控制时不要写适配器,直接改接口。写适配器的成本,都花在改不动的那一侧。
Decorator:管的是叠加顺序
装饰器最接近语言特性,函数组合(Function.andThen)看着能替,差别有三条:装饰后的对象仍是同一个接口类型,能放回原位置继续被装饰;装饰器能给接口里每个方法都加行为,函数组合只有一个调用点;顺序有语义——new BufferedInputStream(new GZIPInputStream(in)) 反过来写就是另一个程序。JDK 自己在用:Collections.unmodifiableList、Collections.synchronizedList、整个 java.io 流体系。
Proxy:管的是替代者与被替代者的关系
代理和装饰器长得像,意图不同。装饰器增强行为,代理决定”这次调用要不要真的落到目标上”,同时管生命周期:延迟创建、连接释放、权限判定、跨进程转发。Hibernate 的懒加载实体、Spring 的事务代理、RMI 的 stub 都是代理。只为了”日志再包一层”就用代理,不如用装饰器——那层间接性买不到东西。
Observer:管的是解耦与订阅生命周期
观察者换来的是”发布者不认识订阅者”这层解耦。这个解耦带来两个必须处理的问题:回调发生在哪个线程,订阅关系谁负责解除。内存泄漏多数来自后者。JDK 的老实现 java.util.Observable 在 Java 9 被标记为废弃,官方推荐的替代是 Flow API(JEP 266,JDK 9 转正)。进程内的一次性通知不需要观察者,直接调用或 CompletableFuture 都行。
这四个的共同点是:它们处理边界在哪、层次按什么顺序叠、目标由谁创建与释放。类型系统看不见这些,语法替代不了。
判断标准
三条判据
替身判据。 把模式的参与者列出来,逐个问:它是不是某个语言特性的替身?实现类替一等函数,抽象方法替函数参数,accept/visit 替模式匹配,建造者替命名参数。
位置判据。 模式处理的是”类型之间的关系”还是”运行期的时序与资源”。前者可以被语法替代;后者不行,因为类型系统看不见线程、顺序、连接和引用计数。
检查判据。 换写法之后编译期能抓到的错误是变多还是变少。sealed 加 switch 让穷尽性成了编译错误;接口加实现类换成 lambda,检查强度不变。
    flowchart TD
    A[准备引入一个模式] --> B{参与者是不是语言特性的替身}
    B -->|都是替身| C{删掉替身后还剩什么}
    B -->|不都是| D{它在管边界 顺序 生命周期吗}
    C -->|什么都不剩| E[直接用语言特性 删掉模式]
    C -->|剩下状态或资源| D
    D -->|是| F[保留 类型系统看不见这些东西]
    D -->|否| G[这个模式可以删掉了]
不要用”短”当判据
三组实测摆在一起:Visitor 那组行数少 36%,耗时多 17.8%;Strategy 那组行数少 40%,耗时在 0.4% 以内;Template 那组行数少 11%,耗时多 9.8%。
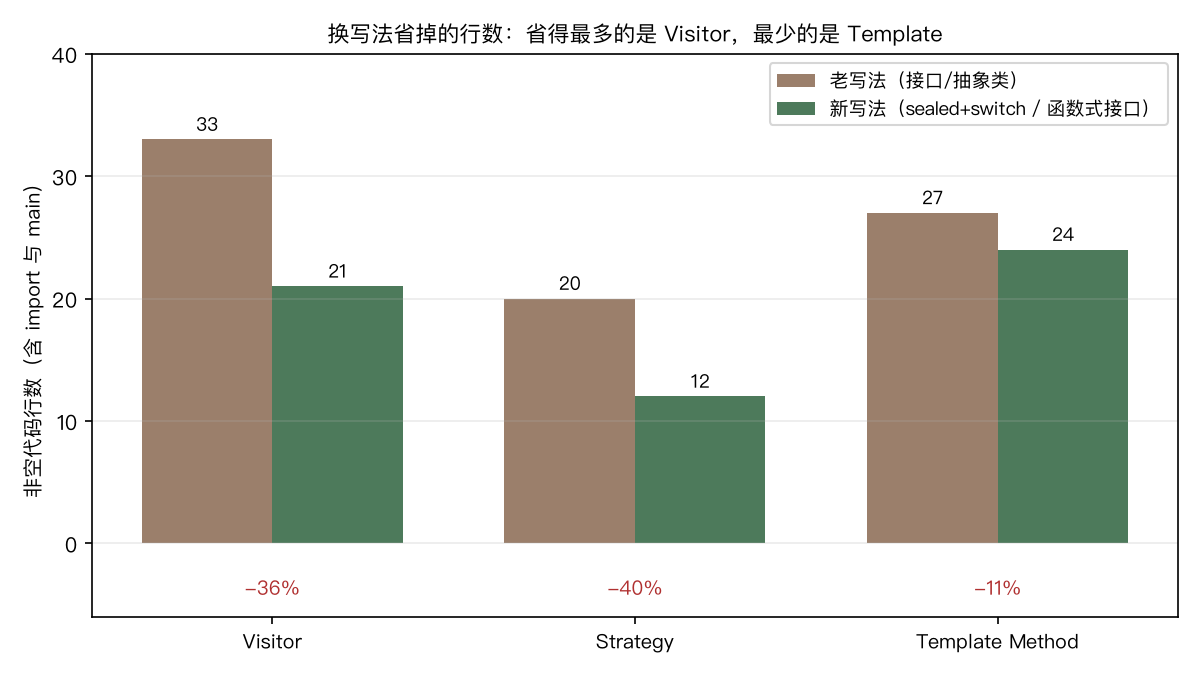
行数变化与性能变化对不上:减得最多的 Strategy(40%)耗时没动,减了 36% 的 Visitor 慢了 17.8%,只减 11% 的 Template 也慢了 9.8%。决定性能的是调用点看到几个实现、能不能被内联、有没有反复的类型测试,与源码行数无关。换写法是可读性与检查强度上的交易,把它当性能优化做,就会在错误的地方换错东西。
微基准的局限
- 只有一台机器:Apple M1 Pro、10 核、macOS,没有换硬件验证。
- 没有 JMH。手写探针用
System.nanoTime包住循环,做了预热与 7 轮取中位数,但缺少 JMH 的死代码消除防护、Blackhole 与@Fork隔离。量级可信,小数点后两位不可信。 - 三组都是”同一份数据反复处理”的合成负载。真实系统的瓶颈多半在内存分配、IO 与锁上,这一层的 ns 级差异通常看不见。涉及分配的那组用
getThreadAllocatedBytes计数,它只说明分配发生了。
结论只在量级上成立:把策略接口换成 lambda 不会更快,把访问者换成模式匹配也不会更快,差别在几纳秒以内,除非热路径本身就是几十纳秒级的纯计算。
总结
- 判据有三个:参与者是不是语言特性的替身、它在管类型关系还是运行期时序、换掉之后编译期检查是变多还是变少。
- Visitor 最像补丁,实测里却最快:JDK 21 上比 sealed + switch 快 5.0%,JDK 25 上快 17.8%。
accept/visit把递归拆成两个方法后visitX是单态调用点,能被内联;递归的evalSwitch有 220 字节,C2 明确拒绝内联进自身。 - Strategy 与 Command 被函数式接口接管,1 亿次调用上的差别在 0.9% 以内且符号会在两遍之间翻转,换 lambda 省的是类声明。Template Method 语法收益最小(27 行对 24 行),代价是慢 9.8%(JDK 25)与 20.2%(JDK 21)。
- Iterator 被语言正式接管;Abstract Factory 只剩运行期换实现的价值;Builder 因为命名参数、默认参数、wither(JEP 468 仍是 Candidate)全都缺位,还没有替代品。
- Adapter、Decorator、Proxy、Observer 留下,因为价值在边界、顺序、生命周期。
参考资料
- JEP 395: Records
- JEP 409: Sealed Classes
- JEP 440: Record Patterns
- JEP 441: Pattern Matching for switch
- JEP 468: Derived Record Creation (Preview)
- JEP 266: More Concurrency Updates
- Java SE 25 API: java.lang.runtime.SwitchBootstraps
- Java SE 25 API: java.util.function.LongUnaryOperator
- Java SE 25 API: java.util.Observable(已废弃)
系列索引:设计模式系列