设计模式——解释器:解释还是编译
解释器模式把一门语言的求值写成对象树上的递归。
同一棵树可以在构建期换成闭包树,每个节点变成一个捕获了子闭包的函数。
两种形态的求值都是每个节点一次调用,差别落在调用点能不能被 JIT 静态化。
用 27 节点和 7 节点两个表达式、各 100 万次求值,可以把这句话量出来。
一、两个求值器
四则运算的最小文法:数字、变量、加减乘除。节点是一组 record,求值是节点自己的方法:
1 | sealed interface Node { double eval(double[] v); } |
递归下降解析器把 (a + b * c - d / (e + 1.75)) * (f - g * (h + 2.25) / (i + 0.5)) + j * k 变成 27 个节点、深度 7 的树。
第二种实现不动这棵树,换一个求值出口。构建期把树走一遍,生成一棵闭包树:
1 | interface Fn { double apply(double[] v); } |
compile 递归一次,每个节点产出一个闭包,闭包捕获子闭包。27 个节点得到 27 个 lambda 实例,深度还是 7,语义逐位相同。
    graph TD
    SRC["(a + b * c - d / (e + 1.75)) * (f - g * (h + 2.25) / (i + 0.5)) + j * k"] --> P["递归下降解析"]
    P --> AST["语法树:27 个 record 对象,深度 7"]
    AST -->|"解释:节点自带 eval"| E1["求值:node.eval(v)"]
    AST -->|"编译:compile(node) 一次遍历"| CT["闭包树:27 个 lambda 实例"]
    CT --> E2["求值:f.apply(v)"]
    E1 --> R1["实测 34.4 ns / 次(JDK 21)"]
    E2 --> R2["实测 34.1 ns / 次(JDK 21)"]
两次求值的调用形式一样,node.eval(v) 和 f.apply(v) 都是一次接口调用,每个节点各一次。差别在调用点看到的类型数量:语法树上,父节点里的 l.eval(v) 会收到全部 6 种节点类型;闭包树上,l.apply(v) 里的 l 由源码里某一个 lambda 表达式生成,所有实例来自同一个类。这个差别能不能变成耗时差,取决于 JIT 怎么处理它。
另加两组对照。一组是第三种求值形态:语法树不动,把 eval 换成外部的 switch 分派(case Add x -> evalSwitch(l, v) + evalSwitch(r, v)),四种实现共用同一棵树。另一组是手写的直线算式,代表「把树消灭掉」的上限,用来标定这棵树本来值多少纳秒。
二、实验设计
- 机器:Apple M1 Pro,macOS Darwin 25.6.0,arm64
- JDK:
21.0.8+12-LTS-250与25+37-LTS-3491 - 字节码用 JDK 21 编译一次,同一个 class 目录在两个 JVM 上跑,避免 javac 差异混进结果
- 每个实现预热 30 万次,然后 5 轮交错计时,每轮 100 万次求值,取中位数;4 个实现的轮次交替,避免某一段 CPU 状态只影响其中一个
- 计时只在同一个进程的一个线程里进行,全程持有跨进程的全局锁,避免同一台机器上其它基准进程抢 CPU
- 分配量用
com.sun.management.ThreadMXBean.getThreadAllocatedBytes(threadId),在一个新线程里先预热再计数 100 万次 - 输入取自 1024 组预生成的变量数组,每次求值换一组,JIT 无法把结果当常量折叠掉
- 同一套循环代码在不同会话里测出的绝对水平会漂:同一份代码在两次运行里分别得到 27.31 ns 和 34.38 ns(JDK 21,语法树),差 26%。所有比较都取同一次会话内的数据,结论只看方向和倍数
一次求值 27 个节点、几十纳秒,绝对值受 CPU 频率和编译器版本影响;这些数字只用来判断量级和相对关系,不当作硬件上限。
三、实测一:两个表达式的四种求值形态
| 实现 | 27 节点 JDK 21 | 27 节点 JDK 25 | 7 节点 JDK 21 | 7 节点 JDK 25 |
|---|---|---|---|---|
语法树 + 虚方法 eval |
34.38 ns | 32.60 ns | 9.58 ns | 9.17 ns |
语法树 + 外部 switch |
84.43 ns | 81.12 ns | 16.89 ns | 17.85 ns |
| 构建期编译成闭包树 | 34.09 ns | 32.50 ns | 9.47 ns | 9.16 ns |
| 手写直线算式 | 1.81 ns | 1.75 ns | 0.99 ns | 0.97 ns |
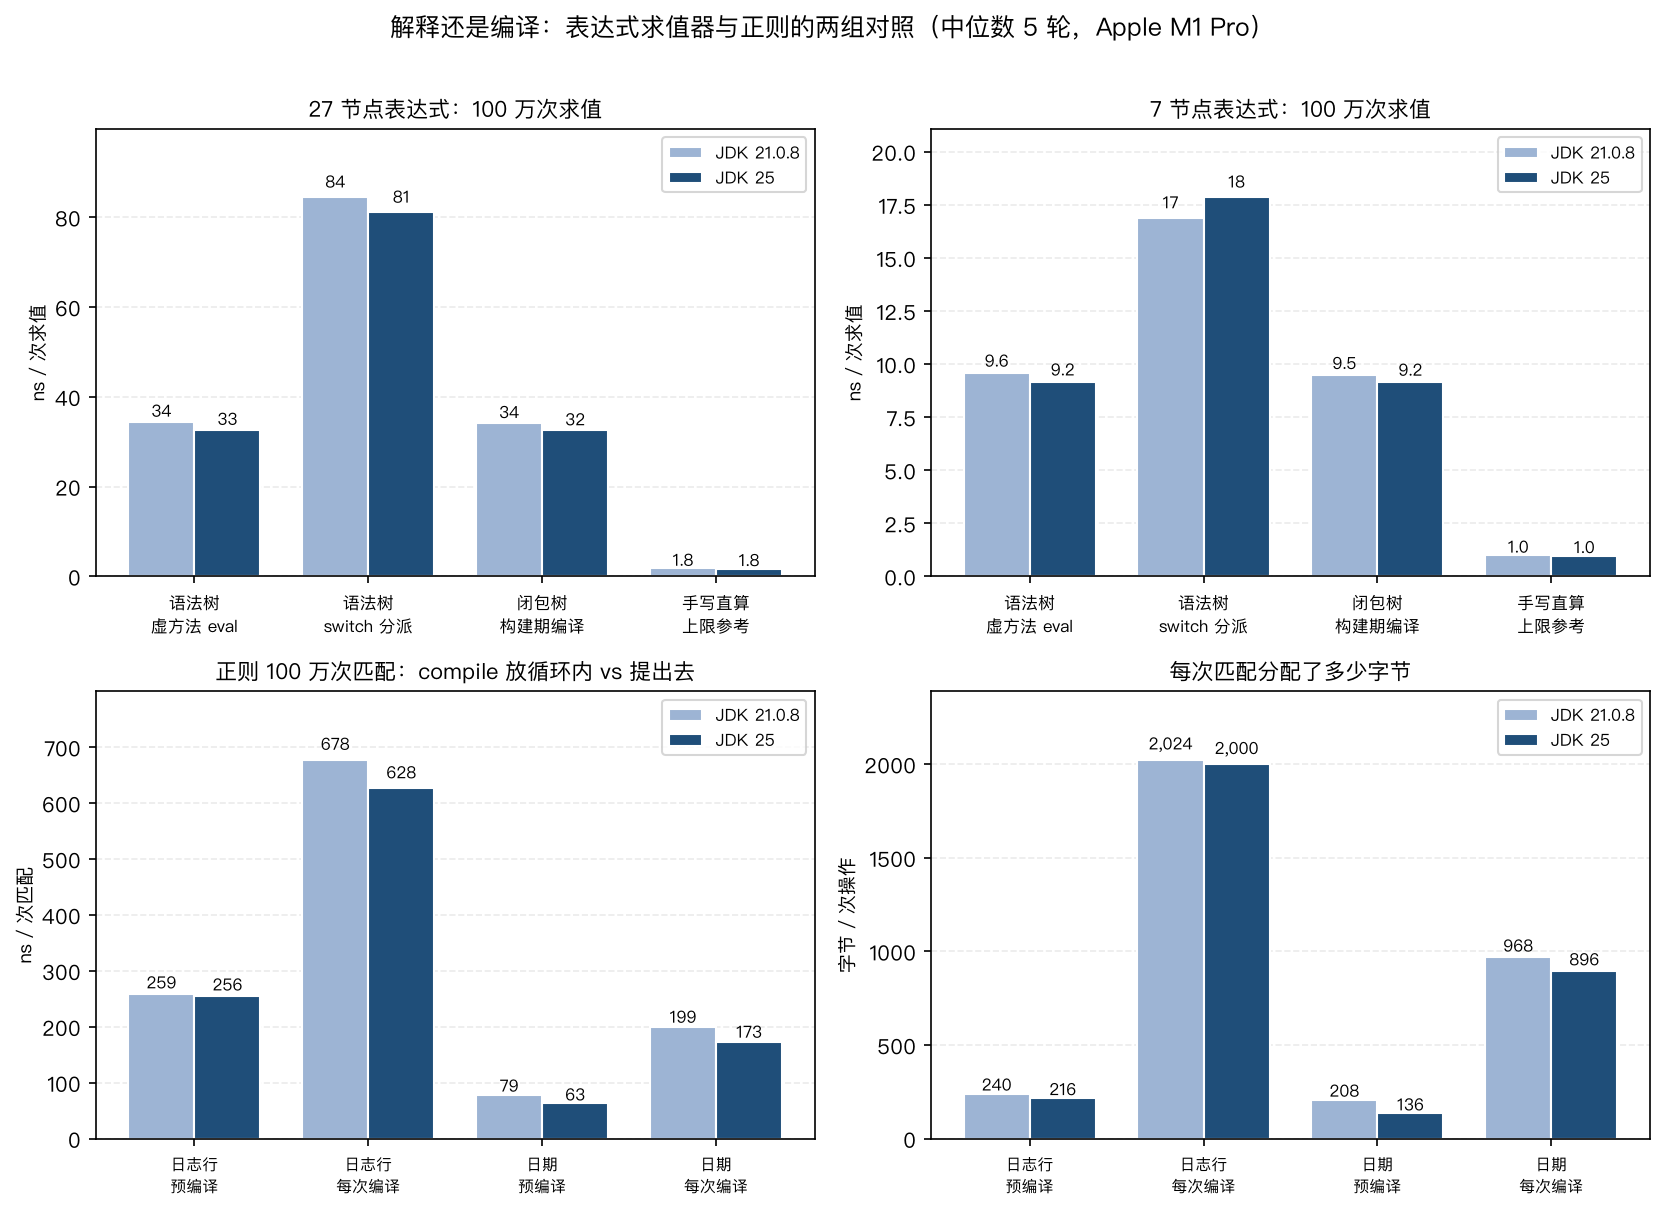
27 节点这棵树上的结果:闭包树 34.09 ns,语法树 34.38 ns(JDK 21),32.50 ns 对 32.60 ns(JDK 25)。差距都在 1% 以内。构建期编译成闭包没有换到速度。
7 节点的小树上两个数再次贴在一起:9.47 ns 对 9.58 ns(JDK 21),9.16 ns 对 9.17 ns(JDK 25)。树小了四分之三,差距没有变大。
两个尺寸放在一起,每次求值的耗时可以拟合成一条直线(两点拟合,只用来说明构成):JDK 21 上固定开销约 0.9 ns、每个节点约 1.24 ns,JDK 25 上约 1.0 ns 和 1.17 ns。7 个节点和 27 个节点、两种形态,都落在这条线附近。代价由节点数量和每节点一次分派决定,树的形态没有改变它。
四种实现的分配量都是 0 字节/次,两个 JDK 一致。闭包树在构建期分配 27 个对象,之后每次求值不再分配;语法树求值是一次纯算术过程,没有装箱和临时对象。这次对比里的解释器代价不含分配,全部是调用和分派。
switch 分派慢 2.5 倍:84.43 ns 对 34.38 ns。同一棵树、同样 27 次分派,形态一换价格就变了;7 节点树上这个倍数收窄到 1.8 倍。
构建成本
| 阶段 | JDK 21 | JDK 25 |
|---|---|---|
| 解析字符串成语法树 | 1845 ns / 次 | 1989 ns / 次 |
| 语法树编译成闭包树 | 172 ns / 棵 | 169 ns / 棵 |
| 单次求值(闭包树) | 34.09 ns | 32.50 ns |
解析是构建成本的大头,比一次求值贵约 54 倍;把已有的语法树编译成闭包树只要 172 ns,约等于 5 次求值。如果同一棵树要执行 5 次以上,编译成闭包的成本早就收回来了。前提是编译能换来加速,这个例子里的答案是「不能」。
四、内联日志:打平发生在哪一层
-XX:+UnlockDiagnosticVMOptions -XX:+PrintInlining 在 JDK 21 上编 loopClosure(闭包求值的 100 万次循环)时,输出是这样一棵树(inlining21.txt:2165-2178,省略号是原输出里的十六进制后缀):
1 | 330 391 % 4 Bench::loopClosure @ 5 (38 bytes) |
C2 顺着闭包树往下内联了三层,停在 Bench$Fn::apply ... virtual call 上,这些接口调用没有进内联。同一份日志里,语法树是同一幅画面(inlining21.txt:1931-1942):
1 | 206 387 % 4 Bench::loopAst @ 5 (38 bytes) |
语法树的处境和闭包树一样。父节点里的 l.eval(v) 静态地看有 6 种可能,落到某个节点的具体子位置只剩一到两种类型(Bench$Mul 8185 次、Bench$Var 33766 次),C2 对这两种都做了去虚拟化和内联;再往下一层又出现 Bench$Node::eval ... virtual call,位置和闭包树停手的那一层对应。
C2 把两种形态都内联了一部分,都在若干层之后停手,剩下的都是每节点一次动态调用。 闭包树把调用点从「6 选 1 的虚调用」换成「单态接口调用」,而类型 profile 早就把语法树的子位置收窄到一到两种类型,这个差别没有落到代码上。
两个 JDK 自报的默认值解释了这些拒绝从哪里来(-XX:+PrintFlagsFinal,两个版本取值相同):
| 参数 | 值 | 作用 |
|---|---|---|
TypeProfileWidth |
2 | 每个调用点记两种接收者类型。闭包调用点只有 1 种,语法树的子位置也常常只有 1 到 2 种,两边都能去虚拟化 |
MaxInlineLevel |
15 | 内联嵌套深度上限。放宽到 30 之后耗时和拒绝条数都没有变化(见下一小节) |
MaxRecursiveInlineLevel |
1 | 递归调用最多展开一层,对应日志里的 recursive inlining is too deep |
FreqInlineSize |
325 | 热点方法参与内联的体积上限,按字节码大小算 |
InlineSmallCode |
2500 | 已经编译成机器码的方法参与内联时的代码体积上限 |
这五个默认值对上日志里的现象:TypeProfileWidth=2 收得下语法树的子位置,去虚拟化照常发生;深度与体积上限拦住的调用点,两种形态是同一批。编译成闭包没有带来新的优化机会。
7 节点的小树上,两边同样是内联到一半停手,剩下的每节点一次调用没有消失,账还是平。分界线落在「编译有没有把节点消灭掉」上:手写直算没有节点,7 节点 0.99 ns、27 节点 1.81 ns。
把内联预算提高一倍
如果闭包树的零收益只是被内联深度截断的结果,把上限翻倍应该能把差距放出来。用 -XX:MaxInlineLevel=30 重跑同一套实验(同样 5 轮中位数、同样的输入池、同一个 class 目录):
| 形态 | 27 节点,默认上限 | 27 节点,上限 30 | 7 节点,默认上限 | 7 节点,上限 30 |
|---|---|---|---|---|
语法树 + 虚方法 eval |
34.38 / 32.60 | 34.94 / 33.23 | 9.58 / 9.17 | 9.41 / 9.06 |
| 构建期编译成闭包树 | 34.09 / 32.50 | 34.14 / 32.88 | 9.47 / 9.16 | 9.33 / 9.13 |
(每格是 JDK 21 / JDK 25 的 ns/次求值。)
四个格子对四个格子,差异都在 3% 以内。JDK 21 的两份内联日志里,recursive inlining is too deep 都出现 8 次、already compiled into a big method 都出现 10 次、inlining too deep 都出现 4 次。上限翻倍既没有改变耗时,也没有改变拒绝条数;拦住两种形态的是同一批调用点和体积判断,深度这条线不是分界。
switch 版本慢在别处。evalSwitch 是 206 字节的方法,递归自调用在日志里被判 callee is too large(JDK 21 的日志里出现 510 次),一次都没内联;每次分派还要过 invokedynamic 的 typeSwitch 引导代码,日志里跟着一串 LambdaForm$MH::linkToTargetMethod、checkIndex 之类的强制内联方法。27 个节点各付一份,就是那 50 纳秒的差额。
五、实测二:正则,同一件事的日常版本
Pattern.compile 的每次调用开销,和「同一棵树反复解释」是同一个问题。两个正则,各匹配 100 万次:
log-line:^(\d{2}):(\d{2}):(\d{2}) \[(\w+)\] (\d{1,3}(?:\.\d{1,3}){3}) (.*)$,7 个捕获组,跑在 1024 条日志行上date:^\d{4}-\d{2}-\d{2}$,无捕获组,跑在 1024 个日期串上
| 写法 | JDK 21 每次 | JDK 25 每次 | JDK 21 分配 | JDK 25 分配 |
|---|---|---|---|---|
log-line 预编译,复用 Pattern |
259 ns | 256 ns | 240 B | 216 B |
log-line 每次 Pattern.compile |
678 ns | 628 ns | 2024 B | 2000 B |
date 预编译,复用 Pattern |
79 ns | 63 ns | 208 B | 136 B |
date 每次 Pattern.compile |
199 ns | 173 ns | 968 B | 896 B |
预编译之后每次匹配还要 259 ns,因为 matcher() 每次新建一个 Matcher 并分配它需要的数组。把 Pattern.compile 提出循环省下的是编译部分:log-line 上每次 418 ns、1.8 KB,date 上每次 121 ns、0.8 KB。两个 JDK 上倍数都落在 2.4 到 2.8 之间,分配量降到原来的四分之一到九分之一。
把编译移出循环是一次没有代价的优化:耗时差 2.5 倍,每次操作的分配量降到原来的四分之一到九分之一。 倍数没有大到几百倍,因为匹配也要时间;多出来的开销集中在分配和解析上。
JDK 源码里的证据
Pattern.compile(String) 不带任何缓存:
1 | // java.base/java/util/regex/Pattern.java:1101-1103(JDK 25) |
JDK 21 的同一行在 :1100,代码相同。构造函数里就直接编译,没有推迟到第一次匹配:
1 | // java.base/java/util/regex/Pattern.java:1575-1580(JDK 25) |
这个 compile() 实例方法的 javadoc 写着它干什么:
1 | // java.base/java/util/regex/Pattern.java:1901-1905(JDK 25) |
解析出来的是一棵 Node 树(Pattern.java:2239 的 expr()、:2417 的 atom() 这些递归方法建的),匹配时 Matcher 解释这棵树。源码里的注释把这个结构说得很直白:
1 | // java.base/java/util/regex/Pattern.java:3711-3716(JDK 25) |
1 | // java.base/java/util/regex/Pattern.java:3719-3724(JDK 25) |
Pattern.java 里有 35 个类直接 extends Node(grep -c "extends Node" 的计数),每个节点类型自己实现 match()。求值入口在 Matcher 里是一个方法的一行:
1 | // java.base/java/util/regex/Matcher.java:1792(JDK 25,方法为 match(int from, int anchor)) |
节点自带求值方法、从根节点开始递归解释,这是解释器模式的教科书形态,出现在 JDK 的正则引擎里,只是没有用这个模式名。
Pattern.matches 这个便捷方法每次都走一遍完整流程,javadoc 自己写着别这么用:
1 | // java.base/java/util/regex/Pattern.java:1208-1209(JDK 25) |
1 | // java.base/java/util/regex/Pattern.java:1220-1224(JDK 25) |
String.matches 是它的转调,String.java:3033-3034 一行 return Pattern.matches(regex, this);。
匹配一侧也有固定开销。matcher() 每次都新建 Matcher,构造函数分配三块状态:
1 | // java.base/java/util/regex/Matcher.java:245-252(JDK 25) |
groups 的长度由捕获组数决定,7 个捕获组就是 16 个 int。这解释了表里预编译一列仍有 136 到 240 字节的分配。
JDK 自己在能绕开编译的地方都绕了。String.split(regex) 有一条针对单字符分隔符的快速路径,注释写得很直白:
1 | // java.base/java/lang/String.java:3397-3403(JDK 25) |
满足条件的直接 split(ch, limit, ...),不碰 Pattern.compile;不满足的才走到 :3421 的 Pattern.compile(regex)。给 split("a.b") 和 split(".") 各做一次,就能看到这条路径:前者每次都要编译一遍那个点号加字母的正则。
另一个 JDK 里的解释器是 java.text.MessageFormat。它的编译产物是三个并排的数组:
1 | // java.base/java/text/MessageFormat.java:1453-1468(JDK 25) |
applyPatternImpl(:605)扫描模式串,把每段字面量的偏移、参数号、子格式化器填进这三个数组;求值是一个下标循环:
1 | // java.base/java/text/MessageFormat.java:1498-1503(JDK 25) |
这是「编译成指令数组 + 解释循环」的最老形态。MessageFormat 在构造函数里就调 applyPatternImpl(:516),所以每次调用都 new MessageFormat(pattern) 的代码,每轮都把模式串重新解析一遍,和把 Pattern.compile 放进循环是同一个错误。
DateTimeFormatter 是同一个形状,只是编译产物是打印/解析器链:
1 | // java.base/java/time/format/DateTimeFormatter.java:568-570(JDK 25) |
appendPattern 里接着调 parsePattern(DateTimeFormatterBuilder.java:1906-1911)逐个字符扫描模式串,把它变成一串打印器和解析器对象。把 ofPattern 写进循环的代码,每轮都在重做这件事。这一类「工厂方法里藏了一次编译」的 JDK API 至少还有 NumberFormat.getInstance(构造数字格式化器)、DateTimeFormatter.ofLocalizedDate(构建本地化器链)。
六、判据:什么时候解释,什么时候编译
    graph TD
    Q1{"同一表达式 / 规则<br/>要执行几次"} -->|一次| A1["别编译:解析成本 1845 ns<br/>单次求值 34 ns,收不回来"]
    Q1 -->|多次| Q2{"编译产物改变了什么"}
    Q2 -->|"只换了分派形态<br/>(闭包树、类型对象)"| A2["先量。本测里 27 节点树<br/>34.09 vs 34.38 ns,测不出来"]
    Q2 -->|"消灭了结构<br/>(常量折叠、直线代码、单态内联)"| A3["编译:手写直算是同一棵树的 1.81 ns"]
    Q2 -->|"规则会在运行中变化"| A4["解释,或编译后做缓存失效"]
三个出口展开:
只执行一次的表达式不要编译。 解析字符串要 1845 ns(JDK 21)到 1989 ns(JDK 25),单次求值 34 ns,比值 54 倍。一次性的表达式,连 Pattern.compile 都不该调第二次。
编译产物只换了分派形态时,先量再信。 闭包树在 27 节点上的收益是 0,因为 JIT 早就用类型 profile 把两种形态都内联到同一个位置。要让编译值得做,产物必须带来 JIT 做不到的东西:把常量折进去、把中间结果放进局部变量、生成一段直线代码。手写直算 1.81 ns 就是那个上限,其余 32.6 ns 全是遍历和分派的成本。
规则会变时,解释是默认选择。 正则引擎选择了 Node 树加回溯,MessageFormat 选择了解释循环。原因是同一段代码要接受任意模式,编译产物必须按模式重建;而模式的生命周期通常和一次 Matcher 或者一次格式化调用一样短。
判断顺序落到写代码上:
- 先数执行次数。一次性的,直接解释,别建缓存。
- 执行多次,先看现成的编译设施有没有。正则、
MessageFormat、DateTimeFormatter都提到循环外,这类改动的收益是白捡的。 - 已经是复用形态之后,再考虑自己编译成闭包树,并且量它。本测里 7 节点和 27 节点的树都没测出收益,别默认换一种分派形态会更快。
- 要动分派方式的话,别选外部
switch加递归。这次测的是 84.43 ns 对 34.38 ns,慢 2.5 倍,内联日志里evalSwitch的递归自调用被判callee is too large510 次,一次都没进内联。
七、和别的模式的分界
解释器、组合、访问者都长在树上,容易混在一起用:
- 组合(组合模式)提供树的结构和递归遍历,不规定节点上跑什么。语法树就是一种组合。
- 访问者(访问者模式)把操作从节点里挪出去,给一棵稳定的树加新操作。它和解释器的区别在谁定义语言:解释器的节点类就是文法,访问者只往现成的树上挂操作集。
- 策略(策略模式)是每个节点一种算法,解释器是每个节点一种「文法角色」。闭包树那版把两者叠在一起,每个节点是一个策略对象,执行由组合结构决定。
- 享元(享元模式)用在终结符上。大量表达式共用的数字和变量名节点可以共享,但本测里的分配大头在解析(1845 ns 里的大部分是
new),不在节点数量。
解释器买到的东西不在速度上
本测里解释器模式的四个节点类对应四条文法规则(加减乘除),终结符两类。这棵树做到了手写直算做不到的四件事:
- 求值前先检查。 走一遍树就能做类型检查、常量检查、除零检查,错误可以定位到具体节点。手写直算没有这个中间层,只能等运行到那一行。
- 同一棵树多种操作。 求值、打印回表达式、求导、估算精度,都是树上的一次遍历,加一个访问者就够了。本测里
ast、switch、闭包树三种求值形态共用同一棵树的实例,正是因为这个中间层存在。 - 语言可以来自数据。 表达式字符串、规则文件、用户输入,解析成树之后,后续处理不用再碰字符串。
- 改写和优化有落点。 常量折叠、公共子表达式消除、化简
x * 1,都是在树上做的局部变换;做完之后可以选择继续解释,也可以用变换后的树去构建闭包。
代价是节点类的维护:加一条文法规则要加一个类,改一条规则要遍历所有操作。文法规则超过十来个、操作超过三四个之后,访问者那个矩阵就会开始拖慢改动,这也是表达式求值器在项目里通常只有几百行的原因。语言一旦长大,做法会换成解析器生成器,或者嵌入一个脚本引擎。
    graph LR
    subgraph JDK["JDK 里的三种编译产物"]
        P["Pattern:正则 → Node 树<br/>匹配时解释 + 回溯"] --> M["Matcher 解释整棵树"]
        MF["MessageFormat:模式 →<br/>formats/offsets/argumentNumbers 三个数组"] --> L["subformat 下标循环,无逐节点分派"]
        DT["DateTimeFormatter:模式 →<br/>打印器/解析器链"] --> C["逐段委托给子格式化器"]
    end
三个例子的共同点:编译产生一份可复用的中间表示,速度不是它的目标。MessageFormat 的解释循环是一个下标循环加数组访问,连对象分派都没有;正则的 Matcher 要在 Node 树上做回溯,逐节点分派无法避免。两者都在速度上让位于「同一份代码处理任意模式」这个需求。
八、结论
- 27 节点表达式:闭包树 34.09 ns、语法树 34.38 ns(JDK 21),32.50 ns 对 32.60 ns(JDK 25)。构建期编译成闭包没有测出收益,两个 JDK 上的差都在 1% 以内。
- 7 节点表达式重复了同一个结果:9.47 ns 对 9.58 ns(JDK 21),9.16 ns 对 9.17 ns(JDK 25)。两个尺寸合起来,每次求值约为 0.9 ns 固定开销加每个节点 1.2 ns,两种形态共用同一条直线。
- 内联日志给出了原因:两边都被 C2 内联到一半就停手,闭包树停在
Bench$Fn::apply ... virtual call,语法树停在Bench$Node::eval ... virtual call,剩下的都是每节点一次动态调用(inlining21.txt:1931-1942、:2165-2178)。 - 把
-XX:MaxInlineLevel从 15 提到 30,两个实现的耗时和日志里的拒绝条数都没有变化(recursive inlining is too deep都是 8 次),深度上限不是这两种形态的分界。 - 外部
switch分派最慢:84.43 ns 对 34.38 ns,慢 2.5 倍。递归自调用被判callee is too large510 次,一次都没内联,每次分派还多付一份invokedynamic的 typeSwitch 开销。 - 手写直线算式 1.81 ns,是这棵 27 节点树的价值上限。32.6 ns 的差是遍历和分派的价格,编译成闭包买不到它,只有消灭树结构才买得到。
- 正则:预编译复用 259 ns/次、240 B;每次
Pattern.compile678 ns/次、2024 B。省下的 418 ns 和 1.8 KB 是把编译提出循环的收益,比值 2.6 倍。 - 同一套循环代码换个会话测,绝对水平会漂 26%(27.31 ns 与 34.38 ns),打平这个结论在每次会话里都成立。
Pattern.compile没有缓存,Pattern.java:1101-1103就是new Pattern(regex, 0);构造函数里直接调compile()(:1575-1580)把正则解析成Node树。Pattern.matches和String.matches每次都走完整流程,javadoc 自己在:1208-1209写了别这么用。Matcher每次匹配新建,构造函数分配int[捕获组数 * 2]等三块状态(Matcher.java:245-252),这是预编译路径仍要付的 136 到 240 字节。MessageFormat把模式编译成三个并行数组再解释(MessageFormat.java:605、:1453-1468、:1494-1503),构造函数里就编译(:516),构造放进循环同样会重复解析。- 判断顺序:先数执行次数,再把现成的编译设施提出循环,最后才考虑自己编译成闭包树,并且量它。解释器模式的价值在可修改的语言和可检查的语法树,不在速度。
参考资料
- Pattern (Java SE 25)
- Pattern (Java SE 21)
- Matcher (Java SE 25)
- MessageFormat (Java SE 25)
- String (Java SE 25)
- Interpreter pattern (refactoring.guru)
- HotSpot Virtual Machine Performance Enhancements
- 设计模式总纲
系列索引:设计模式系列