设计模式——责任链:三种形态
责任链把「谁处理这个请求」从调用点挪到了运行时。调用方发出一次,节点自己决定接不接。
JDK 里这条链有三种落地形态,表达「拦住了」的方式各不相同:处理链返回boolean,过滤链返回替换对象或null,Stream 的 stage 链用反向询问的取消标记。
本文用 1 亿个元素量三种形态的每元素成本随链长的变化,用 8 节点链量命中位置的影响,再从 JDK 源码指出差别出自哪一行。
一、三种形态,三种收场
一个请求要穿过若干检查点,每个检查点各自判断:这个我能处理,或者这不归我管,交给下一个。责任链(Chain of Responsibility)把这条传递路径做成对象结构,但「传递」本身在 JDK 里有三条不同的实现路线。
处理链的节点返回 boolean。命中返回 true,调用方知道事情办完了;全部返回 false 就是没人管。停下来的信号沿返回值传回调用方。
过滤链的节点不报告「办没办成」,返回一个替换对象或者 null。返回新对象表示这一层改写了请求、需要重发;返回 null 表示这一层放行,继续看下一个节点。java.net.http 用这个形状:请求过滤器正序遍历,响应过滤器倒序遍历,任何一层想重发就中断整个遍历。
stage 链的方向是反的。数据往前推(accept 递给下游),停止的信号往回问。每个 stage 的 sink 不保存「还要不要」的状态,末端 sink 返回取消时,上游逐层转发这个回答。Stream 的 findFirst、anyMatch 走这条路。
    graph TD
    subgraph H["形态一 处理链:return boolean"]
        H1["handler1.handle"] -->|"false,交棒"| H2["handler2.handle"]
        H2 -->|"false"| H3["handler3.handle"]
        H3 -->|"true"| HR["调用方收到 true,链停在这里"]
    end
    subgraph F["形态二 过滤链:return 对象或 null"]
        F1["filter1.request"] -->|"同一对象,放行"| F2["filter2.request"]
        F2 -->|"新对象"| FR["中断遍历,调用方重发"]
        F2 -->|"null"| F3["filter3.request"]
    end
    subgraph S["形态三 stage 链:accept 向下,取消标记向上"]
        S1["stage1.accept"] -->|"元素"| S2["stage2.accept"]
        S2 -->|"元素"| S3["末端 sink"]
        S3 -.->|"cancellationRequested"| S2
        S2 -.-> S1
    end
    HR ~~~ F1
    F3 ~~~ S1
三条路线的表达能力不一样:形态一把停止点放在「哪个节点接下了」,形态二放在「哪个节点要重发」,形态三只有末端能终止,中间节点想让整条链提前结束,得靠 takeWhile 这种带状态的操作。
二、实验设计
机器与本机 JDK:
- Apple M1 Pro,macOS Darwin 25.6.0,arm64
- JDK 21.0.8+12-LTS-250 与 JDK 25+37-LTS-3491,各跑一遍
- 每轮新起一个 JVM,先预热再计时,取 5 轮的中位数
- 本机没有 JMH。这是单机微基准,用来判断量级和形状,不能当成硬件上限
- 计时循环在全局锁内串行执行。锁能排除同机其它进程抢 CPU,排不掉频率调节与热噪声
三组实验:
- 链长:链长 1/2/4/8,每个元素走完整条链,共 1 亿个元素。同时用一份带计数器的链数出每元素实际调用了几个节点。这个计数是精确的,不受计时误差影响,用来确认「走满整条链」这一前提成立。
- 短路位置:固定 8 节点链,让元素分别在第 1、第 4、第 8 个节点被拦下,外加「没有一个节点拦得住」的穿透情况和「最后一个节点兜底」的对照。
- Stream 对照:
LongStream.range(0, 1e8)上叠 1/2/4/8 个mapstage,再filter加sum()。对照组是把同样的运算写在一个方法里、由 JIT 内联的循环。另外测findFirst的短路:命中位置从数组第 1 个元素挪到第 2000 万个,以及完全不命中。
三种形态的节点语义不同,绝对数字不能横向比。能横向比的是各自随链长的增长斜率,那才是「链有多长要付多少钱」。
测量怎么自检
每组实验都带断言,跑错会直接抛异常终止 JVM:
- Stream 每一组 stage 数下的求和结果,必须等于单方法内联的求和结果。8 个 stage 时这个数是 1,350,076,499,944。
- 处理链的命中数必须等于元素数;短路实验里「命中第 k 个节点」的命中数必须是 1 亿。
findFirst的 Stream 版和单方法版必须返回同一个值,不命中时都返回 -1。
这些断言拦住的是「写错了但跑得挺快」这类结果。基线跑对了,比较才有意义。所有数字和断言输出都在 /tmp/pattern-runs/ChainOfResp.log 里。
三、实测一:链长决定每元素成本
处理链
链上的节点是同一种类,每个持一个 (mask, tag),判断 (x & mask) == tag:命中返回 true,否则转给下一个;走完全部节点还没命中就返回 false。构造数据时只让最后一个节点命中,这样「走满整条链」是确定的,没有概率平均。1 亿个元素:
| 链长(节点数) | JDK 21 | JDK 25 | JDK 21 每元素 | JDK 25 每元素 | 节点调用/元素 |
|---|---|---|---|---|---|
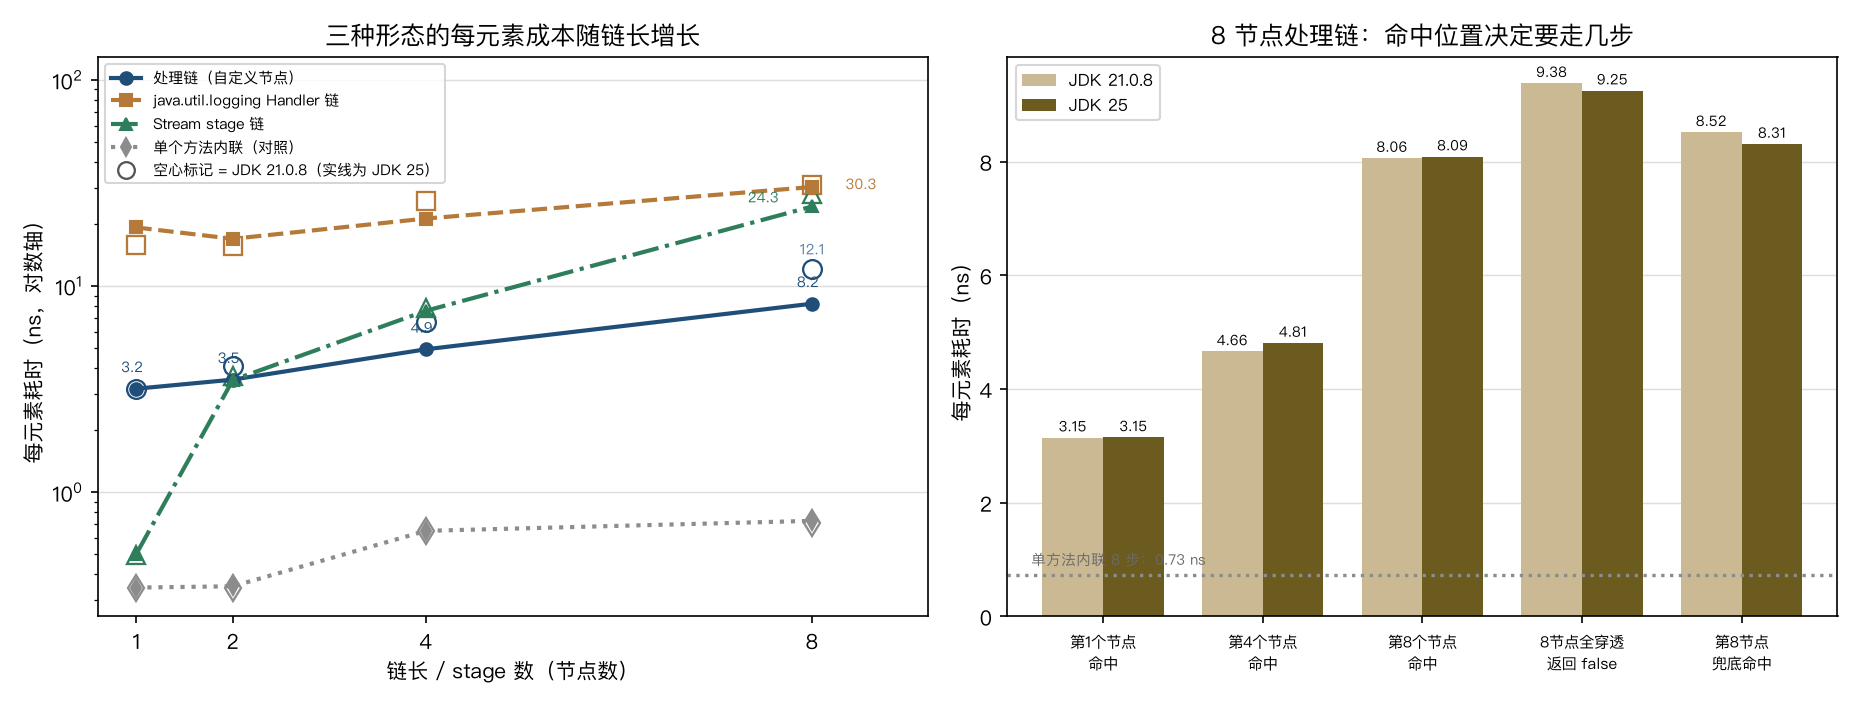
| 1 | 318 ms | 317 ms | 3.18 ns | 3.18 ns | 1 |
| 2 | 412 ms | 352 ms | 4.12 ns | 3.52 ns | 2 |
| 4 | 666 ms | 493 ms | 6.67 ns | 4.94 ns | 4 |
| 8 | 1212 ms | 821 ms | 12.12 ns | 8.22 ns | 8 |
最后一列是带计数器的同一份链数出来的节点调用数,它精确等于链长,说明每个元素都走满了整条链。
这两个数不是估算。计数器在节点的 handle 方法第一行自增,链跑完后把所有节点的计数加起来。1 亿个元素、链长 8 得到 8 亿,链长 1 得到 1 亿,都是整数。计时会受调度和频率影响,计数不会,所以「走满整条链」这个前提不依赖计时。
从 1 个节点到 8 个节点,JDK 25 上每元素从 3.18 ns 涨到 8.22 ns,2.6 倍;JDK 21 上 3.8 倍。节点数只涨了 8 倍,耗时没跟上,前两个节点几乎是免费的。
原因是这条链的每一层只做一次位与、一次比较、一次方法调用,而 1 亿次迭代之间互相独立。M1 Pro 是乱序执行,前一个元素还没走完,后一个元素的链已经进入流水线,链的深度被盖住了一部分。斜率在 4 节点之后才显出来:每多一个节点,每元素多花约 0.72 ns。JDK 21 的斜率更陡,8 节点时 JDK 21 是 12.12 ns、JDK 25 是 8.22 ns。两个版本这条链的源码一致,差的是编译器版本。
每节点 0.72 ns 换算到 1 亿个元素上:链长 8 的处理链比链长 1 多花 0.5 秒。在这条形态上,链长不是主要成本。
JDK 自己的处理链:java.util.logging
java.util.logging 的 Handler 链是形态一的现成实现。给一个关闭了父传播的 Logger 挂 1/2/4/8 个空 Handler,预建一个 LogRecord,调 2000 万次 logger.log(record):
| Handler 数 | JDK 21 logger.log |
JDK 25 logger.log |
JDK 21 手写 for 循环 | JDK 25 手写 for 循环 | 每次调用分配字节 |
|---|---|---|---|---|---|
| 1 | 15.92 ns | 19.26 ns | 2.24 ns | 2.52 ns | 24 |
| 2 | 15.62 ns | 16.97 ns | 4.18 ns | 4.17 ns | 24 |
| 4 | 25.84 ns | 21.28 ns | 8.37 ns | 8.33 ns | 32 |
| 8 | 30.96 ns | 30.27 ns | 16.70 ns | 16.69 ns | 48 |
两列「手写 for 循环」是同样的 Handler 数组上直接循环 publish,用来看 JDK 那层包装值多少钱。
1 个 Handler 时 logger.log 是 19.26 ns,手写循环是 2.52 ns。8 个 Handler 时是 30.27 ns 对 16.69 ns,差距从 16.74 ns 缩到 13.58 ns。那笔固定开销来自等级判断、过滤器检查和一次数组分配,三样都在每次调用的路径上,没有缓存;Handler 越多,这笔开销摊得越薄。
1 个 Handler 反而比 2 个 Handler 慢,两个 JDK 上都是这个方向(JDK 25 是 19.26 对 16.97 ns,JDK 21 是 15.92 对 15.62 ns),原因没有继续追。
分配那一列是干净的证据。每次调用分配 24 字节(1 个和 2 个 Handler)、32 字节(4 个)、48 字节(8 个),手写循环始终是 0。
Stream 的 stage 链
LongStream.range(0, 1e8) 上叠 stage 再终结。1 亿个元素:
| stage 数 | JDK 21 流水线 | JDK 25 流水线 | JDK 21 单方法 | JDK 25 单方法 | 倍数(JDK 25) |
|---|---|---|---|---|---|
| 1 | 0.50 ns | 0.50 ns | 0.34 ns | 0.34 ns | 1× |
| 2 | 3.65 ns | 3.50 ns | 0.34 ns | 0.35 ns | 10× |
| 4 | 7.84 ns | 7.59 ns | 0.65 ns | 0.65 ns | 12× |
| 8 | 28.09 ns | 24.35 ns | 0.71 ns | 0.73 ns | 33× |
1 个 stage 时流水线只比单方法慢一点:JDK 25 是 0.50 ns 对 0.34 ns。到 8 个 stage 就是 24.35 ns 对 0.73 ns,33 倍。单方法那一列从 1 个 stage 到 8 个 stage 只从 0.34 ns 涨到 0.73 ns,两头都没有量级上的变化。
曲线形状不同:手写循环的斜率接近零,流水线的斜率是每 stage 约 3.41 ns 并且随 stage 数变大。JDK 21 与 25 在这个形状上一致。
JIT 把这几纳秒花在哪了
用 -XX:+UnlockDiagnosticVMOptions -XX:+PrintInlining 跑同一段代码。1 个 stage 时内联是成功的,RangeLongSpliterator.forEachRemaining 里能看到整条 sink 链被展开:
1 | @ 48 java.util.stream.LongPipeline$3$1::accept (20 bytes) inline (hot) |
stage 多了以后,同一个位置变成:
1 | @ 14 java.util.stream.LongPipeline$9$1::accept (24 bytes) inline (hot) |
LongPipeline$3$1 是 map 生成的 sink,LongPipeline$9$1 是 filter 生成的 sink,每个 stage 的 accept 都在方法体里调 downstream.accept。HotSpot 按类型画像切开这个调用点之后,认为它在做递归内联,于是撞上了深度上限。两个 JDK 的默认值都是 MaxRecursiveInlineLevel = 1、MaxInlineLevel = 15:
1 | $ java -XX:+UnlockDiagnosticVMOptions -XX:+PrintFlagsFinal -version | grep -E "MaxInlineLevel|MaxRecursiveInlineLevel" |
depth 环里每次 p.depth > 0 就包一层 sink,包到第 N 层时第 N 层的 accept 想内联下一层,而编译器认为这是同一个方法在调自己。结果是链上每层都留下一个真实的调用,每 stage 那几纳秒就是这么来的。
-XX:+PrintInlining 是诊断工具,它的输出依赖编译时机和类型画像,不是稳定契约。上面两段摘录来自同一份代码的两次运行,能说明机制,不能当成逐字节复现的产物。
换算成时间才知道值不值
斜率乘上元素数就是实际开销。JDK 25 上处理链每节点约 0.72 ns,stage 链每 stage 约 3.41 ns:
| 元素数 | 处理链每多 1 个节点 | stage 链每多 1 个 stage |
|---|---|---|
| 1 万 | 0.007 ms | 0.03 ms |
| 100 万 | 0.72 ms | 3.4 ms |
| 1 亿 | 72 ms | 341 ms |
这张表是从实测斜率推出来的,不是单独测的。第一列末尾那个 72 ms 可以和实测量对照:8 节点链比 1 节点链多花 821 ms 减 317 ms,除以 7 个节点,每节点每亿元素约 72 ms。
每秒 1000 个请求的服务,链长 8 和链长 1 的差别是每个请求 5.04 ns,一秒累计 5 微秒。这个量级不需要优化。要付钱的是 stage 链:同样是 1 亿个元素,每多一个 stage 就是 341 ms,8 个 stage 和写成一个方法差 33 倍。
四、JDK 源码里的三处收场
处理链:Logger.log 每次调用重建一次 Handler 数组
java.util.logging 的 Handler 链是形态一。Logger.log(LogRecord) 的循环在 JDK 25 的 java.logging/java/util/logging/Logger.java 第 955 到 974 行:
1 | Logger logger = this; |
loggerHandlers 取自 while 循环内部。accessCheckedHandlers() 在同一个文件第 2068 到 2070 行:
1 | Handler[] accessCheckedHandlers() { |
JDK 21 是同一个实现,Logger.java 第 2098 到 2100 行。config.handlers 是一个 CopyOnWriteArrayList,toArray(T[]) 只在传入数组的长度恰好等于列表长度时才复用它,否则新建一个。长度是 0 时传的是静态的 emptyHandlers(JDK 25 第 222 行),有元素时就是一次新分配。上一节量到的 24、32、48 字节就是它。
这条链没有短路的位置。Handler.publish 在 java.logging/java/util/logging/Handler.java 第 149 行:
1 | public abstract void publish(LogRecord record); |
没有返回值。一个 Handler 处理完,下一个照样收到同一条记录,没有任何一个位置能表达「已经有人处理过了,后面不用看」。
过滤链:一张 List,两个方向,null 表示放行
java.net.http 的 HeaderFilter 是形态二。接口在 java.net.http/jdk/internal/net/http/HeaderFilter.java 第 35 到 45 行:
1 | interface HeaderFilter { |
请求方向不返回任何东西,这一层只加头、记状态,没有地方表达拦截。响应方向返回 HttpRequestImpl,null 表示放行。遍历在 MultiExchange.java 第 231 到 255 行:
1 | private void requestFilters(HttpRequestImpl r) throws IOException { |
请求正序、响应倒序,同一个 ListIterator,只是初始位置在末尾。第 248 到 250 行的 if (newreq != null) return newreq; 就是短路:RedirectFilter 判定要重定向时返回一个新的 HttpRequestImpl,MultiExchange 拿它重发,后面的过滤器这一轮不再执行。
链本身是一张普通 ArrayList,FilterFactory.getFilterChain() 用反射实例化节点,FilterFactory.java 第 40 到 52 行:
1 | List<HeaderFilter> getFilterChain() { |
HttpClientImpl.initFilters() 把顺序定死,HttpClientImpl.java 第 1674 到 1680 行:认证、重定向,Cookie 只在配了 CookieHandler 时才加。这条链的节点数在客户端构造时确定,之后不再变。
一个请求在这条链上要走两个方向。发出时正序遍历:认证过滤器往系统头里塞凭据,Cookie 过滤器塞 Cookie,两个 request 方法都返回 void,所以无论它们做了什么,后面的节点照样执行。响应回来时倒序遍历:先走 Cookie 把 Set-Cookie 交给 CookieHandler,再走重定向判断,最后才回到认证过滤器。RedirectFilter.handleResponse 判定需要重定向时返回 HttpRequestImpl.newInstanceForRedirection(...)(RedirectFilter.java 第 136 行),这个非 null 返回值让倒序遍历当场中断,MultiExchange 用新请求重发。
倒序的理由在重定向这一层。重定向会生成一次全新的往返,如果 Cookie 过滤器排在重定向之后,那次新往返的响应就绕过了 Cookie 处理。链上唯一能中断遍历的位置是返回非 null 的那一层;void request 那一侧没有这个位置。
stage 链:每个元素要把链走两遍
Stream 的中间操作链是形态三。链的构造在 AbstractPipeline.wrapSink,JDK 25 的 java.base/java/util/stream/AbstractPipeline.java 第 604 到 611 行:
1 | final <P_IN> Sink<P_IN> wrapSink(Sink<E_OUT> sink) { |
每个 stage 把自己的 sink 包在已有的 sink 外面,从末端往上包,返回的是最上游那个,源数据喂给它。JDK 21 的同名方法在 AbstractPipeline.java 第 543 到 550 行,代码一致。
「停」能不能生效,取决于末端 sink 的 cancellationRequested()。Sink.ChainedReference 把它一路转下去,JDK 25 的 Sink.java 第 264 到 267 行,JDK 21 在同一个位置:
1 |
|
循环本身出现在两处。JDK 25 AbstractPipeline.java 第 565 到 576 行:
1 | final <P_IN> void copyInto(Sink<P_IN> wrappedSink, Spliterator<P_IN> spliterator) { |
有短路能力的流水线走的是另一条循环。LongPipeline.forEachWithCancel 在 JDK 25 的 LongPipeline.java 第 158 到 164 行:
1 | final boolean forEachWithCancel(Spliterator<Long> spliterator, Sink<Long> sink) { |
每个元素之前先问一次 cancellationRequested()。这一问要沿着 sink 链从上游走到末端,于是每处理一个元素,整条链要走两遍:一遍 accept 往下送数据,一遍 cancellationRequested 往上问要不要停。JDK 21 的同一方法在 LongPipeline.java 第 157 到 163 行。
中间节点只有 takeWhile 能让链提前停,它的做法在 java.base/java/util/stream/WhileOps.java 第 198 到 219 行:
1 | Sink<Long> opWrapSink(int flags, Sink<Long> sink) { |
它自己的状态(!take)和末端的回答取或。makeTakeWhileLong 在这个 sink 上挂的是 StreamOpFlag.NOT_SIZED | StreamOpFlag.IS_SHORT_CIRCUIT(第 50 行),也就是告诉整条流水线「这个 stage 有资格触发短路循环」。普通 map 或 filter 的 stage 没有这个资格,它们的 cancellationRequested() 只是纯转发。
两个 LTS 之间这三条链没有变
本文引用的实现逐行比对过 JDK 21 与 JDK 25 的 src.zip:
| 位置 | 21 与 25 的差异 |
|---|---|
AbstractPipeline.wrapSink |
无 |
AbstractPipeline.copyInto |
无 |
AbstractPipeline.copyIntoWithCancel |
只差一个 @SuppressWarnings 注解 |
Logger.log(LogRecord) 的 Handler 循环 |
无 |
MultiExchange.responseFilters |
无 |
整个文件的行数有变化:AbstractPipeline.java 在两个 LTS 之间有 107 行不同,Logger.java 有 105 行。本文的行号只在对应版本里成立,跨版本引用要重新数。
五、实测二:短路位置决定要走几步
固定 8 节点链。节点 i 检查 x 的第 i 个四位组是否等于 i+1,构造数据时让它只在指定位置命中。1 亿个元素:
| 命中位置 | 走过的节点数 | JDK 21 每元素 | JDK 25 每元素 | 节点调用/元素 |
|---|---|---|---|---|
| 第 1 个节点 | 1 | 3.15 ns | 3.15 ns | 1 |
| 第 4 个节点 | 4 | 4.66 ns | 4.81 ns | 4 |
| 第 8 个节点 | 8 | 8.06 ns | 8.09 ns | 8 |
| 无人命中,8 个节点全部穿透 | 8 | 9.38 ns | 9.25 ns | 8 |
| 第 8 个节点兜底命中 | 8 | 8.52 ns | 8.31 ns | 8 |
JDK 25 上第 1 个节点命中是 3.15 ns/元素,第 4 个是 4.81 ns,第 8 个是 8.09 ns。节点调用计数精确等于 1、4、8。
两行都是 8 次节点调用,可以对照。第 8 个节点返回 true 时是 8.09 ns,8 个节点全部返回 false、让调用方拿到「没人管」的结果时是 9.25 ns,差 0.94 ns。链长一样,分歧只有返回值。这个差值来自链尾的 next == null 检查落在了返回路径上,而 SINK 的写入被 if 挡掉了。
短路的成本是线性的:命中第 K 个节点,每元素就是 K 次节点调用。8 节点链上第 1 个节点命中比第 8 个快 2.6 倍,一亿次调用上这个差额就是拦得早的收益。
六、Stream 的短路:省下的是扫描量
同一件事在 findFirst 上是另一个形状。数组长 2000 万,8 个 map stage 之后接 filter 和 findFirst,命中值放在数组的不同位置:
| 命中位置 | 每次扫描元素数 | 调用次数 | Stream 每元素 | 单方法每元素 | 倍数 |
|---|---|---|---|---|---|
| 数组第 1 个 | 1 | 2,000,000 | 151.91 ns | 2.17 ns | 70× |
| 数组中间(第 1000 万个) | 10,000,001 | 15 | 27.18 ns | 0.76 ns | 36× |
| 数组最后一个 | 20,000,000 | 7 | 27.61 ns | 0.72 ns | 38× |
| 不存在,扫完全部 | 20,000,000 | 7 | 26.93 ns | 0.29 ns | 91× |
每元素扫描成本在两列之间是常数:Stream 大约 27.18 ns/元素,单方法内联是 0.76 ns/元素。挪动命中位置不改变每元素成本,改变的是要扫多少元素。
短路的收益上限由扫描量决定,而每元素成本的差额由 sink 链决定。命中在数组中间时,Stream 要扫 1000 万个元素才能停下,单方法只需要扫同样的 1000 万个,但每个元素便宜 36 倍。命中在第一个元素时,Stream 每次调用固定花 152 ns 构建一次 sink 链,而每元素只处理一个数据。建链比处理数据贵得多。
Stream 的短路不减少每元素的成本,只减少处理的元素数,这是它和形态一、二的关键差别。想让链本身变便宜,只能减少 stage 数。
七、判断顺序
三种形态选哪一种,取决于「谁有资格让链停下来」和「停下来之后调用方要做什么」:
    graph TD
    Q0["一个请求要穿过若干检查点"] --> Q1{"调用方要不要知道是谁接下的?"}
    Q1 -->|"要,而且只需要知道办没办成"| A1["形态一 处理链<br/>返回 boolean<br/>例:Logger 的 Handler 链"]
    Q1 -->|"要,而且这一层会改写请求"| A2["形态二 过滤链<br/>返回替换对象或 null<br/>例:HttpClient 的 HeaderFilter"]
    Q1 -->|"不要,只要最终结果"| A3["形态三 stage 链<br/>末端 sink 的取消标记<br/>例:Stream 的 map/filter"]
    A2 --> R2{"节点数在运行期会变吗?"}
    R2 -->|"会"| N2["用 List 装节点,每次遍历现取<br/>注意请求与响应两个方向"]
    R2 -->|"不会"| N3["构造时定死,可以缓存成数组"]
    A3 --> R3{"每元素要不要做重活?"}
    R3 -->|"要"| N4["先把 stage 数压到 2 个以内<br/>或写成一个方法"]
    R3 -->|"不要"| N5["流水线的可读性几乎免费"]
什么时候用
处理链:检查点的数量在运行期变化,而且每个检查点都可能结束这次处理。每节点 0.72 ns,链长 8 以内都便宜。
过滤链:节点会对请求本身动手,需要重发。这个形态的代价来自方向:响应方向倒序遍历,加节点时要同时想清楚它在两个方向上的位置。
stage 链:数据量大、每个元素的处理简单、stage 少。可读性换来的成本是每 stage 约 3.41 ns。
什么时候不用
- 处理链的节点少于 3 个时,
if更快。 链长 1 的实测是 3.18 ns/元素,一次直接的if判断就在这个量级;把两个判断做成链,换来的是运行期增删节点的能力,不需要这个能力就别付。 - Handler 链上挂一个 Handler 就要算一次分配。 每次
logger.log都会toArray一个新数组,24 到 48 字节。日志量大、Handler 只有一个时,这个分配是纯开销。 - Stream 的短路省不掉每元素的骨架成本。
findFirst每元素 27.18 ns 对单方法内联的 0.76 ns。要在千万级元素上按条件提前退出,for循环加break依然更快。 - 任何节点都可能成为瓶颈时,把最热的那个前移。 第 1 个节点命中与第 8 个节点命中差 2.6 倍。
把链压平
三组测量给出的都是链本身的开销,要省掉它,只能在构造时把链压平,运行时不再有链:
- 处理链:1 个节点 3.18 ns,8 个节点 8.22 ns。节点集合固定时,把 8 个判断写成 8 行
if,成本回到一个判断的量级,代价是运行期不能增删节点。 - stage 链:8 个 stage 是 24.35 ns,写成一个方法是 0.73 ns。这里的差距是 33 倍,压平的收益最大。
- Handler 链:8 个 Handler 时 JDK 路径是 30.27 ns,手写循环是 16.69 ns。差距 13.58 ns 是每次调用的固定开销,和链上有几个 Handler 无关,压平这条链省不掉它。
HttpClient 的过滤链在客户端构造时定死,后面不再变,所以它有资格压平。日志的 Handler 可以在运行时 addHandler,每次调用重新取一遍数组是它付的保险费。压平之前先回答一个问题:节点集合在运行期会不会变。
一条判断顺序
先问「几个节点可能拦下这个请求」。答案是一个,就用一次 if。答案是多个且每个都可能改写请求,用过滤链。然后是「每个元素要付多少钱」:处理链每节点 0.72 ns,stage 链每 stage 3.41 ns。最后问「节点集合在运行期变不变」:会变就用 List 每次遍历现取,不变就在构造时定死,别在热路径上重建。
总结
- 三种形态的区别在「停」怎么表达:处理链用
boolean返回值(Handler.publish是void,所以 JDK 的 Handler 链根本没有短路的表达位置),过滤链用返回替换对象或null(MultiExchange.responseFilters第 250 行return newreq),stage 链用末端 sink 的cancellationRequested反向转发。 - 处理链每节点约 0.72 ns(JDK 25)。链长从 1 到 8,耗时涨 2.6 倍,节点数涨 8 倍。乱序执行把前两个节点的成本盖住了。
Logger.log每次调用重新取一次 Handler 数组(Logger.java第 955-974 行调accessCheckedHandlers(),第 2068-2070 行config.handlers.toArray(emptyHandlers))。实测每次调用分配 24/24/32/48 字节,对应 1/2/4/8 个 Handler,手写 for 循环是 0 字节。- Stream 的每 stage 成本约 3.41 ns:8 stage 的流水线是 24.35 ns/元素,单方法内联是 0.73 ns,33 倍。1 个 stage 时两者接近(0.50 对 0.34)。
- 这个差距的原因是 C2 判定 sink 链在做递归内联:
PrintInlining输出failed to inline: recursive inlining is too deep,两个 JDK 的MaxRecursiveInlineLevel默认都是 1。 - 8 节点链上第 1 个节点命中是 3.15 ns/元素,第 8 个是 8.09 ns,差 2.6 倍。全部穿透(8 个节点都返回
false)是 9.25 ns,比第 8 个节点兜底还多 0.94 ns。 - Stream 的短路只减少扫描量,不减少每元素成本:命中位置从数组头部挪到第 2000 万个,每元素成本稳定在 27.18 ns 上下,单方法内联稳定在 0.76 ns 上下。
- 带短路的流水线每元素把 sink 链走两遍(
LongPipeline.forEachWithCancel,第 158-164 行),一遍accept向下,一遍cancellationRequested向上。 - 中间 stage 想自己喊停只有
takeWhile,实现是把自身状态和末端回答取或(WhileOps.java第 214-217 行),并声明StreamOpFlag.IS_SHORT_CIRCUIT(WhileOps.java第 50 行)。
参考资料
- Chain of Responsibility(refactoring.guru)
- Handler (Java SE 25)
- Logger (Java SE 25)
- HttpClient (Java SE 25)
- Sink (Java SE 25)
- AbstractPipeline (Java SE 25)
- java.util.stream 包说明
- JDK-8075939: Stream.flatMap() causes breaking of short-circuiting of terminal operations
- java.util.logging 包说明
相邻的几篇:模板方法 讲继承体系里的钩子,策略 讲把算法换掉,装饰器 讲怎么往一条链上叠能力,中介者 讲把 N×N 的调用收敛到一个中间人。
系列索引:设计模式系列