设计模式——状态:状态位还是状态类
FutureTask管一个任务从提交到结束的全部状态,字段是volatile int state,七个常量,靠 CAS 迁移。ExecutorService和CompletableFuture都建在它上面,JDK 没给它写七个状态类。
GoF 的状态模式走另一条路:一个状态一个类,事件交给多态处理,状态自己决定下一步。书上那个 TCP 连接例子好写,代价没有现成数字。
本文把同一个四状态状态机写成五种形式,在 JDK 21 与 25 上各跑 5033 万次事件,量耗时与分配,再用字节码和 JIT 日志解释差距从哪来。
一、状态放在哪里
状态的存储方式和迁移的决策方式可以拆开看。GoF 把两件事绑在一起:状态是一个对象,迁移由虚调用决定。JDK 里常见的是另一种组合:状态是一个 int,迁移是一串比较和位运算。
两边的差别用一台四状态、五事件的状态机就能摆出来,后面所有实验共用它:
    stateDiagram-v2
    [*] --> NEW
    NEW --> RUN : START
    NEW --> FAIL : CANCEL
    RUN --> DONE : OK
    RUN --> FAIL : ERR
    DONE --> NEW : RESET
    FAIL --> NEW : RESET
    note right of DONE
        每个状态只接受少量事件,
        其余事件到达时状态不变
    end note
终态有两个(DONE 和 FAIL),对 RESET 的行为相同,对其他事件也相同,只有外部观察时才需要区分。4 个状态 × 5 个事件共 20 种组合,合法的只有 6 种,其余 14 种到达时什么都不做;事件流里非法事件比合法事件多。
五种写法
同一台机器,五种实现:
| 写法 | 状态表示 | 迁移决策 | 非空行数 |
|---|---|---|---|
| 枚举 + switch | enum Phase 字段 |
lookupswitch 跳转表 |
11 |
| 状态对象(共享单例) | 四个单例之一 | 虚调用 on(event) |
29 |
| 状态对象(每次 new) | 每个迁移新建对象 | 虚调用 onAlloc(event) |
31 |
| 位标志 + 位运算 | 一个 int,四选一 |
掩码测试 + 掩码改写 | 18 |
| 位标志 + CAS | 同上,volatile |
VarHandle.compareAndSet 循环 |
18 |
「共享单例」和「每次 new」的区别在于状态对象能不能复用。状态对象不带数据时可以共享,四个实例活到进程结束,每次迁移只是换一个引用,这是享元模式的做法:把不变的部分抽出来共享,只在必须区分时新建。状态对象带了数据(连接、重试计数、剩余超时)之后没法共享,每次迁移都要新建一个,分配量就是这么来的。
位运算版本的迁移表是两张长度为 5 的 int[]:ALLOW[event] 是接受这个事件的状态掩码,NEXT[event] 是目标状态位。step 的全部逻辑是三行:
1 | int a = ALLOW[e]; |
(s & ~a) 清掉当前状态位,| NEXT[e] 写上目标状态位。整个数组结构里没有一个分支是按状态分的。
CAS 版本跟这个一模一样,只是把 state 改成 volatile,写入换成循环里的 CAS。这一版对应 FutureTask 的形态。
二、实验设计
事件流与驱动
事件流是一份 1,048,576 个 int 的数组,由固定种子的 xorshift 生成,五种取值按 4:5:2:2:3 抽:START 四个、OK 五个、ERR 两个、CANCEL 两个、RESET 三个。五种实现共享同一份数组,处理顺序逐元素相同。
驱动循环是外层 48 趟、内层 1,048,576 个元素,也就是每种写法每轮处理 50,331,648 次事件。每次事件调用一次 step,每 256 次事件把当前状态记进一个乘 31 的校验和。五种实现的校验和必须逐位相同,跑之前先验证这一点,任何一份实现的状态序列偏了就直接抛断言。
事件流里改变状态的比例是 28.1%,其余 71.9% 是状态位不匹配的非法事件。比例由状态机的结构决定:从 NEW 出发只有 START 和 CANCEL 能走,从 RUN 出发只有 OK 和 ERR 能走,事件流的到达顺序跟状态无关,多数事件落在不接受它的状态上。
测量协议
- 五种写法 × 2 个 JDK(21.0.8 与 25) × 3 轮预热 + 7 轮计时的循环,同一轮内五种写法轮流跑,避免 JIT 预热和 CPU 频率漂移只落在其中一种上。
- 每轮记录
System.nanoTime()差值除以事件数,得到 ns/次事件;分配量用com.sun.management.ThreadMXBean.getThreadAllocatedBytes在同线程前后取样,得到 B/次事件;同时记录 GC 次数与 GC 毫秒。 - 计时期间持全局锁独占 CPU,同机并行在跑二十多个同类实验,不锁的话数字互相污染。
- 报出的数字取中位数。
这次测不出什么
- 单线程、无争用。CAS 版本在无争用时才成立,竞争场景需要另一套实验。
- 状态数和事件数都很小,迁移表进得了 L1,换成几百个状态的机器结论可能不同。
- 事件流是随机的,分支预测器学到的东西有限。真实请求流如果是长尾的,分支和 BTB 的状态会不一样。
- 只用 C2。
-XX:+PrintInlining的结论只对热点编译器成立。
三、实测:5033 万次事件
| 写法 | JDK 21 ns/次 | JDK 25 ns/次 | 分配 B/次 | 非空行数 |
|---|---|---|---|---|
| 枚举 + switch | 2.804 | 2.914 | 0 | 11 |
| 状态对象(共享单例) | 5.807 | 5.040 | 0 | 29 |
| 状态对象(每次 new) | 5.402 | 5.229 | 4.49 | 31 |
| 位标志 + 位运算 | 2.959 | 2.978 | 0 | 18 |
| 位标志 + CAS | 4.553 | 4.537 | 0 | 18 |
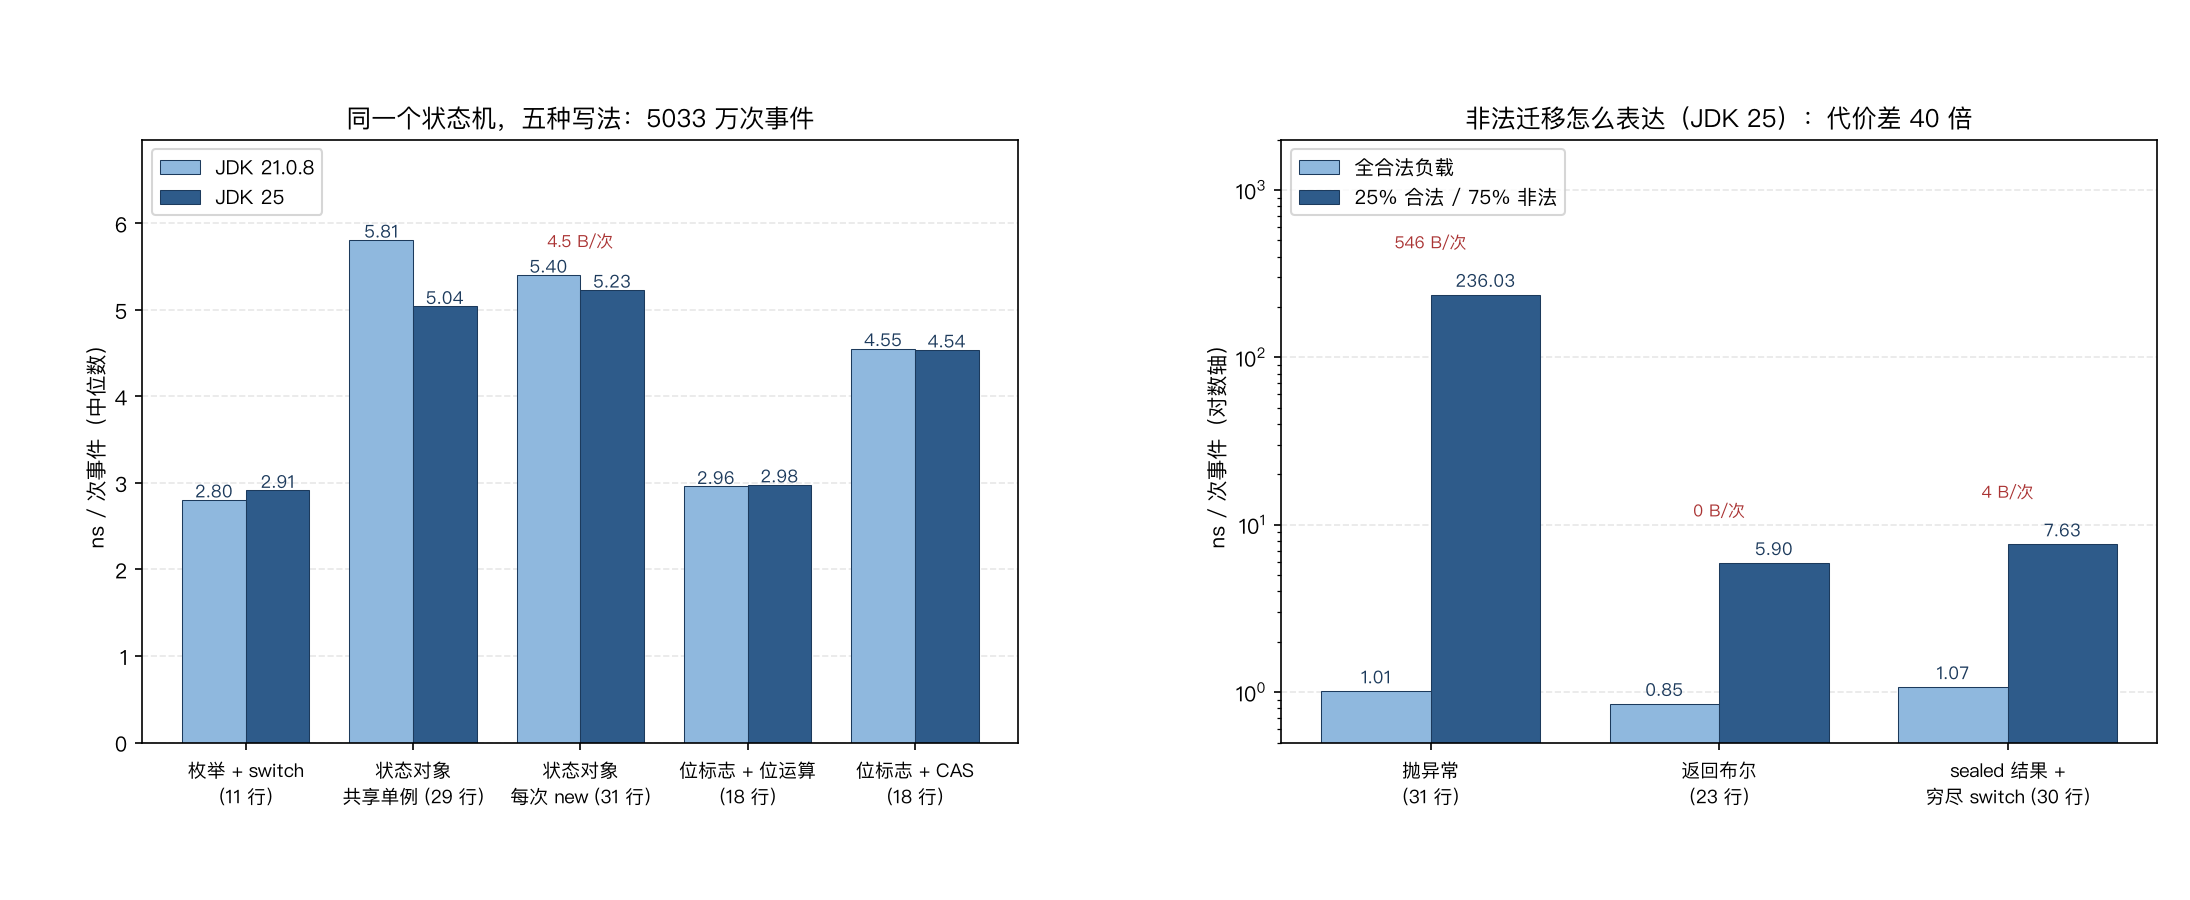
左边五个柱子是五种写法在 5033 万次事件上的耗时,右边三个柱子是非法迁移的三种表达方式。分配列取自 TLAB 计数,没有采样误差,0 就是一次都没分配。
两个 JDK 的差别很小:五种写法里跨版本差得最多的一项是共享单例的状态类,5.807 对 5.040,差 0.77 ns,方向还不一致(枚举和位运算在 JDK 21 上更快,两个状态类版本在 JDK 25 上更快)。跨版本迁移在这份实验里没有收益可谈,选型结论不受 JDK 版本影响。
四条结论
一、枚举 switch 和位运算在同一档。 JDK 25 上是 2.914 ns 对 2.978 ns,JDK 21 上是 2.804 ns 对 2.959 ns。两个 JDK 上都是枚举一侧略快,幅度 2% 到 5%,和它们跟状态类之间的 73% 不在一个量级。两份实现的共同点是把状态存成一个标量,迁移放在调用方的控制流里。
二、状态类慢在虚调用上,跟 Java 的面向对象没有关系。 共享单例版本在 JDK 25 上是 5.040 ns,是枚举版本的 1.73 倍。两个版本的状态字段都是一个对象引用,差别只在 step 的实现:枚举版本先读 ordinal() 再走跳转表,状态类版本走一次虚调用。
三、每次 new 一个状态对象要收 4.49 B/次事件。 每轮 5033 万次事件里约 1412 万次改变了状态,按每次一个 16 字节对象算,一轮就是 216 MiB。这些垃圾全落在年轻代,GC 次数和 GC 毫秒都记在原始日志里。耗时上它和共享单例版本差得不远,代价体现在分配和 GC 上。
四、CAS 版本处在中间。 4.537 ns(JDK 25),比位运算慢 1.52 倍,比状态类快。多出来的是每次迁移一次原子读改写,在无争用时也要走 ldaxr/stlxr 这对指令。
换算成吞吐
2.914 ns 一次事件是单核每秒 3.43 亿次,5.040 ns 是每秒 1.98 亿次。真实业务到不了这个吞吐,倍数在别处显现:step 不会单独待在热路径上,它前面有解析、后面有响应写出,多态调用点挡住的是顺着调用链下去的一整段内联。
分配与 GC
分配列里只有「每次 new」这一行不为零,量出来的值是每次真实迁移一个 16 字节对象(四个状态类都没有字段,对象头 12 字节加 4 字节的 tag)。一轮 5033 万次事件里有 1412 万次迁移,也就是 216 MiB 垃圾。GC 计数上,JDK 25 的那 7 轮里这一行触发了 2 次年轻代回收,累计 1 ms;其余四行都是 0 次、0 ms。
单次分配 16 字节的对象不贵,这个代价要在长时间运行里才看得见。一轮一秒内跑完的负载只够看见一两次回收;把这段循环放进一个常驻服务里,每秒上亿次的迁移会把年轻代填满几轮。
四、差距从哪来
四条 step 的字节码
javap -c 的输出解释了这些差距。枚举版本的 step 完整字节码 40 条指令,开头是这样:
1 | 0: aload_0 |
状态类版本的 step 一共 7 条指令,全部在这里:
1 | 0: aload_0 |
位运算版本 23 条指令,也没有隐藏的分支:
1 | 0: getstatic // Field StateBench.ALLOW:[I |
CAS 版本 28 条,比位运算多出来的部分就是 getfield 换成 VarHandle 的原子读和比较交换。
指令数从少到多是:状态类 7 条、位运算 23 条、CAS 28 条、枚举 40 条。耗时从少到多是:枚举、位运算、CAS、状态类。指令数和耗时反着排。
内联日志
-XX:+PrintInlining 给出的是同一个事实的另一面。驱动循环里,枚举版本和位运算版本的 step 都被内联进循环体:
1 | @ 70 StateBench$SwitchMachine::step (104 bytes) inline (hot) |
状态类版本的虚调用点被拒绝了五次:
1 | @ 6 StateBench$St::on (0 bytes) failed to inline: virtual call |
四个状态类共享一个调用点,类型剖面里有四种接收者,这个调用点成为 megamorphic 调用点,C2 不再内联它。内联失败之后,状态字段的读写要穿过一次间接调用,循环里每次事件都做一次目标地址不可预测的跳转,指令数上省下来的那点优势到这里消失。
状态类慢的机制只有这一条:多态调用点热起来之后内联不进去,跟封装、开闭原则无关。类型剖面里有几个接收者取决于状态数,本文只测了 4 个状态这一档。
位运算为什么没有更快
位运算版本的迁移只有一次分支,分支条件依赖 state 和事件的掩码,两个都不可预测,误判率和枚举版本差不多。省下的是跳转表和虚调用那两次间接跳转,代价是每轮多两次数组读取,两边刚好抵消,测出来是同一个量级。
五、JDK 自己怎么管状态
FutureTask:int 加 CAS 加序号比较
FutureTask 的状态字段与常量,来自 JDK 25 的 src.zip:
1 | // java.base/java/util/concurrent/FutureTask.java:88-101(前六行是类 javadoc 的续行) |
七个常量是序数编号,源码把这个选择用到了两处。一是终态判断可以写成不等式:
1 | // java.base/java/util/concurrent/FutureTask.java:158-164 |
state >= CANCELLED 一次性覆盖三个终态,不用布尔或、不用位掩码。前提是常量按「越靠后越终态」排序,CANCELLED 后面的 INTERRUPTING 和 INTERRUPTED 也要是终态。二是迁移用 CAS 做,只有一条写入路径:
1 | // java.base/java/util/concurrent/FutureTask.java:292-296 |
VarHandle 是在静态块里查出来的:
1 | // java.base/java/util/concurrent/FutureTask.java:582-588 |
七个内部状态对外只剩四个。Future.state() 把 int 映射成 Future.State 枚举,六个内部值合并成 RUNNING/SUCCESS/FAILED/CANCELLED:
1 | // java.base/java/util/concurrent/FutureTask.java:251-269 |
内部的 int 有七个值,含 COMPLETING 和 INTERRUPTING 这种瞬时中间态;对外的枚举只有四个,中间态被吸收掉了。内部表示可以比外部 API 细,代价是要写一个映射方法。
Thread:位字段在里,枚举在外
Thread 把内外两层分得更开,对外只给枚举:
1 | // java.base/java/lang/Thread.java:2331-2393(摘录,略去各常量之间的 javadoc) |
六个常量的名称、顺序与源码一致,每个常量上面原本有一段 javadoc 说明各自对应哪些操作。
内部字段是一个 int:
1 | // java.base/java/lang/Thread.java:243-245 |
threadStatus 里的值是按 JVMTI 规范设置的位标志,getState() 的实现是把位逐条测出来,测的顺序就是优先级:
1 | // java.base/jdk/internal/misc/VM.java:318-345 |
六个常量用的是位,一位可以同时为真(RUNNABLE 和 ALIVE)。位组合映射不出前面五种时,最后两个分支给出兜底:ALIVE 位为 0 返回 NEW,否则返回 RUNNABLE。用位做内部表示,就得配一个把位组合映射回单值的函数,这个函数是分支链。
本文实验里的位运算版本用的是「一位一状态」的互斥编码,Thread 用的是「一位一属性」的叠加编码。两边都用 int 装状态,差别在位之间能不能同时为真。
第三种编码:值本身携带状态
CompletableFuture 连状态常量都没有,用一个 Object 字段同时装状态和结果:
1 | // java.base/java/util/concurrent/CompletableFuture.java:265-292 |
字段为 null 表示未完成,AltResult 表示异常完成,别的对象表示正常完成,AltResult.NIL 专门用来装「正常完成、结果是 null」这个值。三个公开查询各自是一次读加一次判断:
1 | // java.base/java/util/concurrent/CompletableFuture.java:2075-2077 |
状态和结果放进同一个字段,发布就是一次 CAS,读完这个字段就同时拿到了状态和值。代价是状态判断变成类型判断,「取消」和「异常完成」要靠 CancellationException 类型区分。
三个类对应本文实验里的三个位置:FutureTask 的 int 加 CAS 是 bits+cas 那一行,Thread 的位字段是 bits 那一行,CompletableFuture 的「一个字段装两件事」在这五种写法之外,它的每次判断是一次引用比较加一次类型检查。
一条共同做法
FutureTask 和 Thread 都把状态存成 int,都对外暴露枚举或等价类型,都用一次读或一次比较完成状态判断。JDK 里没有哪个类把状态做成对象:这些状态待在热路径上,多个线程还要一起读它。
六、非法迁移怎么告诉调用方
第二个实验把「状态不对时怎么办」单独拿出来量。机器缩到三状态(NEW → RUN → DONE,RESET 回 NEW),三种表达方式:
1 | // A:抛异常 |
调用方相应是三段:
1 | // A |
C 的 switch 没有 default 分支,Outcome 是 sealed 接口且只允许两个实现,编译器检查穷尽性。B 的调用方忘了 if 也不会被拦下,A 的调用方不写 catch 编译不过,但 catch 里写什么编译器不管。
两组负载
- 合法负载:事件流按当前状态现场生成,两亿次事件全部合法。
- 混合负载:四种事件等概率,25% 的事件合法,其余因为状态不符或事件永远非法被拒。
| 表达方式 | 合法 ns/次 21 / 25 |
混合 ns/次 21 / 25 |
混合 B/次 | 非法路径的运行期动作 | 非空行数 |
|---|---|---|---|---|---|
| A 抛异常 | 1.02 / 1.01 | 244.73 / 236.03 | 546.25 | 两次比较 → 构造异常 → 抛出 → 异常表跳转 | 31 |
| B 返回布尔 | 0.85 / 0.85 | 5.87 / 5.90 | 0 | 两次比较 → 返回 false | 23 |
| C sealed 结果 | 1.59 / 1.07 | 7.76 / 7.63 | 3.99 | 两次比较 → 构造 Rejected → indy 分派 → 查表 | 30 |
三份实现的运行期检查次数一样:每次事件做一到两次事件比较,再做一次状态比较。检查通过之后做什么也一样。差别全在检查失败之后的那几步。
混合负载下 A 是 B 的 40 倍(JDK 25)。这个倍数里包含两件事:一次异常构造要走 fillInStackTrace(栈有多深就翻多少帧),以及每次抛出都把 JIT 对调用方的优化打散。分配列更直白,A 每次非法迁移分配 546.25 字节,B 是 0。异常对象本身加上栈回溯数组,一个都不能省。
240 ns 是下限
A 的 236.03 ns(JDK 25)里,大头是 fillInStackTrace 按栈回复制帧。实验里的栈只有两层,驱动方法直接调 step;真实服务里一次抛出的栈深在几十层量级,代价随栈深上涨。把这个数字当成「异常的代价是 240 ns」会低估它。
JIT 侧也留了痕迹。-XX:+PrintInlining 对三个 step 给出的是不同的结论:
1 | @ 39 RejectBench$ThrowMachine::step (102 bytes) failed to inline: callee is too large |
many throws 是 C2 拒绝内联的理由之一:方法里抛出点太多,内联进去会拖累调用者的编译结果。热路径上这么写,C2 会把整个方法从调用链里切出去,这是耗时之外的第二个代价。
责任链和状态机对「没人接受」的处理
事件到达时状态机不接受,本文的机器把事件丢掉;责任链会把它交给下一个处理器,全部处理器都不接受时才抛出或返回失败。两种结构对「没人管」的默认动作不同:状态机的丢弃是显式的,拦截器链的传递是隐式的。
编译期检查的运行期代价
C 的 switch 是编译期穷尽的,运行期照样要分派。javap -c 出来的调用点:
1 | 42: invokevirtual // Method RejectBench$SealedMachine.step:(I)LRejectBench$Outcome; |
分派是一个 invokedynamic 引导的 typeSwitch,拿到一个序数再 lookupswitch。后面那个 default: 92 分支永远不会执行,是编译器为「穷尽性被破坏」留的兜底,里面抛 MatchException。sealed 接口加穷尽 switch 是 Java 17 之后做分发的主力工具,访问者模式里同一套机制可以替代双分派。
合法负载下 C 是 1.59 ns(JDK 21)与 1.07 ns(JDK 25),B 是 0.85 ns 与 0.85 ns,差 0.22 ns(JDK 25)到 0.74 ns(JDK 21)。混合负载下两者的差是 1.89 ns 与 1.73 ns,两个 JDK 上一致。耗时上这个设计不吃亏,风险在分配量依赖编译器的优化状态。
合法负载下的分配量两个 JDK 不一致:JDK 25 是 0.00 B/次事件,C2 把结果对象全部标量替换掉了;JDK 21 同样一份代码是 16.00 B/次事件,每个结果对象都真的分配出来。混合负载下两个 JDK 都只留下一部分,3.99 B/次,正好是 25% 的合法路径那次分配(3.99 ÷ 16 ≈ 25%)。
分配量对逃逸分析的状态敏感。加上 -XX:-DoEscapeAnalysis,混合负载下 C 的分配量从 3.99 涨到 16.00 B/次,耗时从 7.76 涨到 10.87 ns(JDK 21)、从 7.63 涨到 8.65 ns(JDK 25)。16 字节一次的对象在默认参数下大部分会被消掉,这依赖编译器的优化结果,语言层面没有这个保证。结果对象一旦逃出调用方、或者换一个逃逸分析实现不同的 JVM,这份开销就回来了。
三种表达各自的适用面
- 异常:非法迁移是「程序写错了」时才发生的,一年也遇不到几次,抛出去触发告警比继续跑下去好。放进每秒百万次的热路径,等于把栈回溯当成常规控制流,这里的实测差是 40 倍。
- 布尔:调用方只需要知道有没有发生。状态机内部的迁移表、解析器里的「这个 token 吃不吃」,都属于这种。
- sealed 结果:调用方需要知道为什么没发生,或者这个 API 是给别人用的。类型系统会把「忘了处理」变成编译错误,
Rejected里还能带上拒绝时的状态和事件,日志里直接能看见。
七、什么时候用状态类
状态类的开销全部落在多态调用点上,判断顺序要看状态数量和迁移复杂度,「是不是面向对象」不在其中。
    flowchart TD
    A[状态是公开 API 的一部分?] -->|是| B[枚举或 sealed 接口<br/>内部仍可用 int]
    A -->|否| C{状态带数据?<br/>连接、计数、超时}
    C -->|是| D[状态类<br/>数据放字段, 每次迁移新建]
    C -->|否| E{状态 ≤ 4 且迁移固定?}
    E -->|是| F[序数常量 + switch<br/>或位标志 + 掩码]
    E -->|否| G{每个状态的事件处理超过十几行?}
    G -->|是| D
    G -->|否| H[枚举 + 表驱动的迁移表]
    B --> I[多线程读写?]
    F --> I
    H --> I
    D --> I
    I -->|是| J[单个 int/AtomicReference + CAS<br/>别用多个 volatile 字段]
    I -->|否| K[普通字段]
判断顺序里有两条是硬约束。
状态带数据,状态类才有意义。 状态对象能共享,是因为它没有字段。一旦每个状态要携带自己的数据,把数据留在机器对象里再用 switch 分派就写不动了;这时候多态是唯一能让代码保持线性的写法,代价是热路径上多一次间接跳转。状态没有数据时用状态类,代价是 11 行代码变成 29 行。
多线程读写状态时,状态必须是一个可以原子更新的变量。 多个 volatile boolean 字段拼出来的状态在并发下没法一次读完,读到一个「既不在运行、也没结束」的中间组合是常态。FutureTask 用一个 int 加 CAS 就是为了这个。这一条跟状态类冲突:状态类方案的迁移是「读引用、算新引用、写引用」,原子性要靠 AtomicReference 的 CAS 循环自己搭。
什么时候不用状态类
- 状态少于五个、事件少于十个。 迁移表小到能全部塞进一个屏幕,多态的间接层只有坏处。本文测出来的是 1.7 倍的耗时差。
- 状态迁移在每秒百万次以上的路径上。 客户端请求解析、协议状态机、行情撮合,这些地方的
step会被内联到调用者里,状态类版本的调用点会变成 megamorphic,内联失败。 - 状态要跨线程被读。 换成
volatile int或原子引用,读侧变成一次内存读,不需要加锁。
状态类仍然值得写的场景
- 状态带数据,且数据只在某个状态里有意义。订单状态机里
PAID带着支付流水号,SHIPPED带着运单号,把这些字段平铺到机器对象上会让一半字段在任意时刻是空的。 - 每个状态的处理逻辑长度悬殊。
switch里塞进三十行的状态处理,一个方法上百行,读起来比四个小类困难。 - 状态迁移需要被测试覆盖到分支级别。四个状态类各自可以被单独实例化和测试,
switch版本只能通过机器对象间接测。
三个真实状态机落在哪一档
HTTP 请求生命周期(收到 → 解析 → 处理 → 响应 → 关闭)。状态 5 个,事件 6 个,迁移固定,step 每个请求跑一次。这一档用序数常量加 switch,状态还要跨阶段传递时用 int,用不上状态类。
订单状态机(待支付 → 已支付 → 已发货 → 已完成,另有取消和退款)。状态带数据:PAID 带支付流水号,SHIPPED 带运单号,迁移要落库。这一档用状态类,或者用 sealed 接口加记录类型。记录类型不可变,跟不可变与防御性拷贝里讨论的是同一件事:迁移产生新值,不修改旧值。
协议解码器(读帧头 → 读负载 → 校验 → 完成)。事件是字节,迁移由帧长决定,step 落在最内层循环里。这一档用位标志或序数常量加 switch,并且迁移路径上不该有任何分配,一次分配就是一个对象要穿过的年轻代。
总结
- 「状态位」和「状态类」是两种指令序列:前者编译成跳转表和掩码运算,后者编译成一次虚调用。本文实测的差距是 1.73 倍(JDK 25,5033 万次事件),全部来自多态调用点没能内联。
- 分配上的差别更大:共享单例的状态类是 0 B/次事件,每次 new 的状态类是 4.49 B/次事件。状态对象一旦带上数据就没法共享,这是设计上的取舍。
- JDK 里管状态的两个核心类都选了
int加原子更新。FutureTask用序数常量配state >= CANCELLED这种不等式判断,Thread用 JVMTI 的位标志配逐位测试,两个都把枚举留给外部 API。 - 非法迁移的三种表达实测差 40 倍:抛异常 236.03 ns/次加 546.25 B/次,返回布尔 5.90 ns/次加 0 B。sealed 结果类型加上穷尽
switch把「调用方忘了处理」变成编译错误,运行期代价与布尔相当,差 1.73 ns。 - 选型顺序:先看状态是不是公开 API,再看状态带不带数据,最后看状态数和迁移复杂度。前两个问题定下大方向,第三个问题只影响要不要用表驱动。
参考资料
- Gamma, Helm, Johnson, Vlissides. Design Patterns: Elements of Reusable Object-Oriented Software. Addison-Wesley, 1994(状态模式一章)
- FutureTask (Java SE 25 API)
- Thread.State (Java SE 25 API)
- JVM Tool Interface: GetThreadState
- JEP 409: Sealed Classes
- JEP 441: Pattern Matching for switch
- VarHandle (Java SE 25 API)
- 文中源码引用逐字取自 JDK 25 的
lib/src.zip,行号与摘录对应java.base/java/util/concurrent/FutureTask.java、java.base/java/lang/Thread.java、java.base/jdk/internal/misc/VM.java
系列索引:设计模式系列