设计模式——备忘录:快照的代价
备忘录把「回到过去」变成两个方法调用:
save()存下一版,restore()回到某一版。
存一版花多少时间、占多少内存,模式定义里没有答案。全量深拷贝、增量日志、写时拷贝三条路都能实现回滚,代价相差两个数量级。
本文用 1 万条记录(含标签集合)的状态、1000 个事务、每事务改 10 条,量三条路的每事务耗时与分配字节,再量历史上限 10/100/1000 版时的保留内存和回滚耗时。
一、回滚能力买的是什么
发起人(Originator)把状态装进一个备忘录对象,管理者(Caretaker)把备忘录收进版本链,需要时再把某一版交回发起人恢复。快照粒度、版本存放位置、版本何时失效,这些都不在模式定义里。
三个问题决定价格:
- 存的是全部状态,还是这一版改动的增量。
- 版本链保留多少版。
- 代价在存的那一刻付,还是在每次改动时付。
第一个问题把实现分成三条路,后两个问题决定账单什么时候来。
三条路
全量深拷贝:save() 把当前状态整份复制一份挂到链上,回滚时把复制出来的那份换回来。
增量日志:save() 只记一个位置,每次改动之前把旧值写进日志,回滚时按逆序重放。
写时拷贝:状态本身不可变,每次改动产生一份新的、只复制被改动路径的状态,版本链上存旧的根引用,回滚就是换回引用。
    sequenceDiagram
    autonumber
    participant App as 应用
    participant S as 状态(1 万条记录)
    participant H as 版本链
    App->>S: 本事务要改 10 条记录
    App->>H: save()
    H->>S: 全量深拷贝:整份复制 1 万条
    H->>S: 增量日志:记下这 10 条的旧值
    H->>S: 写时拷贝:只留一个根引用
    App->>S: 提交 10 次改动
    App->>H: restore()
    H->>S: 全量深拷贝:换回副本,这一版被消费
    H->>S: 增量日志:逆序重放 10 条记录
    H->>S: 写时拷贝:换回根引用,版本还在
三张账单落在不同位置:
    graph TD
    W["一个事务:先建版本,再改 10 条记录"] --> P1["全量深拷贝<br/>代价在建版本:994 KB / 154 µs"]
    W --> P2["增量日志<br/>代价在每次改动:824 B / 690 ns"]
    W --> P3["写时拷贝<br/>代价在每次改动:9.7 KB / 4.4 µs"]
    P1 --> R1["回滚 = 换指针,版本被消费,要留着就得再拷一份"]
    P2 --> R2["回滚 = 逆序重放,日志条目可以留着只移动游标"]
    P3 --> R3["回滚 = 换根引用,版本不可变,可反复回到同一版"]
与原型的分工
原型模式解决「怎么复制一个对象」(原型),备忘录解决「怎么回到过去」。两者的实现里都有复制,边界不同:原型的一次 clone() 之后就结束了,复制出来的对象做什么与原型无关;备忘录要维持一条版本链,链上每一版的存活时间、内存占用、能否再次回滚,都算备忘录的账,本文只算这一笔。
版本链放哪儿
本文的三条路都默认版本留在内存里,回滚是对象引用之间的操作。第四条路把版本写成字节流:Serializable、JSON,或者数据库里的一行。它的账本换了一套计量单位,分配字节变成序列化耗时加 IO 字节,三条路之间的价差会重新排列。
写时拷贝的结构共享在落盘时消失,每一版都得写出完整字节流,它的优势只剩下「不必为快照做额外工作」。增量日志反而最适合落盘,它写出来的本来就是增量。全量深拷贝一旦超出内存就只能靠磁盘换深度:1 万条记录一版 1 MB,30 天的历史在磁盘上同样是 30 GB 量级。
落盘还多出一项内存里没有的成本:版本的兼容性。类加了字段之后旧字节流还能不能读出来,取决于序列化方案,这一项不在本文的测量范围内。
复杂度写在纸上
| 路径 | 建一版 | 每次改动 | 回滚一版 | 版本能否重复使用 |
|---|---|---|---|---|
| 全量深拷贝 | O(N),N = 记录数 | O(1) | O(1) | 不能,回滚即消费 |
| 增量日志 | O(1) | O(1) 登记 | O(改动数) | 能 |
| 写时拷贝 | O(1) | O(√N),见局限一节 | O(1) | 能 |
二、实验设计
状态与操作流
1 万条记录,每条四个字段:id、name、qty、tags(3 个字符串的 ArrayList)。初始状态约 1 MB,存在一个 ArrayList 里,按 id 顺序索引。
1000 个事务,每个事务先 save() 建一版,再改 10 条记录。改动类型 5 种循环:改名字、改数量、加标签、删标签、换标签,每 10 次改动里有 6 次会碰到标签集合。行号由固定种子生成,三条路跑完全相同的操作流。
三条实现
1 | /* 全量深拷贝:一次 save 复制 1 万条 */ |
三段机制的代码量:深拷贝 27 行,增量日志 54 行,写时拷贝 89 行(非空非注释行,含大括号;写时拷贝那份还包含初始状态构造和 5 个改动分支)。新增一种改动时要碰几个地方,这才是维护成本的差别。深拷贝只改一个 mutate 分支,快照和回滚不用动。增量日志要改两处:登记旧值的分支和恢复的分支,漏掉任何一处都会回滚到错误的状态。写时拷贝改一处,代价是 mutate 必须返回新对象,不能原地修改。
怎么确认三条路算的是同一件事
跑一条 1000 条记录、100 个事务的操作流,每个事务结束后算一次状态校验和(id、name、qty、tags 的滚动哈希加上标签总数),三条路的 100 个校验和逐一相等。之后各回滚 30 版,取到的状态与深拷贝路径记录的第 70 版样本一致:
1 | deep 逐版校验和已记录 |
对不上就没必要往下测。
计量方法
- 计时:
System.nanoTime()分别包住snapshot()与改动循环,累加后除以事务数。每个 JDK 跑 4 轮,第一轮预热丢弃,取后 3 轮中位数。计时期间持一把全局文件锁(22 个同类实验并行会互相抢 CPU)。 - 分配字节:
com.sun.management.ThreadMXBean#getThreadAllocatedBytes,是 JVM 里的计数器,不是估算。 - 保留内存:
System.gc()前后堆占用量差值,再与按实测对象尺寸做的对象图核算交叉验证。 - 回滚计时:单次回滚只有几十到几百纳秒,一次 GC 停顿就足以淹没它。做法是预热一轮,再按分块计时(1000 版时每块 50 版),取块均值的最小值。
局限
- 单机微基准,Apple M1 Pro,判断量级可以,不能当成硬件上限。
- 名字与标签取自固定的字符串池,三条路共享这些
String对象。这一条对全量深拷贝是乐观的折扣:真实文档里 name 各不相同的话,深拷贝还要多复制字符串内容。 - 每事务改 10 条是刻意选的中间值。改动数越少,深拷贝越亏,它按记录总数收费;改动数越多,日志条目越多。
- 写时拷贝用两层分块(100 个分块 × 100 条),一次改动复制 200 个引用,是 O(√N)。32 叉持久化向量把这一步压到 O(log₃₂N),在 1 万条这个量级上节点数相当(约 96 个引用加 3 层对象),量级结论不变。
- 有界历史需要淘汰最旧的版本,淘汰本身有成本。深拷贝路径从
ArrayList头部摘掉一版要把后面的引用整体前移;增量日志要截断日志头部并重算剩下的版本起点。计时跑法上限 10 版,所以增量日志的snapshot()里含了淘汰成本,但每 10 个事务才触发一次,且只搬移 100 条条目。上限 1000 版时每淘汰一版要搬移上万条,那一档的成本远大于本文测到的。
三、实测一:每个事务的代价
| 路径 | 快照 ns/事务(JDK 25 / 21) | 改动 ns/事务 | 每事务合计 ns | 分配字节/事务 | 每轮 GC |
|---|---|---|---|---|---|
| 无快照(对照) | 42 / 37 | 387 / 485 | 429 / 522 | 59 | 0 次 |
| 增量日志 | 136 / 134 | 554 / 898 | 690 / 1,032 | 824 | 0 次 |
| 写时拷贝 | 66 / 63 | 4,299 / 3,907 | 4,365 / 3,970 | 9,691 | 0 次 |
| 全量深拷贝 | 152,544 / 145,824 | 1,473 / 1,457 | 154,017 / 147,281 | 993,897 | 2 到 3 次,5 到 8 ms |
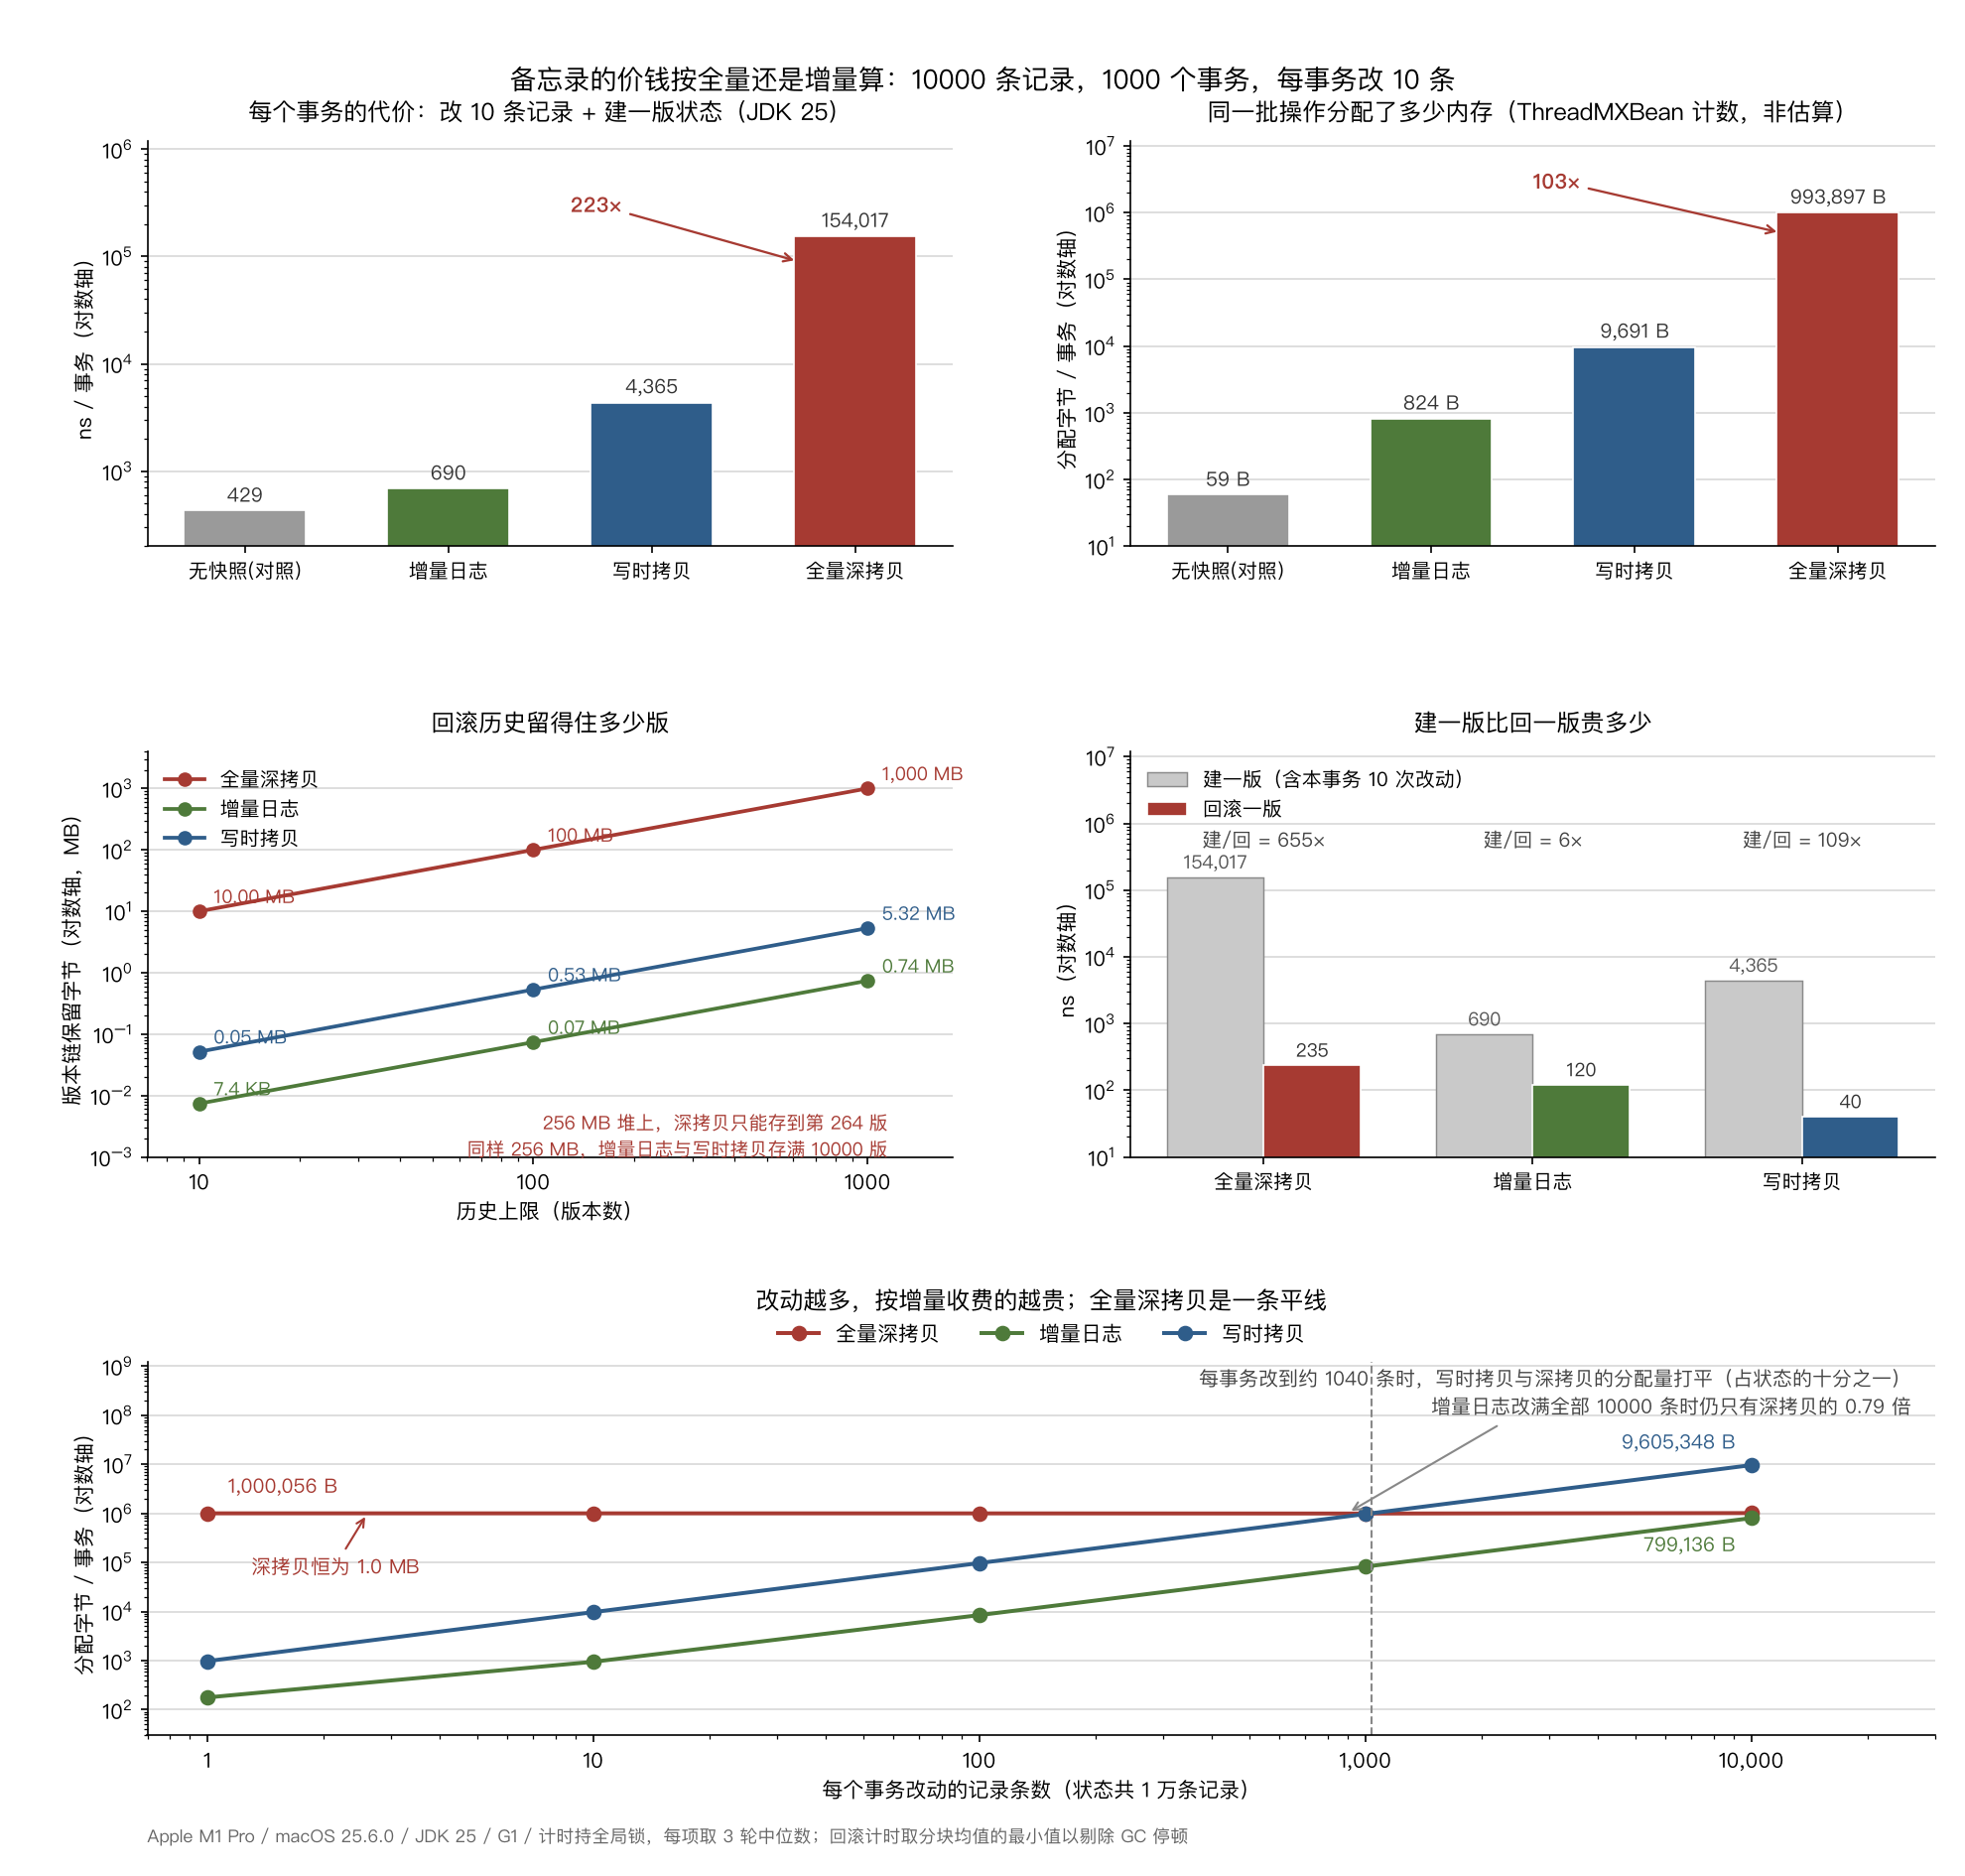
223 倍
深拷贝每个事务 154,017 纳秒,增量日志 690 纳秒,相差 223 倍。分配字节 993,897 对 824,相差 1,206 倍。写时拷贝夹在中间:每事务 4,365 纳秒、9,691 字节,比增量日志贵 6.3 倍和 11.8 倍,比深拷贝便宜 35 倍和 103 倍。
两个 JDK 的数并排看,差异在几个百分点量级。深拷贝的快照耗时 152,544 对 145,824,上一轮跑出来是 147,023 对 148,639,符号两次相反,属于运行间的抖动。写时拷贝的改动耗时 4,299 对 3,907,两次运行方向一致,JDK 25 慢 10% 到 17%,原因没有追查。这三条路的价格由机制决定,JDK 21 到 25 没有改变任何一条的算法。
换成吞吐看:只做这 10 次改动,单线程每秒能跑约 233 万个事务;加一次全量深拷贝,掉到每秒约 6,500 个。154 微秒在数据库往返面前不算什么,在一次纯内存计算面前是 359 倍。
快照那一步不总是贵的那一步
单看 snapshot():深拷贝 152,544 纳秒,增量日志 136 纳秒,写时拷贝 66 纳秒。写时拷贝那 66 纳秒就是一次引用入栈。增量日志的 136 纳秒分两部分:写一个下标;历史上限到顶时搬移日志头部,截断最旧一版的 10 个条目、重算剩下 10 个版本的起点,上限 10 版意味着每 10 个事务触发一次。
省下的代价没有消失,它出现在改动一侧。对照行说明改动本身有多便宜:不做任何快照时,同一批 10 次改动只要 387 纳秒、59 字节。增量日志把改动推到 554 纳秒、824 字节,多出来的部分是 10 个日志条目加 6 份标签列表副本。写时拷贝把改动推到 4,299 纳秒、9,691 字节,其中 8,720 字节是 10 次路径复制(每次 872 字节),剩下的是 10 条新记录和 6 份新标签列表。
选路之前先看清自己的负载:读多写少,把代价放在写侧更划算;一次事务改几千条,深拷贝反而合适。
只有一条路的分配量进得了 GC 的视野
1000 个事务跑完,深拷贝分配 993,897,000 字节,约 948 MiB。G1 每轮收集 2 到 3 次,5 到 8 毫秒。另外两条路 1000 个事务合计分配 0.82 MB 和 9.7 MB,一轮下来 GC 次数是 0。
948 MiB 不是常驻内存,因为版本上限是 10,链上只留 10 份。分配量本身仍然是代价:994 KB 的复制占了快照耗时的主要部分,同时把年轻代快速填满,对象成批进入老年代。
代价随改动条数怎么变
固定 1 万条记录,把每事务的改动条数从 1 扫到 10,000(40 个事务,只数分配字节)。两个 JDK 的数相差不到 0.1%,分配计数由算法决定,与 VM 版本无关:
| 每事务改动条数 | 全量深拷贝 | 增量日志 | 写时拷贝 |
|---|---|---|---|
| 1 条 | 1,000,056 B | 177 B | 973 B |
| 10 条 | 999,832 B | 944 B | 9,699 B |
| 100 条 | 997,874 B | 8,432 B | 96,919 B |
| 1,000 条 | 991,312 B | 81,868 B | 968,165 B |
| 10,000 条 | 1,012,014 B | 799,136 B | 9,605,348 B |
改动 1 条和改动 10,000 条,全量深拷贝都分配 1.0 MB,两次的差异来自标签列表长度的分布,在 ±1% 以内。它是一条平线,高度由记录总数决定,与这一版改了多少无关。
增量日志每改一条花 80 到 177 字节,写时拷贝每改一条约 960 到 970 字节。两条直线斜率不同,交点就落在不同的地方:
- 写时拷贝与深拷贝在每事务约 1,040 条改动处打平,占 1 万条状态的一成。改得比这更多,按需复制比整份复制更贵:10,000 条改动时它分配 9.6 MB,是深拷贝的 9.5 倍。
- 增量日志在 1 万条这个规模上没有交点。改满全部 10,000 条时它分配 799,136 字节,是深拷贝的 0.79 倍。代价转移到回滚侧:这一版的日志里有 10,000 个条目,回滚要重放 10,000 次。
一次事务改掉状态的一成以上,写时拷贝的「按需」优势就消失了。
四、实测二:历史深度换内存
| 历史上限 | 全量深拷贝 | 增量日志 | 写时拷贝 |
|---|---|---|---|
| 10 版 | 10.0 MB | 7.4 KB | 51.7 KB |
| 100 版 | 100.0 MB | 74.0 KB | 531.6 KB |
| 1000 版 | 1,000.1 MB | 740.0 KB | 5.3 MB |
(MB 按 10⁶ 字节计。核算口径:版本链在活状态之上多保留的字节。)
每版的成本是常数,与事务里改了几条无关:深拷贝 1,000,072 字节,增量日志 740 字节,写时拷贝 5,316.5 字节。深拷贝是增量日志的 1,351 倍,是写时拷贝的 188 倍。(深拷贝这个数与第三节表里的 993,897 字节差 0.6%,两次的标签列表长度分布略有不同。)
后两个数可以对上账。一个事务 10 次改动,改名字和改数量各 2 次,每次一个 40 字节的日志条目(存旧字符串引用或旧 long);剩下 6 次碰标签,每次除条目外还要复制一份旧标签列表,56 字节(ArrayList 对象 24 字节加底层数组 32 字节,3 个元素和 4 个元素对齐到同一大小)。4 × 40 + 6 × 96 = 736 字节,加上版本起点在 int[] 里占的 4 字节,正好 740。
写时拷贝的账是另一组加法:10 次改动各复制一次分块与根数组,实测 872 字节一次,合计 8,720;10 条新记录 400 字节;6 份新标签列表 528 字节。三项合计 9,648,占实测每版 9,706 字节的 99%。
用户说「要能回滚到 30 天前」,这句话翻译成内存预算就是这段时间里每次提交各留一份状态。每天 1000 次提交、每次 1 MB,一天 1 GB,30 天 30 GB。同样一条历史换成增量日志,按每事务 740 字节算是 22 MB。
用 System.gc() 前后的堆占用差值交叉验证 depth=1000 这一行:深拷贝 996.06 MB,增量日志 733,144 字节,写时拷贝 5,209,960 字节。三个数与核算值相差在 12% 以内,误差来自 GC 后的碎片与测量本身的抖动。深拷贝那个 996 MB 与核算的 1,000 MB 差 0.4%。
256 MB 堆装得下多少版
| 堆上限 | 全量深拷贝 | 增量日志 | 写时拷贝 |
|---|---|---|---|
| 256 MB | 第 264 版 OutOfMemoryError | 10,000 版正常 | 10,000 版正常 |
| 512 MB | 第 534 版 OutOfMemoryError | 未测 | 未测 |
| 1024 MB | 1,000 版刚好装下 | 未测 | 未测 |
264 乘 1 MB 约 264 MB,534 乘 1 MB 约 534 MB,比例线性。同样 256 MB 的堆,增量日志和写时拷贝都建满了 10,000 版,因为它们的版本链加起来还不到 1 MB 和 50 MB。
这是全量深拷贝最硬的限制:堆上限直接换算成历史深度上限,换算比例是一版一份完整状态。产品需求里的「保留 30 天」在这个换算下等于「30 天内每次提交的状态都留在内存里」。
五、实测三:回滚的代价
| 路径 | 回滚一版 ns(JDK 25 / 21) | 回滚整条 1000 版 |
|---|---|---|
| 全量深拷贝 | 235 / 255 | 235 µs |
| 增量日志 | 120 / 202 | 120 µs |
| 写时拷贝 | 40 / 41 | 40 µs |
三条路的回滚都在 1 微秒以内,最大差距 6 倍。对比建一版的差距(见图右下角),回滚快慢不是选型依据。depth=10 和 depth=100 的回滚循环太短,JIT 来不及编译,那两档的数不可比,这里只列 depth=1000。
回滚之后还能再回滚吗
深拷贝的 live = history.remove(history.size() - 1) 把那一版从链上摘下来当活状态用。之后的任何改动都会写进这份副本,链上再没有干净的第 N 版。要同时保留它,就得再拷一份,也就是再付 152 微秒和 994 KB。
增量日志不同:重放不改动日志条目本身。本文的实现顺手把日志截断了,保留条目、只移动游标同样可行,代价是一个 int。
写时拷贝不用再复制一份。版本不可变,root = history.pop() 之后链上每一版都还在,反复回到同一版不花额外代价。
回滚之后再编辑
带撤销的编辑器通常还有重做。用户撤销三步再输入一个字,重做栈就该清空。这条规则对三条路的影响不同:
深拷贝路径上,回滚换回来的那份副本就是活状态,用户接着输入的第一个字符会写进这份副本,链上原本干净的第 N 版随之消失。想保留它,复制就得挪到回滚那一刻,152 微秒和 994 KB 再付一次。undo/redo 栈常见的「撤销后一编辑就丢失全部重做记录」,成本上的原因就在这里:要么复制,要么丢弃。
增量日志和写时拷贝没有这个分叉。日志条目留在原地,游标往后挪一格就是重做;写时拷贝把旧根引用留在另一个栈里,重做就是把根换回去。
回滚的规模
回滚一版的成本和历史深度无关,回滚整条的成本随深度线性增长(见上表最后一行)。需要「回到任意一版」的界面要把版本列出来,贵的是为每一版存一个可读的摘要:校验和或时间戳,几百字节;摘要要从状态里现算时,又变成一次 O(N) 遍历。
六、JDK 源码里的快照原语
全量复制最终落在 System.arraycopy
JDK 里最短的一次浅拷贝是 ArrayList.clone():
1 | /* java.base/java/util/ArrayList.java:343-353(JDK 25) */ |
(JDK 21 同一段在 ArrayList.java:342-351,Arrays.copyOf 那行在 :345。)
Arrays.copyOf 只做一次转调:Arrays.java:3477-3479 的 copyOf(T[], int) 返回 copyOfRange(original, 0, newLength, original.getClass()),复制本身发生在 Arrays.java:3801-3813 的 copyOfRange 里:
1 | /* java.base/java/util/Arrays.java:3801-3813(JDK 25) */ |
System.arraycopy(:3810)是 intrinsics,复制 1 万个引用很快。贵的是它前面那行分配。JDK 21 的对应位置是 Arrays.java:3481 与 :3805,System.arraycopy 在 :3813,四行代码一字不差。
clone() 复制的是引用,1 万条记录的外层数组是 40 KB,元素对象仍由两个列表共享。本文的 MRow.copy() 连元素一起复制,1 万条 = 960 KB 记录对象加约 40 KB 外层数组,实测一次全量快照 1,000,240 字节。这个差额就是「共享元素」与「独占元素」的分界,也解释了为什么 clone() 在可变对象上不构成快照。共享可变对象是另一类问题的来源,边界在不可变与防御性拷贝那一篇里。
copyOfRange 里那个三元表达式还有一层:目标类型是 Object[] 时直接 new Object[newLength],否则走 Array.newInstance 反射创建。ArrayList.clone() 传进来的正是 Object[],走前一个分支。
ArrayList(Collection) 的构造里能看到同一次判断,ArrayList.java:181-193:来源本身是 ArrayList 时,toArray() 得到的数组直接接管(elementData = a),来源是别的集合类型时才多复制一次。
同样 1 万个状态,BitSet 只要 1.3 KB
1 | /* java.base/java/util/BitSet.java:1097-1109(JDK 21 与 25 行号相同) */ |
1 万个状态位是 157 个 long,words.clone() 一次复制 1,296 字节(实测分配量,含 BitSet 对象与长数组)。同一批 10,000 个状态换成记录对象,一次深拷贝是 1,000,040 字节。字节差 772 倍,时间差 197 倍(562 纳秒对 110,933 纳秒,JDK 25,同一次运行、同样预热 200 轮之后)。JDK 21 上这两个数是 817 纳秒对 179,487 纳秒,比例相近。
clone() 前面还有一步条件裁剪:sizeIsSticky 为假时先跑 trimToSize()(BitSet.java:1116-1121),把 words 收成 wordsInUse 那么长再复制。本文的位图用 new BitSet(10000) 构造,sizeIsSticky 为真(:167),走的是不裁的分支,所以复制的是一个满长度的长数组。
状态能用位图或稀疏结构表示时,快照的价格与记录数量脱钩,这比选哪条快照路径更值钱。
JDK 自己的写时拷贝
CopyOnWriteArrayList 的写侧是 O(N) 复制,读侧拿到的是共享的不可变数组:
1 | /* java.base/java/util/concurrent/CopyOnWriteArrayList.java:468-477(JDK 25) */ |
(JDK 21 同一段在 :461-471。)每次写都换一个新数组,迭代器拿着旧数组继续走,不受后续写入影响。这是「写方付全量、读方零成本」的取舍,跟第三节里写时拷贝路径的取舍同源,只是它把代价放在整个数组上,没有分块。
不可变值可以零成本共享
1 | /* java.base/java/lang/String.java:144 */ |
类与底层数组都声明为 final,javadoc 第 73 行写着 Strings are constant; their values cannot be changed after they are created.,紧跟着一句 Because String objects are immutable they can be shared.。本文三条路径都只复制 name 的引用,不复制字符串内容,靠的就是这一条。
ImmutableCollections.listCopy 把这条规则推到了集合上:
1 | /* java.base/java/util/ImmutableCollections.java:185-193(JDK 25) */ |
输入已经是不可变列表时,:186-187 直接返回同一个实例。实测:List.copyOf(已是不可变列表) 分配 0 字节,List.copyOf(可变的 3 元素 ArrayList) 分配 88 字节。写时拷贝路径的每一条新标签列表都用 List.copyOf 生成,之后所有版本共享它。
不可变带来的共享有边界。StringLatin1.newString(java.base/java/lang/StringLatin1.java:756-762,JDK 21 在 :748)里,substring 仍然要 Arrays.copyOfRange 复制字节,共享的是引用,不是任意切片。可共享的前提是值本身不变。
七、什么时候用哪条
    graph TD
    A["需要回到历史某一版吗"] -->|不需要| A1["不引入备忘录<br/>对照成本:59 字节、429 纳秒每事务"]
    A -->|需要| B{"状态能不能表示成不可变结构"}
    B -->|"能,且改动集中"| B1["写时拷贝 + 结构共享<br/>9.7 KB / 事务,每版 5.3 KB"]
    B -->|"能,但状态是位图或计数"| B2["直接克隆位图<br/>1 万位 = 1.3 KB,与记录数脱钩"]
    B -->|不能| C{"历史上限大概多少版"}
    C -->|"几十版,回滚不频繁"| C1["全量深拷贝<br/>994 KB / 事务,实现最简单"]
    C -->|"几百上千版"| C2["增量日志<br/>824 B / 事务,按改动数收费"]
    C -->|"上千版且回滚要可重复"| B1
什么时候不用备忘录
不需要回滚时,同一批操作只要 59 字节和 429 纳秒(对照行)。为一次「也许以后有人想撤销」引入版本链,等于给每个事务加上 0.82 KB 到 994 KB 的固定成本。先确认回滚是需求,再选实现。
判断顺序
- 先把状态压小。 能表示成位图、计数器、稀疏映射的状态,快照价格与记录总数脱钩。1 万个状态位用
BitSet克隆是 1.3 KB,用记录对象深拷贝是 1 MB。 - 再问历史深度和写读比例。 几十版加低频回滚,全量深拷贝最省事,994 KB 的一次复制在每秒几次的事务面前无所谓。上千版历史,或者事务频率高,深拷贝的内存会先爆:256 MB 堆上只能存 264 版。
- 然后看改动密度。 一个事务改 10 条时增量日志每版 740 字节,深拷贝 1,000,072 字节。事务改掉整个数据集的一多半时,增量日志的条目数逼近全量,优势消失。
- 最后看回滚的使用方式。 只允许「撤销最近一步」,深拷贝的消费式回滚够用;要能反复回到同一版,或者要看到完整的版本列表,选版本不可变的那条路。
- 把登记代码算进成本。 增量日志最便宜,但它要求每一次状态改动都登记旧值,漏一处就丢一次回滚。本文的三段实现是 27 行、54 行、89 行,行数差距全在登记与恢复的分支上。
- 改动密度没有量级之前,先选保守的。 本文里最深的一条价差是 1,351 倍,最浅的一条是 4.8 倍。改动密度、事务频率、历史深度这三个数一旦有数量级上的把握,选型就定了;都还没量过时,按记录数上限估一笔最坏情况,比事后换实现便宜。
总结
- 三条路径的价格相差两个数量级:1 万条记录、每事务改 10 条时,全量深拷贝 154,017 纳秒和 993,897 字节,增量日志 690 纳秒和 824 字节,写时拷贝 4,365 纳秒和 9,691 字节(JDK 25,中位数)。对照行(不做快照)是 429 纳秒和 59 字节。
- 快照这一步的价格:深拷贝 152,544 纳秒,增量日志 136 纳秒,写时拷贝 66 纳秒。便宜的那两条把代价移到了改动侧:增量日志的改动从 387 涨到 554 纳秒,写时拷贝涨到 4,299 纳秒。
- 每版保留字节是常数:深拷贝 1,000,072 字节,增量日志 740 字节,写时拷贝 5,316.5 字节。1000 版对应 1,000.1 MB、740 KB、5.3 MB。
- 代价随改动条数变化:每事务改 1 条时,深拷贝 1,000,056 字节、增量日志 177 字节、写时拷贝 973 字节;改 10,000 条时,三者分别是 1,012,014、799,136、9,605,348 字节。写时拷贝与深拷贝在每事务约 1,040 条改动处打平,占 1 万条状态的一成。
- 256 MB 堆上,全量深拷贝建到第 264 版 OutOfMemoryError,512 MB 到第 534 版,1 GB 刚好装下 1000 版。同样 256 MB,增量日志与写时拷贝建满 10,000 版。
- 回滚一版:深拷贝 235 纳秒,增量日志 120 纳秒,写时拷贝 40 纳秒(depth=1000,分块取最小值)。三条路都低于 1 微秒,不是选型依据。
- 深拷贝的回滚是消费式的,那一版成了活状态,想保留就得再付一次全量复制。增量日志的条目可以保留只移动游标,写时拷贝的版本不可变,两者都能反复回滚到同一版。
ArrayList.clone()(ArrayList.java:343-353)只复制引用,Arrays.copyOf落到copyOfRange(Arrays.java:3801-3813)里的System.arraycopy加一次数组分配。深拷贝与浅拷贝的价格差在「元素对象归谁独占」。BitSet.clone()(BitSet.java:1097-1109)复制 1 万个状态位只要 1,296 字节、562 纳秒,同样 10,000 条记录深拷贝要 1,000,040 字节、110,933 纳秒。状态表示比快照策略更值钱。ImmutableCollections.listCopy(ImmutableCollections.java:185-193)对已经是不可变的输入直接返回同一实例,实测List.copyOf(已是不可变列表)分配 0 字节。不可变是零成本共享的前提,String的final class与private final byte[] value是同一件事。
参考资料
- Memento (refactoring.guru)
- Memento pattern (Wikipedia)
- ArrayList (Java SE 25)
- Arrays (Java SE 25)
- BitSet (Java SE 25)
- List.copyOf (Java SE 25)
- CopyOnWriteArrayList (Java SE 25)
- String (Java SE 25)
- ThreadMXBean.getThreadAllocatedBytes (Java SE 25)
- System.arraycopy (Java SE 25)
系列索引:设计模式系列