设计模式——观察者:从 Observable 到背压
观察者模式在代码层面只有十几行:一个注册表,一次遍历回调。
订阅者比发布者快时,这个形态没有可测的代价;慢订阅者占住的是发布者的线程。
JDK 1.0 给了Observable,JDK 9 把它废弃,同一个版本里给出Flow:四个接口,补上的那一块是Subscription.request(long)。
一、228 行的废弃类
java.util.Observable 从 JDK 1.0 就在。JDK 25 的 src.zip 里它还在,228 行,第 75 行写着:
1 |
|
两个 LTS 过去了,JDK 一直没把它移除。javadoc 给的理由(java.base/java/util/Observable.java:62-74):
1 | * |
三条理由:事件模型能力有限、通知顺序未指定、状态变化与通知不是一一对应,都与性能无关。最实际的是最后一条:setChanged() 与 notifyObservers() 是两次调用,中间可以插入任意多次状态修改,订阅者收到通知后要自己回到 Observable 上读状态,读到哪个版本取决于时序。多线程下这个窗口没有上界。
JDK 9 同时做了两件事:JEP 266(More Concurrency Updates)引入 Flow,JDK-8154801 废弃 Observable。JEP 对这套接口的定位:
Communication relies on a simple form of flow control (method
Subscription.request, for communicating back pressure) that can be used to avoid resource management problems that may otherwise occur in “push” based systems.
推模式会带来资源管理问题,request 是沟通背压的通道。本文要测的就是这句话。废弃走的是 JDK-8154801,描述里多了一句源码 javadoc 没写的话:
There are also some thread-safety and sequencing issues that cannot be fixed compatibly.
替代品是 java.util.concurrent.Flow,只有四个接口和一个常量:
1 | public static interface Publisher<T> { public void subscribe(Subscriber<? super T> subscriber); } |
Flow 是 Reactive Streams 规范在 JDK 里的落地,只规定接口,不带实现。JDK 自己给了一个实现:SubmissionPublisher。先看观察者模式的代码。
观察者模式在代码层面只有 12 行
1 | final List<Consumer<Long>> observers = new ArrayList<>(); |
发布者不知道订阅者是谁、有几个、在做什么,模式换来的解耦就是这些。Observable 在 1996 年的实现和这 12 行同构,只多了 Vector 和 synchronized:
1 | // java.base/java/util/Observable.java:79, :96, :129 |
通知逻辑在 notifyObservers(Object)(:147)里,它做三件事:检查 changed 标志、在锁内把 Vector 快照成数组、在锁外倒序回调。
1 | // java.base/java/util/Observable.java:167-174 |
每次通知都分配一个数组。回调顺序是插入顺序的倒序(顺序未指定,源码里就是倒着走)。notifyObservers 调用前没有 setChanged() 就什么都不发。这些细节 javadoc 里都能查到,但它们不构成废弃的理由,理由还是那三条。
Vector 同步的是注册表:多线程同时增删订阅者不会破坏内部数组,但流经这条链的数据它管不到。两件事都叫「线程安全」,但代价和效果不是一回事。
被推迟的三个问题
回调列表把三个问题留给了使用者:
- 节奏。什么时候发、发多少,由发布者单方面决定。订阅者只能在
accept里尽快返回,否则下一次调用立刻就来。 - 线程。
accept在发布者线程上执行。订阅者写文件、发网络请求、更新 UI,就等于把这些操作的耗时记在发布者头上。 - 容量与失败。没有队列就没有容量上限,也就没有「满了怎么办」。一个订阅者抛异常,循环中断,排在它后面的订阅者这一轮什么都收不到。
Flow 把第一条做成了接口(request(long n)),第三条做成了语义(缓冲、超时、丢弃回调),第二条留给 Executor。第二条决定了另外两条值多少钱,是本文实验的重点。
二、推模式缺的是流量控制
    sequenceDiagram
    participant P as 发布者
    participant S as 订阅者
    Note over P,S: 回调列表:调用发生在发布者线程上
    P->>S: onNext(1)
    activate S
    Note over S: 处理 1ms
    S-->>P: 返回
    deactivate S
    P->>S: onNext(2)
    activate S
    Note over S: 处理 1ms
    S-->>P: 返回
    deactivate S
    Note over P: 发布线程的时间<br/>被订阅者占满
    sequenceDiagram
    participant P as 发布者
    participant B as 有界缓冲
    participant C as 订阅者
    C->>P: request(64)
    Note over P: 只有需求内的条数会推过来
    P->>B: submit(x)
    Note over B: 缓冲满时 submit 阻塞,<br/>offer 丢弃
    B->>C: onNext(x) 异步投递
    C->>P: request(64) 补需求
    Note over C: 消费速度决定 request 的节奏
两张图的区别在谁决定节奏。上图里发布者按自己的速度推,订阅者要么跟上要么阻塞发布者;下图里订阅者用 request(n) 声明自己还能吃 n 条,发布者只在这个额度内推。
慢订阅者把发布线程占住,是个可测的量
朴素回调里,订阅者每条 sleep(1),发布 5000 条,发布线程被占用 7620.53ms,每条平均 1.52ms。数字里没有别的成分:发布者的循环时间等于订阅者处理时间之和。对应到真实系统里就是「日志上报的订阅者写磁盘慢,主流程卡在通知里」。
队列把问题从「卡住」变成「选择」
给这 12 行加一个有界队列,问题不会消失,只会变成三个选项:
| 策略 | 缓冲满时的行为 | 需要回答的问题 |
|---|---|---|
| 阻塞 | 发布者等 | 等多久,谁来决定 |
| 丢弃 | 发布者继续 | 丢哪些,丢多少算正常 |
| 无界 | 都不阻塞 | 内存到哪一步算满 |
SubmissionPublisher 把前两个做成了两个方法:submit 走阻塞,offer 走丢弃(超时可设 0)。Flow 的常量 defaultBufferSize() 返回 256,就是这三种选择共用的默认容量:
1 | // java.base/java/util/concurrent/Flow.java:304, :315 |
Flow 文档对这个数字的说明只有一句「在缺少其他约束时可用的默认值」,@implNote 补上「当前值是 256」。没有更多解释,也没有公式。第五节用实测说明它的用法。
request(n) 的语义
需求是累加的,并且饱和:
1 | // java.base/java/util/concurrent/SubmissionPublisher.java:1252-1264 |
request(Long.MAX_VALUE) 就是「不用管我,能推多少推多少」。request(0) 和负数按规范报错。Processor 上下游可以各自有独立的需求计数。
三、实验设计与局限
- 机器:Apple M1 Pro(
hw.ncpu打印 10),macOS Darwin 25.6.0,arm64 - JDK:
21.0.8+12-LTS-250与25+37-LTS-3491,各跑一遍 - 对象:单发布者、单订阅者。比较朴素回调列表、
Observable形状(synchronized+Vector枚举)、SubmissionPublisher - 每轮新起 JVM,快路径三轮取中位数,慢路径(每条 sleep 1ms)一轮;计时用
System.nanoTime() - 所有计时循环在全局锁内执行,避免同一台机器上并行的其他基准抢 CPU
- 计时精度先量过:一次「取
nanoTime再取一次」的空操作对,稳定后平均 16ns,p50 为 0ns,换算下来单个计时器有约 8ns 的读数成本。本文里两位数的纳秒差不要当真,只读数倍以上的差别 - 订阅者每条
Thread.sleep(1)在 macOS 上的实际粒度是 1.51ms(含一次投递与一次取走的开销),不是 1.000ms
本机没有 JMH,这里也不是那种带 fork、死代码消除防护的正式基准。这套数字只能支撑量级判断和结构解释,不能当作吞吐上限。另外 SubmissionPublisher 默认用 ForkJoinPool 的公共池投递(下一节有出处),订阅者回调跑在池线程上,同一台机器上 20 多个并行实验会给调度带来抖动,快路径跑三轮取中位数就是为了压住这部分抖动。
四、实测一:快订阅者身上,背压机器没有收益
第一组:订阅者什么都不做,只累加一个 long(防死代码消除用),发布 10 万条。三种发布方式,两个 JDK,三轮中位数:
| 发布方式 | 吞吐 JDK 21 | 吞吐 JDK 25 | 每项总耗时 JDK 21 / 25 |
|---|---|---|---|
回调列表(ArrayList,发布线程直调) |
27.13M 条/秒 | 71.92M 条/秒 | 36.9ns / 13.9ns |
synchronized 方法 + Vector 枚举 |
60.94M 条/秒 | 70.57M 条/秒 | 16.4ns / 14.2ns |
SubmissionPublisher.submit(入队到消费完) |
2.88M 条/秒 | 2.50M 条/秒 | 347.1ns / 399.3ns |
前两行的每项耗时是发布线程一次调用的时间;第三行是「入队加上另一个线程消费完」的端到端时间除以条数。
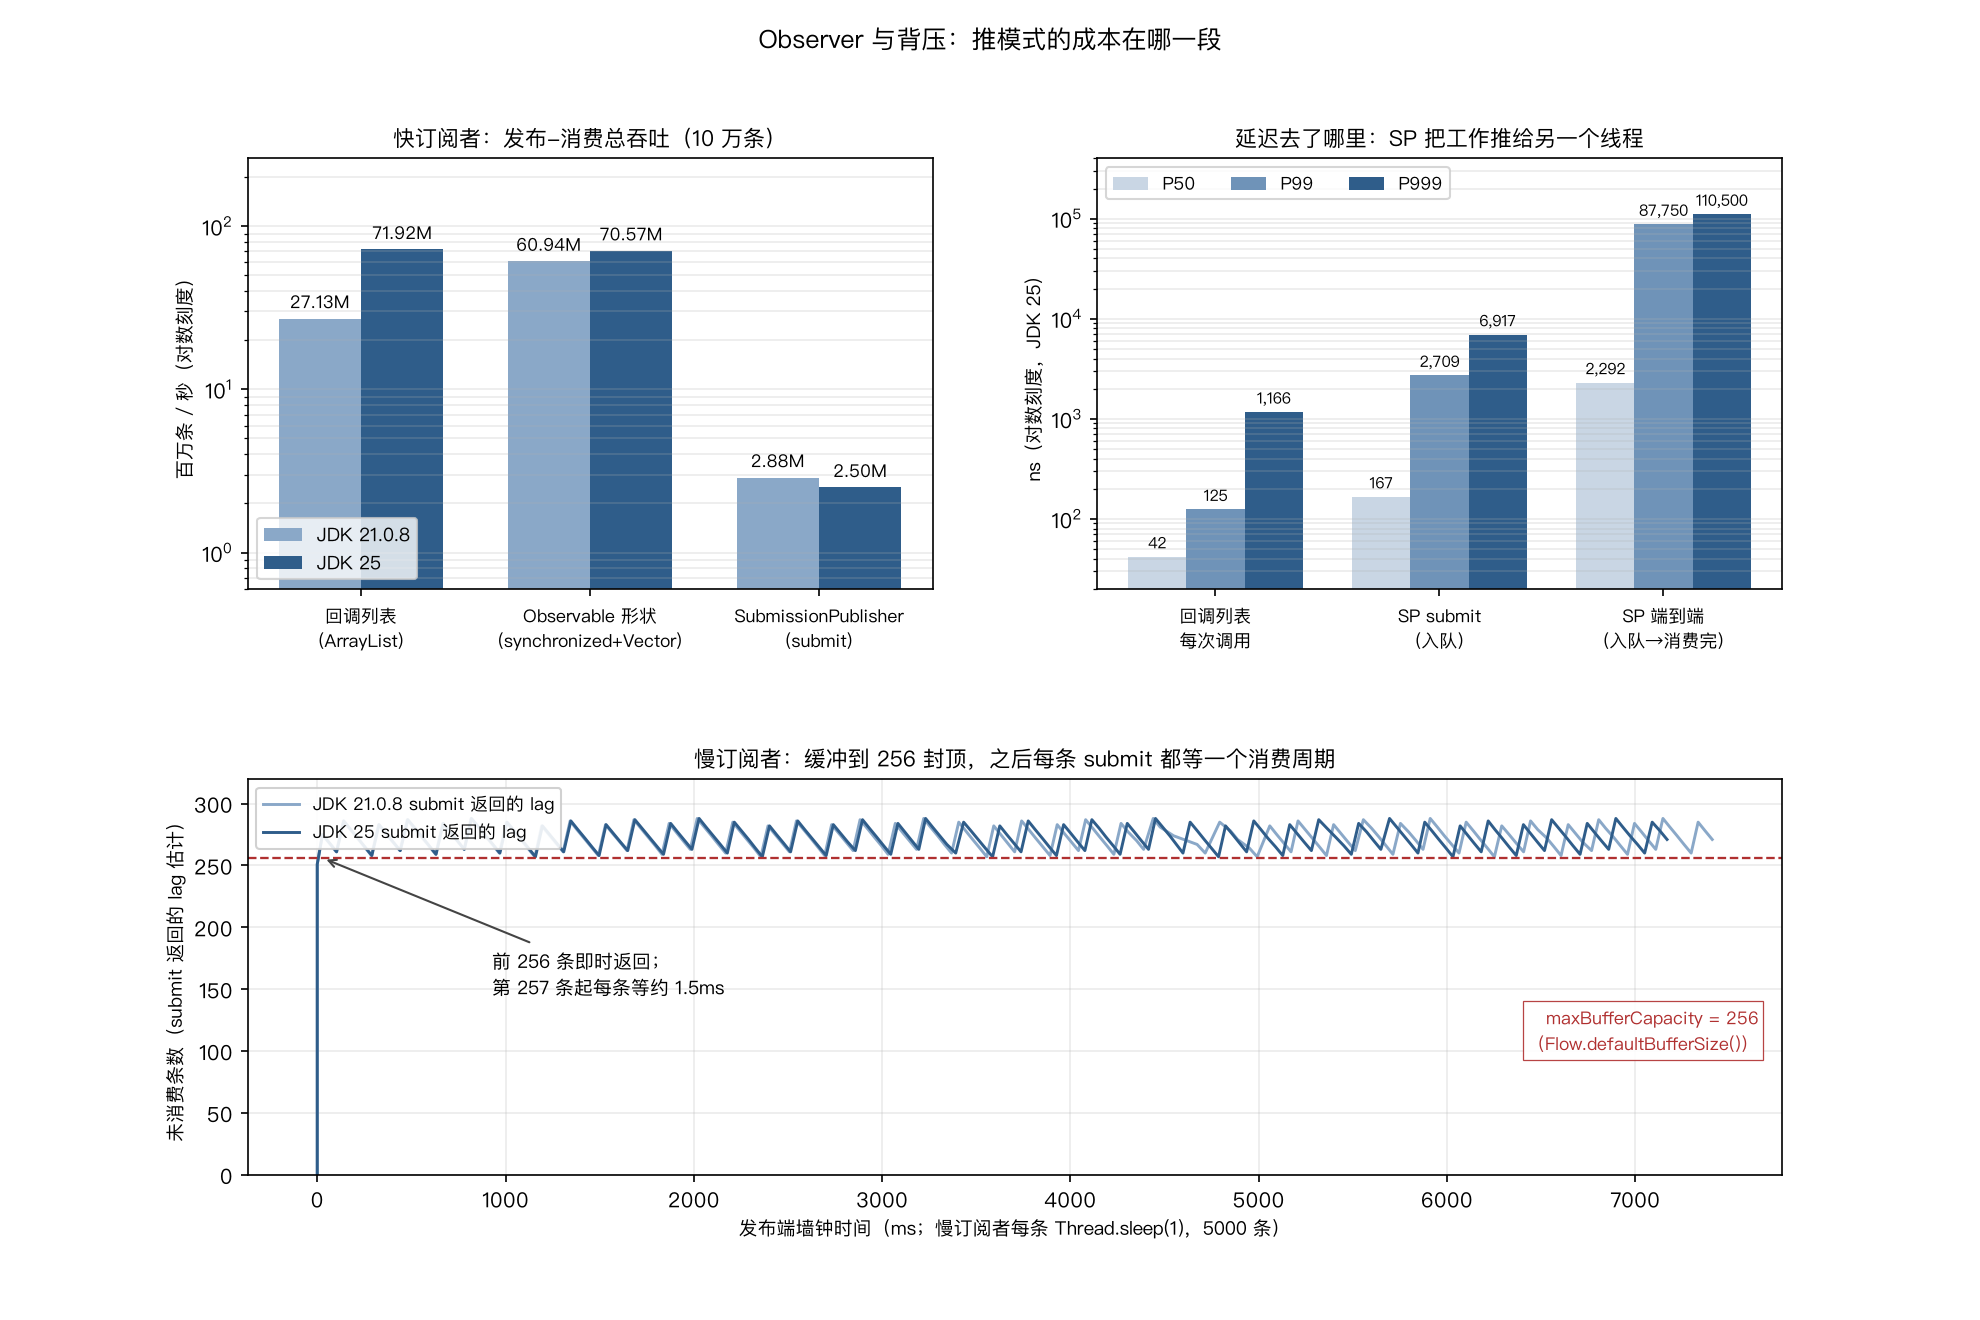
图有三块面板:左上对比三种发布方式的吞吐,右上是 JDK 25 上三种延迟的分位数,下方曲线来自下一节的慢订阅者实验,画的是缓冲占用随时间的变化。
三组数字的口径不同。
submit 每次入队要 167ns(JDK 25 中位),比直接回调的 13.9ns 贵一个量级。它只是往环形缓冲里放一个引用,代价来自原子写、消费者保活位的检查和缓存行争用,不来自订阅者的代码。
端到端吞吐差一个量级:回调列表 71.92M 条/秒,SubmissionPublisher 2.50M 条/秒(JDK 25),JDK 21 上是 27.13M 条/秒 对 2.88M 条/秒。这条链路上每一环都要跨一次线程边界:生产者写槽位、消费者原子取走、池线程被唤醒或自旋,onNext 最后才执行。直接回调只有一次虚调用。
延迟的分位数:
| 路径 | p50 | p99 | p99.9 | max |
|---|---|---|---|---|
| 回调列表,一次调用 | 42ns | 125ns | 1,166ns | 23.8µs |
submit,一次入队 |
167ns | 2,709ns | 6,917ns | 77.6µs |
| 端到端,入队到消费完 | 2,292ns | 87.8µs | 110.5µs | 177.7µs |
第一行含计时开销(见第三节的校准数字),行内比较可用,跨表跟绝对时间比要减掉那一份。端到端 p50 比入队那一步大一个量级:数据在缓冲里等另一个线程取走,这一段比投递长。异步化把延迟从发布者的关键路径上挪到了另一个线程的队列里。
synchronized + Vector 那一版在 JDK 25 上和裸 ArrayList 没有可分辨的差别(14.2ns 对 13.9ns)。JDK 21 上两者差 2.2 倍,快的反而是 Vector 版,原因见下一段。
JDK 21 上裸 ArrayList 那一轮是 36.9ns,比同一个循环在 JDK 25 上慢 2.7 倍,也比同样用 Vector 的写法(16.4ns)慢。三轮都是这样,不是抖动;但找不出模式层面的解释:两者做的工作一样,JIT 的 PrintInlining 日志里 lambda 和内联内容也一致。这一格记作本次测量的噪声上限:表里小于 2.5 倍的差异不作为结论。
每次通知分配多少字节
把分配字节数单独量一遍(ThreadMXBean.getThreadAllocatedBytes,发布线程,每条计数):
| 发布方式 | JDK 21 | JDK 25 |
|---|---|---|
回调列表(Consumer<Long>) |
24.0 B | 24.0 B |
synchronized + Vector 枚举 |
38.8 B | 8.0 B |
SubmissionPublisher.submit |
24.0 B | 24.0 B |
一个 Long 装箱正好 24 字节。Consumer<Long> 的调用点上,JDK 21 和 25 都没有消掉这次分配;Vector.elements() 的枚举器在 JDK 21 上每轮通知都会新建(多出 14.8 字节),JDK 25 上被消掉了。submit 的 24 字节逃逸分析救不了:对象要交给另一个线程,必须落在堆上。
订阅者快的时候,SubmissionPublisher 每一项指标都不如回调列表。256 条缓冲、需求计数、CAS、公共池调度,全是纯支出,下一组数据才用得上它们。
五、实测二:慢订阅者下的阻塞、缓冲与丢弃
第二组把订阅者改成每条 Thread.sleep(1)(本机实测一条约 1.51ms),发布 5000 条。三个变体:朴素回调、submit(缓冲满则阻塞)、offer(缓冲满即丢)。
| 发布方式 | 发布 5000 条耗时 JDK 21 / 25 | 发布线程状态 | 结果 |
|---|---|---|---|
回调列表,accept 内 sleep |
7650.74ms / 7620.53ms | 全程被占用(每项 1.52ms) | 5000 条全部送达 |
submit,默认缓冲 |
7445.32ms / 7206.17ms | 前 256 条即时返回,之后每项阻塞 1.51ms | 5000 条全部送达,总耗时由订阅者决定 |
offer(0),丢弃 |
15.14ms / 15.59ms | 几乎不占用 | 接受 266,丢弃 99734(99.734%) |
不 request,offer(50ms) |
— | 每条丢之前等满 50ms | 接受 256,丢弃 44 |
阻塞没有消失,只是换了位置
朴素回调:发布线程 5000 次 sleep,7620.53ms 全花在等待上。
submit:前 256 条即时返回,第 257 条开始阻塞。每项阻塞时长 p50 1.51ms、p99 1.98ms、最大 9.51ms。5000 条总耗时 7206.17ms,和朴素回调基本一致。
submit 没有让慢订阅者变快,它把「发布者被占住」从一段连续时间切成 4,744 次约 1.5ms 的等待。等待期间发布者同样做不了别的事,submit 是同步阻塞的。变的只有发布循环开头那 256 条:它们先进缓冲,发布者可以先走一段。
256 是从哪来的
SubmissionPublisher 的默认构造函数(java.base/java/util/concurrent/SubmissionPublisher.java:301):
1 | public SubmissionPublisher() { |
Flow.defaultBufferSize() 是 256,所以 maxBufferCapacity 是 256。缓冲的初始数组是 32:
1 | // :195 |
增长发生在每次投递时,容量翻倍直到上限(:1128、:1148):
1 | if (n >= cap && cap < maxCapacity) // resize |
缓冲从 32 涨到 64、128、256 就停了,稳态容量是 256。前 256 条投得下去,因为数组还在翻倍;第 257 条进来时缓冲已满,submit 走 retryOffer 里的 awaitSpace(:439、:1439),park 到消费者腾出一格才返回。第三块面板里的曲线画的就是这个过程:占用从 32 翻倍到 256,然后一直贴着上限走;发布端的墙钟时间也从每项几十纳秒变成每项 1.51ms。
丢弃策略下丢了多少
同一组参数把 submit 换成 offer(item, 0, NANOSECONDS, null),5000 条在 15.59ms 内全部投递完,其中 266 条进入缓冲,99734 条被丢弃,丢包率 99.734%。offer 的返回值是负的丢弃条数,正数则是投递后的 lag 估计,这个语义写在 javadoc 里。
丢包率由发布速度和消费速度的比值决定:发布者用 15.59ms 跑完 5000 条,订阅者在同样长度的时间里连 1 条都没处理完(一条 1.51ms)。发布速率降到订阅者处理速率以下时,丢包率自然归零。offer 的超时参数就是在这两个极端之间调。
没有 request 就没有消费
Flow.Subscriber 不调 request,一条数据都不会到订阅者手里。给一个从不 request 的订阅者用 offer(50ms) 投 300 条:接受 256 条,剩下 44 条各等满 50ms 后被丢弃。接受的条数正好是 256,和 Flow.defaultBufferSize() 的 256 以及上面的推导一致。
换成 submit,第 257 条会永久阻塞。用一个看门狗线程验证:发布线程跑 submit 循环,2 秒后它完成 256 条,状态 WAITING,submit 停在 LockSupport.park 上没有超时参数:
1 | // java.base/java/util/concurrent/SubmissionPublisher.java:1476-1478 |
阻塞路径还有一处设计:awaitSpace 在 park 之前先试一次帮助消费:
1 | // :1439-1448 |
这是给公共池线程的照顾:发布者跑在池线程上时,park 之前先去帮着跑消费任务,避免「生产者在等消费者、消费者没人跑」的死锁。用主线程当发布者时这段不生效。
六、实测三:request(n) 的粒度
第三组沿用快订阅者,发布 2 万条,只改 request 的粒度:request(1)(收到一条补一条)、request(64)(消费掉一半时补 32)、无界(Long.MAX_VALUE)。
| 需求粒度 | 条数 | 吞吐 JDK 21 / 25 | 每项端到端 p50 / p99 JDK 25 | 每项 submit JDK 25 |
|---|---|---|---|---|
request(1) |
2 万 | 1.84M 条/秒 / 1.64M 条/秒 | 8,083ns / 310.6µs | 375ns |
request(64),半量补货 |
2 万 | 2.19M 条/秒 / 1.40M 条/秒 | 3,041ns / 51.3µs | 416ns |
| 无界 | 10 万 | 2.88M 条/秒 / 2.50M 条/秒 | 2,292ns / 87.8µs | 167ns |
无界那一行就是实测一的 SubmissionPublisher 组,条数一致,可以直接跟上面两张表对照。
无界那一行在 JDK 21 和 25 上都是最快的,也是唯一方向一致的一行。request(1) 和 request(64) 之间没有稳定方向:JDK 21 上 64 更快(2.19M 条/秒 对 1.84M 条/秒),JDK 25 上反过来(1.64M 条/秒 对 1.40M 条/秒),四组数字都落在 1.4M 到 2.2M 条/秒之间。按第三节定的噪声上限(2.5 倍),1 和 64 的吞吐差测不出来。能测出来的只有延迟:request(1) 每项端到端 p50 8,083ns,request(64) 是 3,041ns;p99 分别是 310.6µs 和 51.3µs。需求只给 1 条时,等待变成一条一条的往返。
Flow 的 javadoc 对粒度的建议是这么写的(java.base/java/util/concurrent/Flow.java:112-115):
… where a buffer size of 1 single-steps, and larger sizes usually allow for more efficient overlapped processing with less communication; for example with a value of 64, this keeps total outstanding requests between 32 and 64.
例子里的 SampleSubscriber 就是 request(64)、消费一半时再 request(32) 的写法。粒度换来的是「通信次数」:每次 request 都要在订阅端做一次 CAS 并可能启动一个消费任务。
需求决定消费任务能不能活着
需求还在时,消费任务不会退出。consume() 是一个循环,只有「缓冲空且需求为 0」才走退出分支(:1296-1299):
1 | else if (empty || d == 0L) { |
ACTIVE 是保活位(:1057),run 里的注释解释了它的用途(:991-994):保住一致性要付的原子操作「比每条都起一个任务还是便宜多了」。需求断了之后(request(1) 让在途需求只有 1 条,缓冲一空消费任务就退出循环),下一次 submit 需要重新起一个消费任务(:1204、:1191 的 startOnOffer),任务调度就摊到了每一条数据上。本次测量里 request(1) 每项 608.2ns,无界每项 399.3ns,相差 1.5 倍。
消费者一侧也按块吃
请求到达发送端后,消费任务的循环一次也不会只取一条(:1314-1318):
1 | final int takeItems(Subscriber<? super T> s, long d, int h) { |
一次最多取 cap/8+1 条,剩下的留给下一轮。这么切是为了不让一个消费者长时间霸占 CPU。SubmissionPublisher 里还有一句注释直接关系到 request(1) 的代价(:991-994):
(Maintaining agreement about keep-alives requires most atomic updates to be full SC/Volatile strength, which is still much cheaper than using one task per item.)
「比每条都起一个任务还是便宜多了」是 JDK 作者对细粒度需求的评价。本次测量里 request(1) 每项 608.2ns,request(64) 每项 715.0ns,无界每项 399.3ns。
七、结论
什么时候用 Flow / SubmissionPublisher
三种情况下这笔成本值得花:
- 订阅者的速度不受发布者控制。写磁盘、发网络、调用第三方接口,或者订阅者根本不在同一个进程里。
- 需要过载语义。
offer的返回值是丢包数,submit的阻塞有明确的阻塞点,缓冲上限可配置。回调列表对这三种情况一个都没回答。 - 发布与消费本来就在两个线程上,或者需要把背压信号继续往上游传(
Processor链)。
在这三种情况里,Flow 买到的是「发布者的执行时间不再由最慢的订阅者决定」。第五节的数字:慢订阅者每条 1.51ms 时,回调列表让发布线程 5000 项全部卡住;submit 让前 256 项先走,之后每项阻塞一次 1.51ms,发布线程仍然被占,但至少在缓冲长度内可以先行。
什么时候不用
- 订阅者确定快,且和发布者在同一线程。这时回调列表是 71.92M 条/秒 对 2.50M 条/秒,一个量级。
- 需要严格同步的顺序和立即可见的副作用。
submit之后的onNext发生在池线程上,调用返回时订阅者还没处理。 - 需要异常立刻冒泡到发布者。
SubmissionPublisher把订阅者的异常交给onNextHandler,默认只是打日志。 - 只是想解耦「谁被通知」。这 12 行的模式就够了,
Flow不会让它更快,只会多出一层接口。
不想用 Flow 时,自己写多少行
单发布单订阅、不组 Processor 链、不进响应式生态,一个带容量和丢弃策略的推模式实现大概这么大:
1 | final class BoundedPush<T> { |
它和 SubmissionPublisher 回答的是同一组问题:容量多大、满了阻塞(q.put)还是丢弃(q.offer)、丢了多少怎么记。它缺的是需求信号。队列长度是事后结果:订阅者快时空转,慢时积压,发布者看不出「消费者现在能接多少」。request(n) 把这件事从「事后观测队列长度」变成「事前声明上限」,多出来的复杂度买的就是这个。
与相邻模式的边界
观察者与责任链的差别在「能不能拦下」:观察者向所有订阅者广播,每个订阅者独立处理,没有终止传播的机制;责任链沿一条链传递,某一环可以停止(见责任链)。中介者把 N 对 N 的通信收进中心节点,观察者是 1 对 N 的广播,订阅者之间互不知道(见中介者)。request(n) 这一侧,在同步世界里对应的是 Iterator.hasNext():都是消费者决定何时取下一项,区别是 request 允许提前批量声明,hasNext 只能一次一问(见迭代器)。
一条判断顺序
    flowchart TD
    A{"发布者和消费<br/>在同一线程吗"} -->|是| B{"最慢的订阅者<br/>单次耗时"}
    A -->|否| E["Flow + 有界缓冲"]
    B -->|"微秒级及以下"| D["回调列表直接调用"]
    B -->|"毫秒级或不可控"| E
    E --> F{"缓冲满了<br/>能丢数据吗"}
    F -->|不能丢| G["submit 阻塞<br/>需要独立的发布线程"]
    F -->|能丢| H["offer 超时 0<br/>记录返回的丢包数"]
    G --> I{"订阅者会<br/>request 吗"}
    H --> I
    I -->|不会| J["先修订阅者<br/>不 request 就没有消费"]
    I -->|会| K{"request 粒度"}
    K -->|"1 每条一次通信"| L["吞吐降到第<br/>六节 request(1) 那一行"]
    K -->|"几十:半量补货"| M["Flow 文档示例的 64/32"]
总结
java.util.Observable在 JDK 25 的src.zip里仍然是 228 行,第 75 行@Deprecated(since="9")。废弃理由是事件模型有限、通知顺序未指定、状态变化与通知不是一一对应,三条都与性能无关。- 同一个 JEP(266)引入的
Flow只有四个接口,多出来的那块是Subscription.request(long)。它是推模式里唯一能让消费者影响生产者节奏的通道。 - 快订阅者(10 万条,纯累加):回调列表 71.92M 条/秒,
synchronized方法 +Vector枚举70.57M 条/秒,SubmissionPublisher.submit2.50M 条/秒,JDK 25。订阅者快的时候,背压机制没有任何收益,还多出跨线程交接的延迟。 - 入队也不便宜:
submit每次 167ns,比直接回调的 13.9ns 贵一个量级(JDK 25 中位)。端到端延迟再抬一个量级,p50 2,292ns、p99 87.8µs。 - 慢订阅者(每项 1ms):回调列表把发布线程占满 7620.53ms;
submit前 256 项即时返回,之后每项阻塞 1.51ms(p50),总耗时 7206.17ms。发布线程仍然被占住,只是阻塞点在缓冲满之后。 - 默认缓冲 256 =
Flow.defaultBufferSize()(Flow.java:304、:315),由SubmissionPublisher默认构造函数(:301)传给maxBufferCapacity;数组从 32(:195、:329-331)逐次翻倍到 256(:1128、:1148)。 offer(item, 0, NANOSECONDS, null)在慢订阅者下接受 266 条、丢弃 99734 条(5000 条,丢 99.734%);订阅者不request时接受的条数正好是 256,第 257 条submit会永久LockSupport.park(看门狗实测:2 秒后完成 256 条,线程状态 WAITING)。request的粒度没有带来量级上的吞吐差:无界 2.50M 条/秒 最快,request(1)1.64M 条/秒、request(64)1.40M 条/秒 紧挨着,两者方向在两个 JDK 上还相反。能测出来的是延迟:request(1)的每项端到端 p50 8,083ns 对request(64)的 3,041ns。- 别把
request(n)的 n 取成 1。Flow文档建议的 64/32 半量补货对应SampleSubscriber的写法(Flow.java:112-115),JDK 源码里还有一句「比每条都起一个任务还是便宜多了」(:991-994)。 - 某个订阅者抛异常,其他订阅者还能照常收到通知,前提是发布者自己处理了异常。回调列表里一个
RuntimeException会中断整个通知循环;SubmissionPublisher默认把它交给onNextHandler。
参考资料
- Observable (Java SE 25)
- Flow (Java SE 25)
- SubmissionPublisher (Java SE 25)
- JEP 266: More Concurrency Updates
- Reactive Streams
- JDK-8154801: deprecate Observer and Observable
- java.util.concurrent 包说明(Java SE 25)
系列索引:设计模式系列