设计模式——不可变与防御性拷贝
不可变有两个动作:造的时候不让别人改,交出去的时候把边界封住。
共享和拷贝是两笔账:共享把成本压在构造那一刻,拷贝把成本摊到每一次读取上。
1 亿次读取、1024 元素的列表、一组布尔验证,把这两笔账分开算,跑在两个 LTS 上:JDK 21.0.8 与 JDK 25。
一、两笔账记在谁头上
对象内部持有 1024 字节的数组,上层有很多只读的调用方,写法有两种。
1 | static final class SharedRepo { |
两个 data() 都是安全的:字段是 final,外部改不到 SharedRepo 的状态。差别在记账方式:SharedRepo 的成本在构造时付清,之后每次读取都是零;CopyRepo 的 1024 字节按调用次数收费。
边界不止 getter 一处:构造器收下的可变参数、setter 写进字段的对象、方法的返回值、传给别的组件的参数,都是「引用离开自己控制」的位置。同一个数组从构造器进来要拷一次,从访问器出去要拷第二次,两个方向都堵上才叫封装。第三种做法是把内部表示换成不可变类型,Date 换成 Instant,int[] 换成一个只读接口,边界不会产生,拷贝也就不需要了。
    graph TD
    CALL["调用方 data()"] --> Q{"交出的是引用还是副本"}
    Q -->|引用| S1["同一块数组"]
    S1 --> S2["读取成本 = 一次数组访问"]
    S1 --> S3["分配 0 字节,读者之间共享缓存行"]
    Q -->|副本| C1["每次 new 一块 1040 字节"]
    C1 --> C2["读取成本 = 分配 + 拷贝 + 清零"]
    C1 --> C3["1 亿次 = 104 GB 垃圾,年轻代回收 81 次"]
集合库里同一个需求有第二种形态。要对外返回「不可修改的列表」,JDK 给了两个入口:List.copyOf 复制一份数据,Collections.unmodifiableList 返回一个转发读操作的视图:
    graph LR
    MUT["ArrayList x"] --> A["List.copyOf(x)"]
    MUT --> B["unmodifiableList(x)"]
    A --> A1["新数组 + ListN 对象<br/>改动 x 不影响它"]
    B --> B1["一个 24 字节包装对象<br/>读操作转发给 x"]
    MUT -.->|"之后 add"| B1
两个入口的语义和成本都不是一回事:第三节和第四节给出这两组数字,第五节验证 record 持有可变字段时拷贝防住了什么。
二、实验设计与局限
- 机器:Apple M1 Pro,macOS 26.6.2,arm64
- JDK:
21.0.8+12-LTS-250与25+37-LTS-3491,各自用自己的javac编译 - 计时:
System.nanoTime(),每轮新起进程,预热后重复 3 轮取中位数 - 分配字节:
com.sun.management.ThreadMXBean.getThreadAllocatedBytes(threadId),线程级精确计数,不受采样影响 - GC:
GarbageCollectorMXBean的计数与累计暂停时间,按收集器归因 - exp1 用
-Xms2g -Xmx2g,固定堆大小,两次测量条件一致 - 测量期间独占一个全局锁(
mkdir /tmp/pattern-bench.lock),机器上有并行任务在跑,不持锁计时会被抢 CPU - 这次测量没用 JMH(本机也没有现成安装):单机微基准,只用来判断量级,不当作硬件上限
分配字节的取法就三行:
1 | var tmx = (com.sun.management.ThreadMXBean) ManagementFactory.getThreadMXBean(); |
这个计数器每个线程一份,精确累加,不采样、不分代,跑一次就是全部。GC 的计数和累计暂停时间从 GarbageCollectorMXBean 读,按收集器名字归因。
分配如果不逃逸,逃逸分析(EA)会把 Arrays.copyOf 的结果整个消掉,量出来的「拷贝成本」就是零。代码里每 1024 次迭代把数组引用写进静态字段,结果累加进另一个静态字段,并在末尾打印。分配字节数做交叉验证:拷贝分支每次 1040 字节,与 int[256] 的对象大小分毫不差,EA 没有把这次分配消掉。
每轮里的第一次重复会慢一截:JIT 到那时还没把循环编译到最佳状态,预热只跑了正式量的 5%。所有表格都取三次的中位数,这点方差改变不了量级差。
共享分支的循环体里没有可变状态,JIT 可以把不变量提到循环外,共享侧的时间应看成下界。分配字节数和 GC 次数不受这种优化影响,是这组实验里更硬的证据。
三、实测一:1 亿次读取
1 | int[] a = repo.data(); |
两个变体各跑 1 亿次,取三次中位数:
| 变体 | JDK 21 | JDK 25 | 每次分配 | 1 亿次总分配 | Young GC |
|---|---|---|---|---|---|
| 共享不可变数组 | 1.134 ns(113 ms) | 0.901 ns(90 ms) | 0 字节 | 0 | 0 次 |
每次 Arrays.copyOf |
31.097 ns(3.11 s) | 30.014 ns(3.00 s) | 1040 字节 | 104 GB | 81 次 |
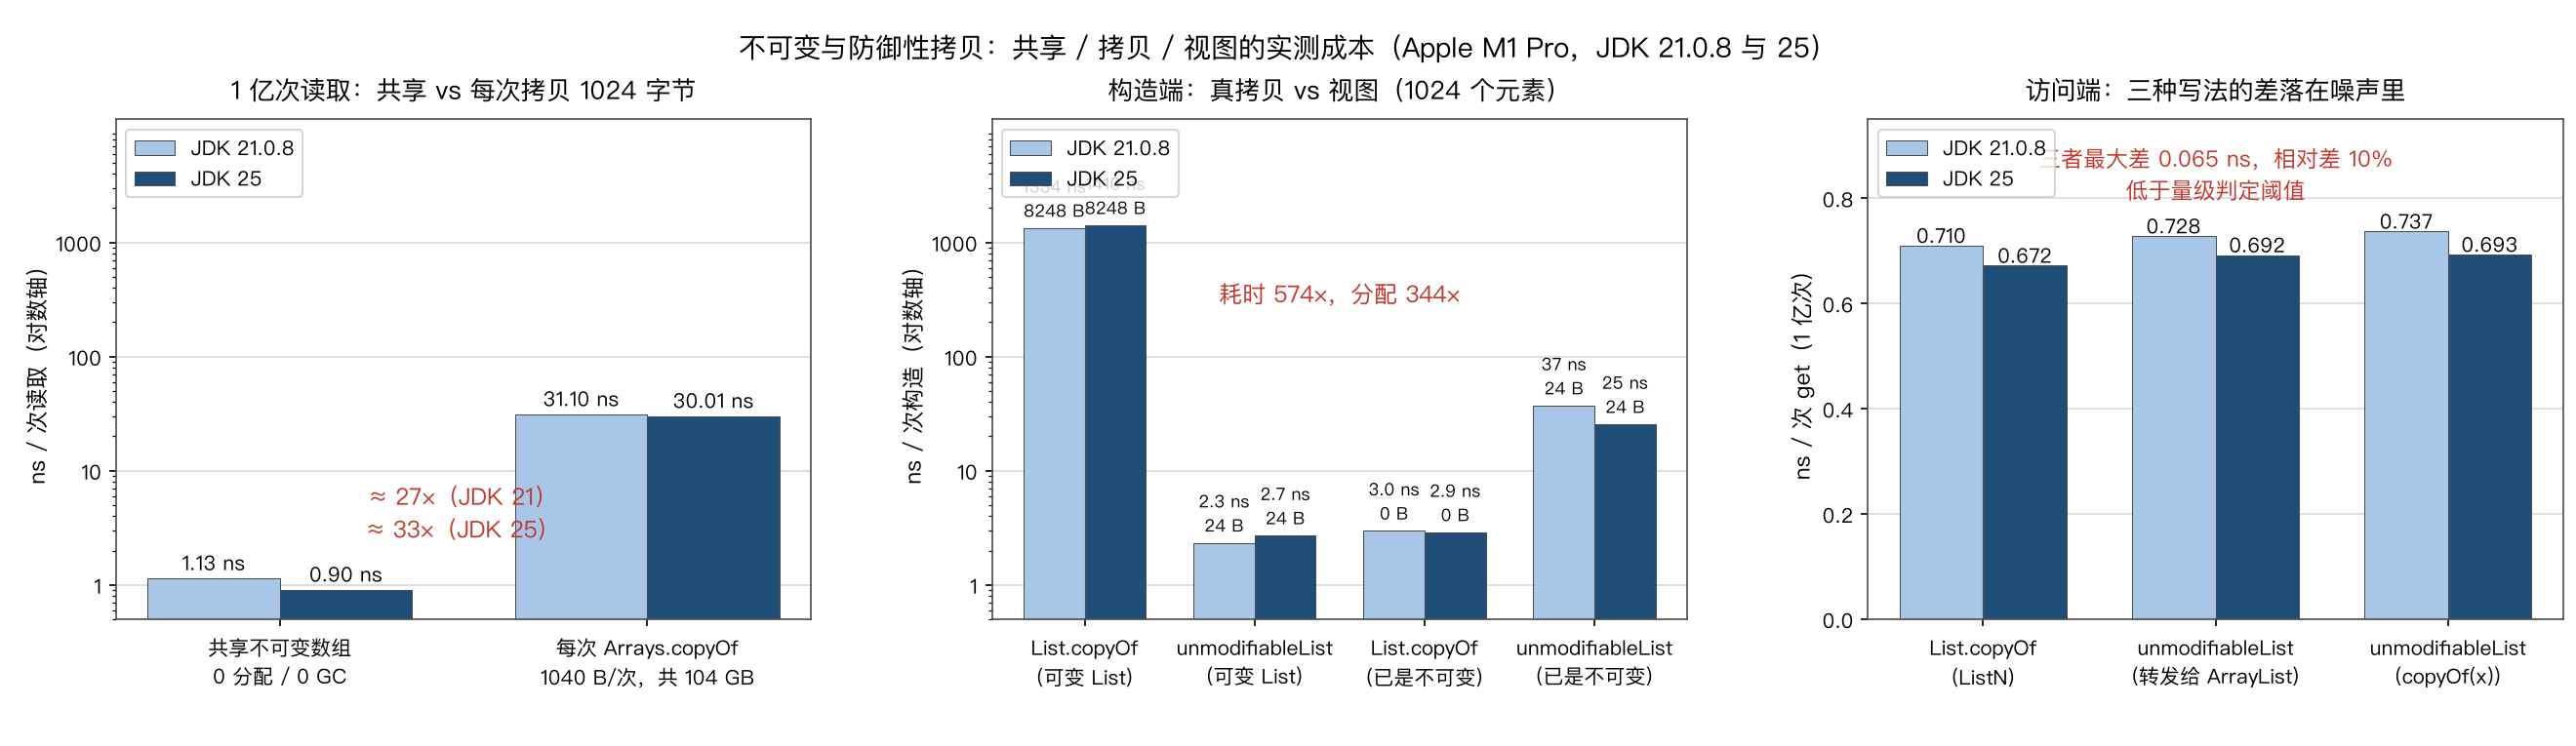
三次重复的原始数据在两个 JDK 上都很稳:JDK 21 共享侧 1.346 / 1.133 / 1.134 ns,拷贝侧 31.451 / 31.097 / 30.250 ns;JDK 25 是 0.777 / 0.909 / 0.901 ns 和 30.014 / 30.361 / 29.437 ns。时间比 27.4 倍(JDK 21)与 33.3 倍(JDK 25)。
1040 字节是 16 字节对象头加 1024 字节数据,1 亿次乘出来 104,000,000,000 字节。GC 计数按收集器归因:81 次全部落在 G1 Young Generation,G1 Old Generation 与 G1 Concurrent GC 一次都没有。累计暂停时间在两个 JDK 上差了近 3 倍:
| 场景 | Young GC 次数 | JDK 21 累计暂停 | JDK 25 累计暂停 |
|---|---|---|---|
| 1 亿次拷贝(三次重复) | 81 | 243 / 258 / 202 ms | 86 / 85 / 77 ms |
暂停时间只占拷贝总耗时的 2% 到 8%,其余开销都在分配和拷贝上。104 GB 除以 3.0 秒是 34.7 GB/s 的分配吞吐。同一次操作还要把源数组读一遍,真实内存流量翻倍之后接近 M1 Pro 单核内存带宽的量级。Arrays.copyOf 在这条路径上编译成走向量化指令的整块数组拷贝,没有 256 次 int 赋值。
把 30 ns 摊开:从 TLAB 里切一段、清零 1 KiB、拷 1 KiB、返回引用。清零和拷贝按内存带宽计价,成本与数组字节数成正比。new 几乎免费,指针加一下就完了。
共享侧 1 ns 上下,已经低到循环开销的量级:这轮循环里有取数组、加一个 int、每 1024 次一次写。JIT 能把不变的部分提出去,所以这个数不能读成「读一次数组要 1 纳秒」,只能读成「这条路径在这个循环里测不出额外成本」。分配字节 0 是确定的。
只读路径上共享一个不可变对象,比每次拷一份 1 KiB 省下 27 到 33 倍的耗时,分配上是 104 GB 对 0。读取次数越多,这笔账越贵。
把每次 1040 字节换算成分配速率:
| 读取速率 | 拷贝方案的分配速率 |
|---|---|
| 10 万次/秒 | 104 MB/s |
| 100 万次/秒 | 1.04 GB/s |
| 1000 万次/秒 | 10.4 GB/s |
| 本次实验(约 3300 万次/秒) | 34.7 GB/s,对应 81 次 Young GC |
每秒百万次这个量级,年轻代回收会稳定出现在火焰图上。同一份数据改走共享,这一列全部归零。
四、实测二:同一句「返回不可修改列表」
构造端
列表固定 1024 个 Integer,List.copyOf 与 Collections.unmodifiableList 各构造 20 万次,取三次中位数:
| 写法 | JDK 21 | JDK 25 | 分配/次 |
|---|---|---|---|
List.copyOf(可变 ArrayList) |
1334 ns | 1410 ns | 8248 字节 |
Collections.unmodifiableList(可变 ArrayList) |
2.3 ns | 2.7 ns | 24 字节 |
List.copyOf(已是不可变列表) |
3.0 ns | 2.9 ns | 0 字节 |
Collections.unmodifiableList(已是不可变列表) |
37 ns | 25 ns | 24 字节 |
第一行和第二行的差是 574 倍耗时、344 倍内存。最后一行三轮的离散度很大(JDK 21 上 59 / 37 / 3.2 ns,JDK 25 上 56 / 9.6 / 25.5 ns),这条路径的编译状态在测量期间反复重建,只有「照样分配 24 字节」是确定的。
8248 比一个数组大,拆开就清楚了。单独数分配字节的探针,两个 JDK 结果一致:
| 表达式 | 字节/次 | 说明 |
|---|---|---|
base.toArray() |
4112 | 一个 1024 长的 Object[] |
List.of(base.toArray()) |
8248 | 又来一遍 |
List.copyOf(可变 ArrayList) |
8248 | 同上,走的就是这条路 |
new ArrayList<>(base) |
4136 | 4112 + 24 的对象头 |
Collections.unmodifiableList(base) |
24 | 只有包装对象 |
List.copyOf(List.copyOf(x)) |
0 | 直接返回入参 |
Arrays.copyOf(int[256]) |
1040 | 16 字节头 + 1024 字节数据 |
List.of(1, 2, 3) |
56 | 一个 Object[3] 加一个 ListN,没有第二块 |
List.copyOf(2 元素 ArrayList) |
48 | Object[2] 加 List12 |
List.of(1, 2) |
24 | 只有 List12,没有数组 |
List.copyOf 走 ArrayList.toArray() 拿到第一块数组,ImmutableCollections.listFromArray 为了防 TOCTOU 又拷了第二块,再加 24 字节的 ListN 对象,4112 + 4112 + 24 = 8248。同一份数据在构造端搬了两遍。
两次搬数据的效率差很多。第三节里 Arrays.copyOf 搬 1 KiB 花 30 ns,分配吞吐 34.7 GB/s;这里 List.copyOf 摊到 1334 ns,分配吞吐只有 8248 / 1334 ns = 6.2 GB/s。慢的那一遍是 listFromArray 的逐元素循环:1024 次判空、赋值、过写屏障,不受 arraycopy 向量化照顾。按 1024 次迭代摊,每次约 1.3 ns,与一次带判空的引用赋值对得上。
第二块数组负责另一件事:拒绝 null 元素。List.copyOf 的契约不接受 null,检查只能逐元素做,而逐元素检查必须在自己的数组上进行,否则别的线程可能在检查完到使用之间把数据改掉。安全检查和拷贝在这里是同一段代码。
拷贝的代价随元素个数线性增长,视图那一侧的 24 字节不随元素个数变。两个元素时 List.copyOf 分配 48 字节(一个 Object[2] 加一个 List12),1024 个元素时是 8248 字节。List.of(1, 2) 只分配 24 字节,元素存在 List12 的两个字段里(ImmutableCollections.java:576-579),连数组都不要。列表越长,两个选择的差距越大;长度只有个位数的配置列表,两边的分配都是几十字节。
两个共享快路径互不认账
List.copyOf 对已经是 ListN/List12 的入参直接返回,Collections.unmodifiableList 对已经是自己的包装类的入参也直接返回。四条恒等判断在两个 JDK 上一致:
| 表达式 | 结果 | 分配 |
|---|---|---|
List.copyOf(List.copyOf(x)) == List.copyOf(x) |
true | 0 字节 |
unmodifiableList(unmodifiableList(x)) == unmodifiableList(x) |
true | 0 字节 |
unmodifiableList(List.copyOf(x)) == List.copyOf(x) |
false | 24 字节 |
List.copyOf(unmodifiableList(x)) == unmodifiableList(x) |
false | 8248 字节 |
两条共享路径都只认自己的类型。把一个不可变列表再包一层视图,或者把一个视图再拷一份,两个库都不会省下这一趟。
访问端
同两个列表各 get 1 亿次,索引在 1024 上取模:
| 写法 | JDK 21 | JDK 25 |
|---|---|---|
List.copyOf(x).get(ListN 直接索引) |
0.710 ns | 0.672 ns |
unmodifiableList(x).get(转发给 ArrayList) |
0.728 ns | 0.692 ns |
unmodifiableList(List.copyOf(x)).get(转发两层) |
0.737 ns | 0.693 ns |
三者最大差 0.065 ns,相对差 10%。这条循环的下界是从数组里取一个元素、拆箱、累加,三条路径都贴着它。访问端测不出量级差,「包装一层会拖慢读取」在这个规模上不成立。
语义差别
成本差两个数量级以上,语义差一个方向。四个布尔结果在两个 JDK 上一致:
| 检查 | 结果 |
|---|---|
unmodifiableList(m).size() 在 m.add("b") 之后变成 2 |
true |
List.copyOf(m).size() 在 m.add("b") 之后仍是 1 |
true |
List.copyOf(Arrays.asList("a", null)) 抛 NullPointerException |
true |
unmodifiableList(Arrays.asList("a", null)).size() 等于 2,不检查元素 |
true |
视图跟着底层走,是零成本的引用;拷贝是快照,顺带在构造时把 null 元素挡掉。选哪个取决于要的是「同一个数据的只读入口」还是「这一刻的数据」。
把视图当快照传出去,是这类 API 最常见的用法错误:接收方拿到 unmodifiableList 的返回值,按名字理解成「不会变」。看上表第一行:底层列表之后每改一次,接收方看到的都跟着变。要快照就用 List.copyOf。名字相差几个字,一个是快照、一个是视图,成本差两个数量级以上。
五、实测三:record 持有可变组件
record 自动生成的 equals / hashCode / toString 看着像值对象,组件是可变类型时这个假设要验证。被测的四个 record:
1 | record BadKey(int[] k) { } // 什么也不做 |
19 项布尔检查,两个 JDK 结果一致。
组件是 int[]:
| 检查 | 结果 |
|---|---|
外部改 src[0] = 99 后,bad.k()[0] 变成 99 |
true |
内容改了,bad.hashCode() 不变 |
true |
改动后拿同一个实例去 HashMap 查,仍然查得到 |
true |
两个内容相同的 record 互相 equals |
false |
拿同内容的新实例去查同一个 HashMap |
查不到(返回 null),true |
头三行是值的穿透,后两行说明 record 生成的 equals/hashCode 对数组组件按引用比较,不看内容。所以 int[] 组件既没有值语义,也不会因内容漂移搞坏哈希表。
组件是 Date 或者 List 时,方向反过来。这两个类的 equals/hashCode 由内容定义:
| 检查 | 结果 |
|---|---|
new Window(d, d2) 之后 d.setTime(9999),w.from().getTime() 变成 9999 |
true |
改动前 HashMap.get(w) 查得到 |
true |
改动后 HashMap.get(w) 查不到,size() 仍是 1 |
true |
未拷贝的 List 组件在外面 add("b") 之后看到 2 个元素 |
true |
在构造器里 List.copyOf 过的 List 组件仍是 1 个元素 |
true |
上面那个未拷贝的 List 组件改动后,HashMap 也查不到 |
true |
键还在桶里,取不出来了。size() 保持 1,get 返回 null,这是可变组件最典型的故障形态。
入口和出口两个方向都要堵。GoodKey 在规范构造器里 k.clone(),在访问器里再 k.clone():
| 检查 | 结果 |
|---|---|
改 src2[1] 之后,good.k()[1] 不等于 77 |
true |
改 good.k() 返回的数组之后,good.k()[2] 不等于 55 |
true |
只堵一个方向,另一边照样能把状态改掉。访问器不拷贝时,拿到返回值的人一改,对象内部就变了;构造器不拷贝时,传数组进来的人在构造之后一改,对象也跟着变。
还有一条性质:List.copyOf(new ArrayList<>(...)) 是浅拷贝。
| 检查 | 结果 |
|---|---|
List<StringBuilder> 拷贝后改元素本身,拷贝里的元素跟着变 |
true |
列表结构不可改,元素还是可变的。要让整棵树不可变,得逐层处理。
六、JDK 源码里的几个决策点
List.copyOf 的三条分支
JDK 25 java.base/java/util/List.java:1190-1192:
1 | static <E> List<E> copyOf(Collection<? extends E> coll) { |
javadoc 里已经写明有共享路径,List.java:1182:
1 | * calling copyOf will generally not create a copy. |
实现落在 java.base/java/util/ImmutableCollections.java:185-192:
1 | static <E> List<E> listCopy(Collection<? extends E> coll) { |
三条分支:入参已经是不可变列表就原样返回;空集合返回共享的空列表;其余情况走拷贝。第四节恒等判断表的第一行对应第一条分支。
拷贝为什么要来两遍
ImmutableCollections.java:204-211:
1 | static <E> List<E> listFromArray(E... input) { |
注释写着 TOCTOU:先分配、再逐个判空并搬进新数组。入参数组在检查和使用之间可能被另一个线程改掉,所以不能直接用。这就是 8248 里第二块 4112 的来源。
同一个文件里还有一条相反的路径,ImmutableCollections.java:219:
1 | * safely reused as the List's internal storage, avoiding a defensive copy. The array's |
这是 listFromTrustedArray 的 javadoc,信任调用方不再持有数组时,直接把数组当内部存储,省掉一次拷贝。List.of(a, b, c) 走的是定长重载(List.java:969-971),数组由库自己造、外部拿不到引用,ListN 直接收下了这个数组。同一次测量里它的 56 字节就是一个 Object[3] 加一个 ListN,没有第二块数组。
存下来的数组此后只读。ImmutableCollections.java:698-726 里 ListN 的实现:
1 | private final E[] elements; |
实现里没有边界检查、同步和防御性拷贝:读操作就是一次数组访问,不可变的收益在这里兑现。List12 在 :573-613 用两个字段存 1 到 2 个元素(:576-579 是 e0 与 e1),这个规模下连数组都不分配,size() 靠 e1 != EMPTY 这个哨兵区分 1 个还是 2 个元素。
视图的语义写在 javadoc 里
JDK 25 java.base/java/util/Collections.java:1459-1462:
1 | * Returns an <a href="Collection.html#unmodview">unmodifiable view</a> of the |
read through 三个词定义了视图:读操作穿透到原列表。同一段 javadoc 的 :1469 还写着「This method may return its argument if the argument is already unmodifiable」,实现按具体类判断,Collections.java:1475-1478:
1 | public static <T> List<T> unmodifiableList(List<? extends T> list) { |
只认自己的两个包装类。ListN 是不可变的,但不是这两个类之一,所以还要再包一层,就是恒等表里第三行的 24 字节。转发成本落在读取端,Collections.java:1505 里 UnmodifiableList.get 的全部实现是一行:
1 | public E get(int index) {return list.get(index);} |
多一层接口调用、多读一个字段。第四节访问端的表里,这些都摊平在 0.065 ns 的差里。
Date 那篇 javadoc 没写的话
java.base/java/util/Date.java 全文只有一处提到 copy,在 :276:
1 | * Return a copy of this object. |
这是 clone() 的 javadoc(:278 是 public Object clone())。类文档里讲了 UTC、闰秒、年月日偏移,一个字都没提醒调用方:把 Date 交给别人之前要拷一份。JDK 把这条忠告写在了另一个地方,java.base/java/lang/Record.java:57-60:
1 | * <p>The primary reasons to provide an explicit declaration for the |
「perform defensive copies on mutable components」。第五节的 GoodKey 就是这句话的展开。同文件 :62-68 还要求:用 new R(r.c1(), r.c2()) 重建出来的实例必须与原件 equals。数组组件不拷贝时这条不变量成立(引用比较),但值语义没了;Date 组件不拷贝时,外部改动会破坏这条不变量。
record 的自动方法由 java.base/java/lang/runtime/ObjectMethods.java 生成。引用类型组件的比较与哈希走这两个句柄(:162-172):
1 | private static MethodHandle equalator(Class<?> clazz) { |
OBJECTS_EQUALS 是 Objects.equals,OBJECTS_HASHCODE 是 Objects.hashCode。数组是一等引用类型,不会展开成逐元素比较,第五节 A5 的 false 就是这么来的。
七、结论
什么时候共享
- 对象不可变:字段全部
final,字段类型也不可变,或者至少外部拿不到可变引用。数组、Date、可变集合都不能直接暴露。 - 这个对象处在只读热路径上。第三节的账本(JDK 21):共享 113 ms / 0 字节,拷贝 3.11 s / 104 GB。
- 需要「同一份数据的最新状态」时,视图就是零成本入口,24 字节。
什么时候必须拷贝
- 构造器接收可变参数并在之后长期持有。第五节的 C1 到 D3 全是这类穿透。
- 访问器返回内部的数组或可变集合。出口不拷贝,调用方改返回值就是改内部状态。
- 对象要当
HashMap的键,组件是Date、可变集合这类「内容定义 hashCode」的类型。改动后get返回 null,size()不变,排查起来看不到异常。 - 跨线程传可变对象,且没有其他同步手段。这里拷贝买到的是确定性。
不拷贝的第三条路
把可变组件换成不可变表示。Date 换成 Instant 或者 long 时间戳,int[] 换成一个只读接口包装的实例,边界上的拷贝和包装都不再需要。第五节的 C 组说明漂移的根源是「内容定义哈希」这个性质,换掉组件的类型,故障形态从源头消失。java.time 里的类型大多不可变,替换掉 Date 之后,防御性拷贝那一行可以从构造器里删掉。
四个实测过的误用
- 在访问器里
List.copyOf当保险。1024 个元素每次 1334 ns、8248 字节,热路径上一秒百万次就是 8 GB/s 的分配(第四节)。快照应该在构造器里定下来,别放在读取路径上。 - 把
unmodifiableList的返回值当快照存起来。它随后续修改而变(第四节第一行布尔结果)。 - 用 record 包住
int[]就当值对象传。生成的equals比的是数组对象,两个内容相同的实例不相等(A5)。 - 用
List.copyOf包住List<StringBuilder>就当深不可变。元素还能照改(F3)。
判断顺序
    graph TD
    S["一个不可变或可变对象要越出边界"] --> Q1{"接收方会不会改它"}
    Q1 -->|会改,或者改成什么样不确定| CP["边界上拷一份<br/>入口 copyOf / clone,出口再拷一次"]
    Q1 -->|只读| Q2{"内部持有的类型暴露出去后还能被改吗"}
    Q2 -->|能,比如数组、Date、可变集合| CP
    Q2 -->|不能,或者只暴露只读视图| Q3{"这是每次调用的热路径吗"}
    Q3 -->|是| SH["共享同一个实例<br/>成本在构造时付清"]
    Q3 -->|不是| EITHER["两种都行<br/>选语义清楚的那个"]
三步:先问接收方会不会改,再问内部的可变引用有没有暴露出去,最后问这条路径是不是每次调用都会走到。前两问决定要不要拷贝,第三问只在两者都安全时才算成本。
数量级门槛
1024 字节的对象,每次拷贝 30 ns、1040 字节。调用 1000 万次是 10 GB 垃圾,1000 次是 10 MB。QPS 1 万的服务里,一个请求拷两次就是每秒 2 万次、每秒 20 MB 的分配,年轻代扛得住。每秒 100 万次就是 1 GB/s,GC 会开始出现在火焰图上。
共享不可变对象在读取端没有成本可优化,成本是零。这条只对不可变对象成立:List.copyOf 是浅拷贝,元素可变的话,共享的就是一棵会变的树。
总结
- 两笔账分开记:共享的成本在构造时付清(113 ms / 0 字节 / 0 GC),每次拷贝的成本按调用次数收(3.11 s / 104 GB / 81 次 Young GC)。1 亿次读取下,耗时差 27 到 33 倍,分配是 0 对 104 GB。
- 拷贝的 30 ns 里大头是内存带宽:104 GB / 3.0 s = 34.7 GB/s,贴着 M1 Pro 单核带宽。
new在 TLAB 里几乎免费,贵的是那 1 KiB 的读和写。 List.copyOf(1024 元素的 ArrayList)每次分配 8248 字节,是 1024 长Object[]的两倍再加 24。多出来的一遍来自ImmutableCollections.listFromArray里标注 TOCTOU 的那次拷贝(ImmutableCollections.java:204-211)。Collections.unmodifiableList每次构造只分配 24 字节,构造耗时 2.3 到 2.7 ns,比List.copyOf的 1334 到 1410 ns 快 574 倍。- 访问端三者最大差 0.065 ns(10%),测不出量级差。
ListN.get直接索引数组,视图转发给ArrayList.get,都贴着循环的下界。 - 两个共享快路径互不认账:
unmodifiableList(List.copyOf(x))仍分配 24 字节,List.copyOf(unmodifiableList(x))照样拷一份新的。 - 语义差别是方向性的:
unmodifiableList的读操作穿透到底层列表,List.copyOf是快照,并在构造时拒绝 null 元素。 record的自动equals/hashCode对int[]组件用引用语义(ObjectMethods.java:162-172走Objects.equals/Objects.hashCode):内容改了哈希不变,两个内容相同的实例不相等。record持有Date或可变List时,外部改动会让哈希值漂移,HashMap里键还在、取不出来(get返回 null,size()仍是 1)。- 入口和出口是两条独立的边界,各自都要拷贝。
Record.java:57-60把「perform defensive copies on mutable components」写成了显式声明规范构造器与访问器的首要理由。 List.copyOf是浅拷贝。元素可变时,拷贝出来的列表里的元素照样能改。
参考资料
- List.copyOf (Java SE 25)
- Collections.unmodifiableList (Java SE 25)
- ImmutableCollections (Java SE 25)
- Unmodifiable View Collections
- Record (Java SE 25)
- Date (Java SE 25)
- ThreadMXBean.getThreadAllocatedBytes
- 本系列其它篇目:原型 讲拷贝有四条路可以走;享元 共享的是不可变的内在状态;对象池 复用可变对象,与本篇的共享不可变对象是一组对照。
系列索引:设计模式系列