设计模式——对象池:什么时候是负优化
对象池把「分配」换成了「借还」。分配走线程私有的 TLAB,借还抢所有线程共用的队列。
收益只能来自免掉构造与初始化,代价是同步。构造越贵,这笔交换越划算;构造越便宜,省下的越少,而同步开销照付。
三种构造成本(1 KiB 数组、DirectByteBuffer(1 KiB)、SecureRandom初始化)乘三种取法(每次new、ThreadLocal 池、ReentrantLock池),在 1、8、16 线程下各计时 1 秒,JDK 21 与 JDK 25 都跑,找出池化从赚到亏的那条线。
一、池化把什么换成了什么
new 是一条线程私有路径。HotSpot 给每个线程一块 TLAB,分配对象就是把指针往前挪一段,再零初始化。
池化把这条路径改成:从共享队列取一个对象、重置它的状态、用完还回去。取和还都要同步。
    graph TD
    subgraph A["每次 new:线程私有"]
      A1["线程本地 TLAB"] -->|"指针加法 + 清零"| A2["可用的新对象"]
      A2 --> A3["使用"]
      A3 --> A4["交给 GC"]
    end
    subgraph B["池化:共享可变状态"]
      B1["任意线程"] -->|"抢锁或 CAS"| B2["共享空闲队列"]
      B2 --> B3["重置状态"]
      B3 --> B4["使用"]
      B4 -->|"再抢一次锁,还回去"| B2
    end
两种路径随线程数的走势是反的。分配的成本是常数:TLAB 是线程私有的,16 个线程同时分配与 1 个线程分配,每个线程付的价钱一样。借还的成本随线程数上升:同一个队列、同一把锁,线程越多,等在锁上的时间越长。
划不划算,写成一条不等式:C_new 是分配加初始化的成本,C_borrow(n) 是 n 个线程下每次借还的成本,C_reset 是重置成本:
1 | C_new > C_borrow(n) + C_reset |
右边随 n 增长,左边不随 n 变化。容易看错的是 C_new:它看着像一次指针加法,很多真实对象的构造过程却在抢全局资源。DirectByteBuffer 的构造函数里有三个全局原子操作和一次 static synchronized 调用,这类对象的分配成本不随核数下降。
二、实验设计与局限
三种取法
| 策略 | 取对象 | 还对象 | 同步 |
|---|---|---|---|
每次 new |
new X() |
交给 GC | 无 |
| ThreadLocal 池 | ThreadLocal.get() |
重置后留在本线程 | 无锁,一次 map 查找 |
| 有锁池 | ReentrantLock 保护的 ArrayDeque.poll() |
入队 | 每次借还各抢一次锁 |
ThreadLocal 池是零同步基线:对象放在线程自己身上,用来量免掉分配与重置值多少钱。有锁池就是通常说的「对象池」,容量上限 64,队空时补一个 new。两个池都在归还前调用对象的 reset()。
三种构造成本
| 对象 | 构造做什么 | 使用做什么 |
|---|---|---|
Cheap |
new byte[1024] |
写两个字节、读回来 |
ExpDirect |
ByteBuffer.allocateDirect(1024) |
往 native 内存写一个 long、读回来 |
ExpRng |
new SecureRandom() 取种子构造 Random |
random.nextLong() |
ExpRng 把成本放在构造上、把便宜留在使用上,用来隔离构造成本这一个变量。
度量口径
- 吞吐:工作线程在 1 秒窗口内完成的 op 数除以墙钟。
- 分配字节:
com.sun.management.ThreadMXBean.getCurrentThreadAllocatedBytes()在窗口前后的差,只算堆。 - GC:
GarbageCollectorMXBean的collectionCount与collectionTime在窗口前后的差,默认 G1。 - 每个配置先跑 400 ms 预热,再用同一份代码路径计时 1 000 ms。
- 环境:Apple M1 Pro(10 核,8 性能核 + 2 能效核),macOS 26.6.2,JDK 21.0.8 与 JDK 25,
-Xms512m -Xmx512m -XX:MaxDirectMemorySize=4g -XX:+UseG1GC。
另一条独立的测量:单线程探针
除了并发基准,另有一个单线程探针,它只回答一个问题:这些对象构造一次要分配多少字节。按 20 000 次一组统计,只数 ThreadMXBean 的分配字节数,不受 JIT 优化影响(这点用 -Xint 验证过,数值不变):
| 构造一次 | JDK 21 | JDK 25 |
|---|---|---|
new SecureRandom() |
2 025 B | 370 B |
SecureRandom.getInstance("NativePRNG") |
2 016 B | 360 B |
SecureRandom.getInstance("DRBG") |
737 B | 634 B |
new java.util.Random() |
56 B | 56 B |
Provider.getService("SecureRandom", "NativePRNG") |
0 B | 0 B |
探针同时测了耗时,但它的循环迭代次数不足以让这些方法走到 C2 编译,时间数字偏保守。引用的耗时全部来自基准那一列,探针只用来做分配量的横向比较。
局限
计时循环在全局锁内单独运行,同一时刻没有别的计时任务在抢 CPU,机器上仍有其它非计时负载。每个配置只跑一次,读的是量级。16 线程在 10 核上属于超订,8 线程那一档才对应性能核的数量。另外只测了「借出、使用、归还」这个内循环,容量管理、失效检测、空闲超时回收都不在内,加上它们只会让池更贵。
一个测量坑:出口放在共享缓存行上
为了让 JIT 不能把分配优化掉,循环里必须让对象真的逃逸。第一轮我用一个共享的 static volatile 字段装它。8 线程以上,这条缓存行成了所有线程的共同瓶颈:ThreadLocal 池的吞吐从单线程的 212 M op/s 掉到 95 M,看起来像「无锁池也不扩展」。
把出口改成每线程独占的槽位(SLOTS[i * 64],间隔 512 字节)之后,同一份代码在 8 线程下跑到 894 M op/s。下面所有数字都来自改好的这一版,第一轮的原始记录留在日志里。测量钩子自己会变成瓶颈,而且只在并发那一档露出来。
三、便宜对象:1 KiB 数组
| 策略 | 线程 | JDK 21 | JDK 25 | 每 op 分配字节 | GC 次数(JDK 25,1 s 窗口) |
|---|---|---|---|---|---|
每次 new |
1 | 10.0 M op/s | 9.5 M op/s | 1,064 | 32 |
每次 new |
8 | 42.0 M op/s | 44.0 M op/s | 1,064 | 147 |
每次 new |
16 | 43.7 M op/s | 44.4 M op/s | 1,064 | 149 |
| ThreadLocal 池 | 1 | 185.4 M op/s | 212.0 M op/s | 0 | 0 |
| ThreadLocal 池 | 8 | 899.6 M op/s | 894.2 M op/s | 0 | 0 |
| ThreadLocal 池 | 16 | 886.6 M op/s | 941.1 M op/s | 0 | 0 |
| 有锁池 | 1 | 38.5 M op/s | 38.7 M op/s | 0 | 0 |
| 有锁池 | 8 | 25.6 M op/s | 24.7 M op/s | 0 | 0 |
| 有锁池 | 16 | 24.1 M op/s | 24.4 M op/s | 0 | 0 |
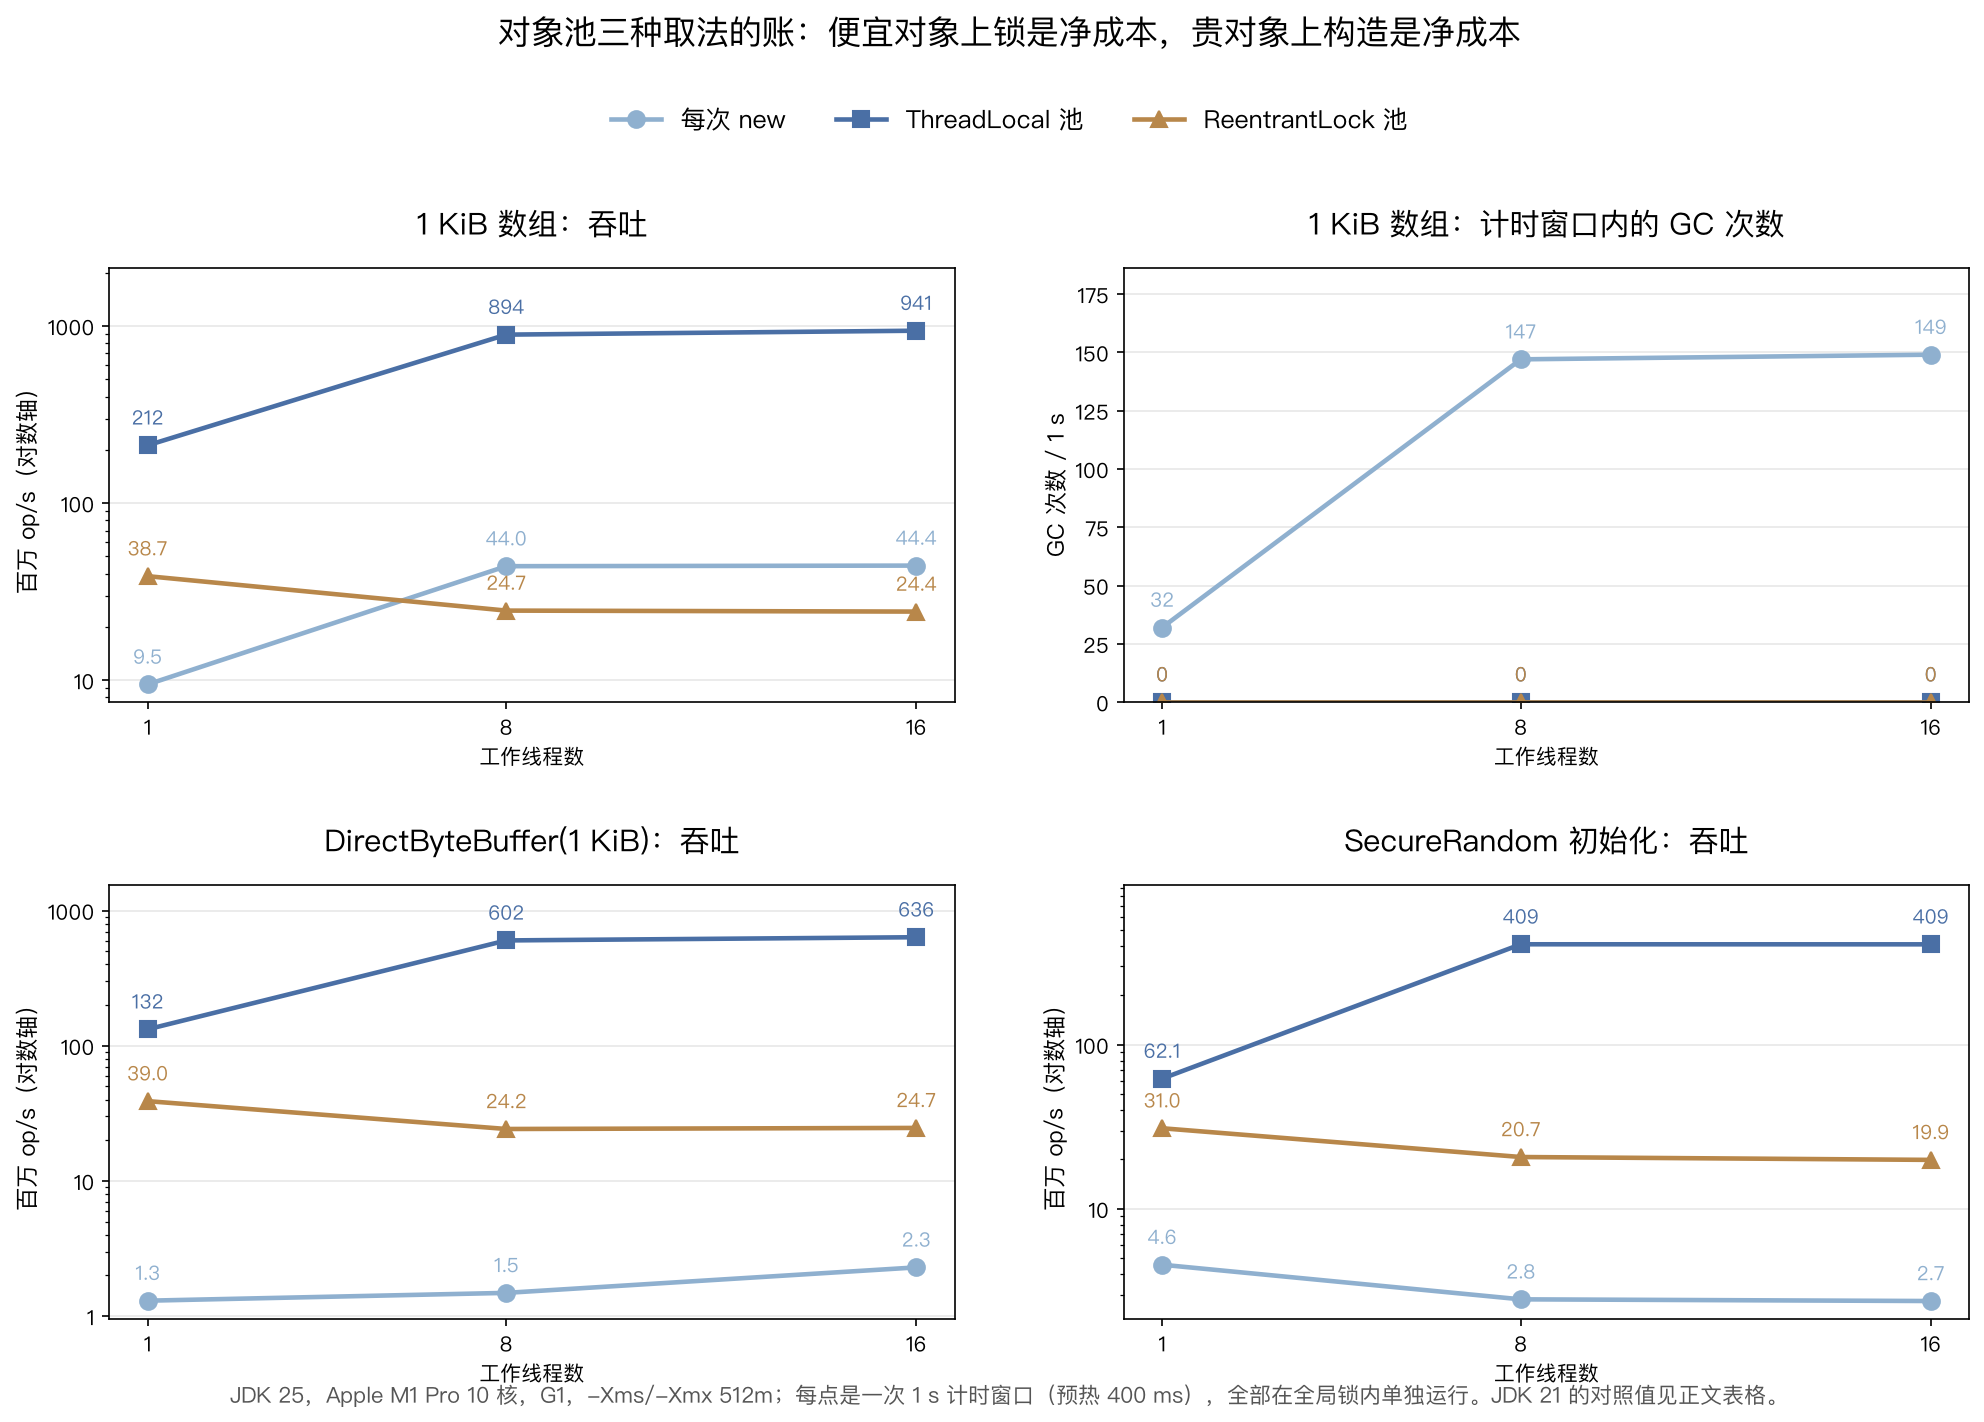
单线程那三行:new 9.5 M op/s(每次 105.7 ns,1 秒里触发 32 次 GC),有锁池 38.7 M(25.9 ns),ThreadLocal 池 212 M(4.7 ns)。池化赢 4 倍。一个 1 KiB 数组的分配、清零加上随之而来的 GC,单价 105 ns;一次没有竞争的 ReentrantLock 借还只要 26 ns。这三行里,用同步成本换分配成本合算。
8 线程那三行反转:new 44.0 M,有锁池 24.7 M,new 快 1.8 倍。16 线程是 44.4 M 对 24.4 M,还是 new 快。
有锁池的吞吐几乎不随线程数变化,1 → 8 → 16 是 38.7 M、24.7 M、24.4 M,加线程反而慢。它每秒能完成的借还有上限,约 2500 万次,因为所有线程排在同一条临界区上。把窗口摊到每个线程:16 线程时一次借还的墙钟代价是 655 ns,单线程时是 25.9 ns,多出来的约 630 ns 全在等锁。
new 那一侧是另一个形状:9.5 M → 44.0 M → 44.4 M。前一段随核数扩展,8 线程之后撞上内存带宽:44.4 M op/s 乘以 1064 字节是 47 GB/s 的分配速率,1 秒触发 149 次 GC,光 GC 就占掉 87 ms。分配能并行,回收不能。
ThreadLocal 池给出免掉分配与重置的上界:212 M、894 M、941 M。它不分配、不抢锁,只付一次 map 查找,代价是每个线程按一个实例的内存。
GC 次数是这一节最干净的证据:new 在 1 秒窗口里触发 32、147、149 次 GC,两个池全是 0。分配字节一栏,new 每次 1 064 字节,两个池是 0。
把总吞吐摊到每个线程
| 策略 | 1 线程 | 8 线程(每线程) | 16 线程(每线程) | 总量 1 → 16 线程 |
|---|---|---|---|---|
每次 new |
9.5 M | 5.5 M | 2.8 M | 涨 4.7 倍 |
| ThreadLocal 池 | 212.0 M | 111.8 M | 58.8 M | 涨 4.4 倍 |
| 有锁池 | 38.7 M | 3.1 M | 1.5 M | 降 37% |
三种取法的每线程吞吐都在掉,掉的原因不一样。
new 的每线程从 9.5 M 掉到 2.8 M,总量却涨了 4.7 倍。分配与清零是并行工作,8 个性能核各干各的,开销落在共享的内存总线上;到 8 线程时总量已经撞顶,再加线程只是把同一块带宽分得更细。
ThreadLocal 池从 212 M 掉到 58.8 M,总量涨 4.4 倍后停在 900 M 附近,同样的形状,只是天花板高得多,因为它不产生垃圾,只读写线程自己的那 1 KiB。
有锁池的每线程从 38.7 M 掉到 1.5 M,总量也在降。它的天花板是临界区:所有线程串在同一条队列上,线程数只是把固定的一块吞吐切得更碎,再加上争用带来的额外开销,总量比单线程还低。池的吞吐是一条水平线,new 是一条爬升后走平的线,两条线的交点就是该不该池化的分界。
为什么 1 KiB 这么便宜的对象也能赢 4 倍
单线程下 new 每次 105.7 ns,拆开是分配、清零、以及 32 次 GC 分摊下来的 18 ms。一次没有竞争的 ReentrantLock 借还 25.9 ns。整数缓存那个量级(几十字节的对象、TLAB 里挪指针)不值得池化,但 1 KiB 的零初始化已经是一块真实的内存写入,再加上随之而来的 GC 扫描与复制,单价就上了 100 ns。分配、清零、回收,三笔加起来才是池化要抵掉的开销。
一个 100 ns 级构造的对象,池化只在 1 到 4 线程之间划算,交叉点在 2 到 4 线程:1 线程是 38.7 对 9.5,8 线程是 24.7 对 44.0。
四、贵对象:DirectByteBuffer(1 KiB)
| 策略 | 线程 | JDK 21 | JDK 25 | 每 op 分配字节 | GC 次数 / GC 毫秒(JDK 25) |
|---|---|---|---|---|---|
每次 new |
1 | 1.4 M op/s | 1.3 M op/s | 152 | 2 / 614 ms |
每次 new |
8 | 1.9 M op/s | 1.5 M op/s | 152 | 8 / 536 ms |
每次 new |
16 | 1.7 M op/s | 2.3 M op/s | 152 | 5 / 371 ms |
| ThreadLocal 池 | 1 | 145.5 M op/s | 132.4 M op/s | 0 | 0 / 0 ms |
| ThreadLocal 池 | 8 | 719.5 M op/s | 601.9 M op/s | 0 | 0 / 0 ms |
| ThreadLocal 池 | 16 | 558.3 M op/s | 635.6 M op/s | 0 | 3 / 143 ms |
| 有锁池 | 1 | 38.9 M op/s | 39.0 M op/s | 0 | 0 / 0 ms |
| 有锁池 | 8 | 24.4 M op/s | 24.2 M op/s | 0 | 0 / 0 ms |
| 有锁池 | 16 | 22.7 M op/s | 24.7 M op/s | 0 | 0 / 0 ms |
new ByteBuffer.allocateDirect(1024) 这一行没有扩展性:1 线程 1.30 M op/s,8 线程 1.49 M,16 线程 2.29 M,单次 436 到 769 ns。同期有锁池稳定在 22 到 39 M op/s,16 线程时快 10.8 倍。16 个线程一起跑 new,每个线程每秒只能完成 14.3 万次,单次摊到 7.0 µs;单线程时是 769 ns。线程越多,每次分配越慢,这是抢全局资源的形状。
代价不全在堆上。每 op 只分配 152 字节堆内存,1 KiB 在 native 那边。看 GC 时间:JDK 25 的三个窗口里分别有 614、536、371 ms 花在 GC 上。对照第三节,1 KiB 数组每 op 分配 1064 字节,一次 young GC 只要 0.6 ms(149 次合计 87 ms)。这一组每 op 的堆分配少 7 倍,单次 young GC 却要 74 ms(5 次合计 371 ms)。差在引用处理:每个 direct buffer 挂着一个 Cleaner 幻象引用,清理要逐条走引用处理器并释放 native 内存。
构造函数里的四步
java.nio.DirectByteBuffer 只有这一个入口,JDK 25 DirectByteBuffer.java:102-137:
1 | DirectByteBuffer(int cap) { // package-private |
四步里两步是全局串行的。
Bits.reserveMemory 是记账,实现在 java.nio.Bits.java:188-203,一个 CAS 循环抢三个全局原子量:
1 | private static boolean tryReserveMemory(long size, long cap) { |
UNSAFE.allocateMemory 走底层分配器,UNSAFE.setMemory(base, size, (byte) 0) 把这块内存清零,1 KiB 就是 1 KiB 的内存写。最后一步 Cleaner.create 落到 jdk/internal/ref/Cleaner.java:76:
1 | private static synchronized Cleaner add(Cleaner cl) { |
每个 direct buffer 的分配都要从这把监视器上过一遍。释放一侧同样:DirectByteBuffer.java:80-82 的 Deallocator.run() 调用 Cleaner.remove,Cleaner.java:85 上写着 private static synchronized boolean remove(Cleaner cl)。执行这段代码的是引用处理器线程。
堆上每 op 152 字节、native 每 op 1 KiB,加上两次全局监视器和三个全局原子操作,所以这条路径不随核数扩展。池化在这里做的事是把「每次分配都过一遍全局资源」降成「每次借还抢一次锁」,后者的临界区只有队列操作加一次状态重置。
配额抢不到时的慢路径
Bits.reserveMemory 还有一条退避路径,Bits.java:109-171。抢不到配额时它先等引用处理,再强制一次 GC,然后按 1、2、4 一直到 256 ms 的间隔重试,最多 9 次(MAX_SLEEPS = 9),约 0.5 秒后抛 OutOfMemoryError:
1 | // trigger VM's Reference processing |
这条路只在 direct 内存接近上限时才会走到,本次实验把上限放宽到 4 GB,没有触发。池化在 direct buffer 上因此还有第二笔收益:池里的对象数固定,reserveMemory 的调用次数从「每次分配」降成「池容量」那么多,分配密集的时段不会把进程顶到 GC 加退避重试那一侧。
五、初始化最贵的一档:SecureRandom
| 策略 | 线程 | JDK 21 | JDK 25 | 每 op 分配字节 | GC 次数(JDK 25) |
|---|---|---|---|---|---|
每次 new |
1 | 0.8 M op/s | 4.6 M op/s | 408 | 6 |
每次 new |
8 | 1.3 M op/s | 2.8 M op/s | 408 | 3 |
每次 new |
16 | 1.2 M op/s | 2.7 M op/s | 408 | 3 |
| ThreadLocal 池 | 1 | 62.4 M op/s | 62.1 M op/s | 0 | 0 |
| ThreadLocal 池 | 8 | 376.0 M op/s | 409.2 M op/s | 0 | 0 |
| ThreadLocal 池 | 16 | 405.1 M op/s | 408.9 M op/s | 0 | 0 |
| 有锁池 | 1 | 31.7 M op/s | 31.0 M op/s | 0 | 0 |
| 有锁池 | 8 | 20.4 M op/s | 20.7 M op/s | 0 | 0 |
| 有锁池 | 16 | 16.5 M op/s | 19.9 M op/s | 0 | 0 |
这一组里池化赢得最多,也暴露出一个跨版本的坑。
JDK 25 上 new 每次 219 到 365 ns,池化后 19.9 M op/s,快 7.3 倍。JDK 21 上同一次 new 要 846 到 1198 ns,池化快 13.9 倍。同一个算法,两个 LTS 差 5 倍。
查过三件事。默认算法:两个版本都是 NativePRNG(SecureRandom.getAlgorithm() 直接打印)。provider service 的实现类:两个版本都是 sun.security.provider.NativePRNG。JIT 有没有把 SecureRandom 消掉:加 -Xint 后分配量不变,JDK 21 每次仍是 2025 字节,JDK 25 仍是 370 字节,所以差异在执行路径里,不在编译器优化里。
再往下拆:SecureRandom.getInstance("NativePRNG") 单独测也是 2016 字节对 360 字节,同样的差距;而 provider 的服务查找 Provider.getService("SecureRandom", "NativePRNG") 两个版本上都分配 0 字节。同样的写法换成 SecureRandom.getInstance("DRBG"),两个版本是 737 与 634 字节,接近。差距只出现在 NativePRNG 这条线上(JDK 25 把 SecureRandomSpi 的构造函数改成接收 SecureRandomParameters,这是两版源码里可见的变化之一),具体是哪一层,本次没有定位到源码行。
不要假设同一个类在两个 LTS 之间的构造成本不变,new 那一列的 5 倍差距就出在这里,它会直接改变池化划算与否的判断。用池化的代码通常会把「构造贵」写进设计说明,而构造成本这个前提会随版本漂移。
池化还吃掉了版本差异:JDK 21 与 JDK 25 的有锁池吞吐几乎一样(16.5 M 对 19.9 M),ThreadLocal 池也一样(405.1 M 对 408.9 M)。一旦构造只发生在池的填充阶段,new 那 5 倍的差距就从热路径上消失,剩下的成本只有借还与使用。
六、边界在哪
把三组的构造成本与借还成本并排放:
| 对象 | new 单线程 |
new 16 线程 |
有锁池 1 线程 | 有锁池 16 线程 | 16 线程谁赢 |
|---|---|---|---|---|---|
| 1 KiB 数组 | 105.7 ns | 22.5 ns | 25.9 ns | 41.0 ns | new 快 1.8 倍 |
| DirectByteBuffer(1 KiB) | 768.7 ns | 435.9 ns | 25.7 ns | 40.5 ns | 池快 10.8 倍 |
| SecureRandom(JDK 25) | 219.1 ns | 364.5 ns | 32.3 ns | 50.3 ns | 池快 7.3 倍 |
| SecureRandom(JDK 21) | 1197.8 ns | 846.7 ns | 31.5 ns | 60.8 ns | 池快 13.9 倍 |
借还成本这一侧几乎不随对象变化,那是锁的价格:单线程 26 到 32 ns,16 线程 40 到 61 ns。它只随线程数变,涨得不快:临界区太短,争用大多消耗在排队上。
构造成本这一侧跨了近两个数量级(22 ns 到 1200 ns),池化的收益跟着它走。
边界因此由两件事决定:
- 构造贵到几百纳秒以上,池化就赚。
DirectByteBuffer与SecureRandom都在这一侧,而且它们的new路径本身不扩展,线程越多亏得越狠。 - 构造在 100 ns 级,池化换来的是同步成本。 1 KiB 数组这一组的交叉点在 2 到 4 线程之间,之后每加一个线程都在给锁还债。
反过来看同一份代码:new 在 1 线程下比池慢 4 倍,在 16 线程下比池快 1.8 倍。脱离线程数谈谁快谁慢没有意义。
池化没测到的三笔账
上面的数字只覆盖「借出、使用、归还」这个内循环。真实的池还有三笔支出,它们不在 ns/op 里,但会决定池能不能用。
容量。 容量定小了,队空时补 new,池退化成「每次分配,外加两次加锁」,比不池化更慢。定大了,空闲对象在堆上驻留,被 GC 反复扫过,还可能被晋升到老年代:一个 64 个实例、每个 1 KiB 的池是 64 KiB,看着不多;1 000 个连接的连接池按每连接几 MB 的驱动缓冲算,就是几 GB。容量应当由外部资源的上限推导(并发请求数、连接数、MaxDirectMemorySize),不能靠调优时试出来。
泄漏。 借了不还,池会一路补 new 补到上限,然后永久阻塞或者退化。JVM 不会报错,只会看到吞吐下降到某个水平后不再恢复。有锁池的公平性设置还会放大这个问题:new ReentrantLock(true) 在争用时按队列顺序放行,代价是吞吐再降一截,换来的是不会有线程被无限插队。
脏状态。 归还时漏掉一个字段,下一个借用者读到的就是上一个用户的残留。这类 bug 在单线程测试里不出现,在生产上表现为随机错误。防守办法是把重置放在构造里(每次借出时重置),代价是每 op 多一次重置;或者让对象不可变,那就回到了享元。共享不可变的做法见《享元:共享不可变状态》。
三笔账都不进计时器,但都会把「池化在 100 ns 级对象上净亏 1.8 倍」这种结论进一步推向同一侧。
七、JDK 自己怎么做池
JDK 里有现成的池化实现,都是缓存的形态:IntegerCache、Byte/Short/Long/Character 的缓存、Boolean.TRUE、字符串常量池。共同点是缓存的都不可变:不需要重置与归还,也不会被借用者改脏。
IntegerCache 是最典型的一个,JDK 25 Integer.java:932-937:
1 | private static final class IntegerCache { |
入口在 Integer.java:1003-1007:
1 | public static Integer valueOf(int i) { |
缓存的建立方式:上界可以用 java.lang.Integer.IntegerCache.high 属性调(下限固定 -128,assert IntegerCache.high >= 127 保证 [-128,127] 一定被缓存),这份数组还随 CDS 归档打进镜像:启动时从共享归档恢复,不重新构造。一个每次调用都要走的缓存,成本被挪到了构建期。
ThreadLocalMap 是另一种形态,ThreadLocal 池就是它。每个 Thread 对象上挂一个 Map,键是 ThreadLocal 实例,值是缓存的对象,ThreadLocal.java:358-368:
1 | static class ThreadLocalMap { |
查找是一条线性探测,ThreadLocal.java:485-491:
1 | private Entry getEntry(ThreadLocal<?> key) { |
两个设计决定:键是弱引用,ThreadLocal 对象一死,条目会在后续访问里被清掉;值是强引用,只要线程活着、条目没被清掉,缓存的对象就一直被线程按着。线程池里的线程恰好活得很久,「ThreadLocal 缓存昂贵对象」这个反模式的机制就在这里。
虚拟线程把这个机制放大了一层。平台线程上这是「每线程一个实例」,虚拟线程可以到百万级,同一个池会变成「每虚拟线程一个实例」,内存随并发线性增长。JDK 的应对是 ThreadLocal.getCarrierThreadLocal 与 ScopedValue:前者把值挂到载体线程(数量有界),后者把生命周期绑到作用域上。
真实世界的池长什么样
生产代码里最出名的对象池是 Netty 的 PooledByteBufAllocator,池化的正是 DirectByteBuffer 这类对象:direct buffer。
它按线程分片。默认 Arena 数量是 2 * 可用处理器,源码里的注释直接写着理由:「如果选更小的值,会撞上热点,因为分配与释放需要在 PoolArena 上同步」(PooledByteBufAllocator.java 的静态初始化块,Netty 4.1)。线程通过 PoolThreadLocalCache 绑定到某个 Arena,把「有锁池」那一列的结构改成「ThreadLocal 池」那一列。
它还有一层按尺寸分级的线程本地缓存:smallCacheSize 默认 256、normalCacheSize 默认 64,缓存对象上限 32 KiB(maxCachedBufferCapacity),每 8192 次分配做一次 trim。这一层是为「频繁借还同一批尺寸」准备的,避免每次都回到 Arena 的队列上。
它还按尺寸分池,因为容量上限对 tiny/small/normal 三种规格的意义不同,混在一个队列里会让碎片与容量都失控。
三条设计对应前面测出的三点:构造成本高(native 内存加 Cleaner),池化收益就是十倍量级;借用频率高,按线程分片避开锁;对象尺寸差异大,按尺寸分池,给常用的几档开线程本地缓存。
八、什么时候用,什么时候不用
    flowchart TD
    Q1["构造一次要多少 ns"] -->|"100 ns 级"| N1["并发高于 4 线程就别池化,直接 new"]
    Q1 -->|"几百 ns 到微秒"| Q2["构造里有没有全局资源:native 内存、文件描述符、熵源、连接"]
    Q2 -->|"有"| Q3["用完能不能把状态重置干净"]
    Q2 -->|"没有"| Q4["先量一次:把构造成本和峰值线程数下的借还成本比一下"]
    Q3 -->|"能"| P1["用池,边界按峰值线程数定容量"]
    Q3 -->|"不能"| N2["换每次 new,或者改成不可变后共享"]
    Q4 --> P1
用池的场合:
- 构造成本在几百纳秒以上,或者构造过程要过全局资源。 本次两组贵对象都是这个形状,池化收益 7 到 14 倍,而且随线程数变大。
- 对象数量天然有界。 连接池、线程池、缓冲池的上限来自外部资源,池容量是硬件约束的体现,不是拍脑袋的数字。
- 重置是常数时间。
buffer.clear()、cursor = 0这类一行重置。
不用池的场合:
- 便宜对象加高并发。 1 KiB 数组这一组,8 线程以上池化净亏,加线程越多亏越多。
- 重置比构造还贵。 需要清零整块内存、清空集合、重置加密上下文的对象,把重置成本代入不等式右边,多数会翻到负号一侧。
- 对象持有线程亲和的资源。 ThreadLocal 池在虚拟线程下按每实例一份内存放大,这类场景要用载体线程局部变量或者作用域变量。
- 只为「少分配」而池化。 分配本身是并行的,也便宜,短命对象交给 GC 就行。池化省下来的分配时间经常小于它引入的同步时间。
在线上怎么判断池已经变成负优化
三个信号,都能从现成的指标里读出来。
借出等待时间随并发上升,而构造成本没变。 这说明已经越过交叉点。ReentrantLock.getQueueLength()、HikariCP 的 pending 与 usage、Netty 的 PooledByteBufAllocatorMetric 都是现成的入口。等待时间从几十纳秒涨到几百纳秒的时候,池已经不再带来收益。
并发翻倍而吞吐不动。 池的吞吐是一条水平线。压测时把并发从 8 拉到 16,如果吞吐不涨、锁等待涨,池正在还债。
池化之后 GC 次数没降。 池化的预期收益之一是少产生垃圾。如果池化前后 young GC 次数一样,说明热点分配的对象不在这批池化的实例里,池白做了。
最直接的办法是 A/B:把池换成 new 跑一轮,比较峰值并发下的吞吐。前面那套基准就是模板,一次运行几分钟,比任何设计讨论都快。
一条判断顺序:先量构造一次的纳秒数;超过几百就往下走,否则直接 new。再看构造里有没有全局资源,有的话池化收益会随并发放大。最后确认重置是常数时间、池容量有外部依据,两个条件缺一个,先把池换成 new,量一轮再决定。
总结
- 池化把分配成本换成同步成本。分配走线程私有 TLAB,可扩展;借还抢共享队列,不可扩展。判据是
C_new > C_borrow(n) + C_reset。 - 1 KiB 数组(1 064 B/op):
new单线程 9.5 M op/s(105.7 ns),有锁池 38.7 M(25.9 ns),池化赢 4 倍。 - 同一个对象 8 线程时反转:
new44.0 M 对池 24.7 M;16 线程 44.4 M 对 24.4 M。交叉点在 2 到 4 线程之间。 - 有锁池的吞吐几乎不随线程数变化(38.7 → 24.7 → 24.4 M op/s)。16 线程时每次借还摊 655 ns,单线程 25.9 ns,差在等锁。
new1 KiB 数组在 8 线程后撞天花板:44.4 M op/s 乘以 1 064 字节是 47 GB/s 分配速率,1 秒 149 次 GC,占用 87 ms。分配并行,回收不并行。- ThreadLocal 池是零同步上界:212 → 894 → 941 M op/s,两个 JDK 一致,1 秒窗口里 0 次 GC。
ByteBuffer.allocateDirect(1024)的new没有扩展性(1.30 → 1.49 → 2.29 M op/s),16 线程时每次分配摊到 7.0 µs;有锁池快 10.8 倍。- 贵对象
new的 GC 时间不正常:每 op 只分配 152 字节堆内存,单次 young GC 却是 74 ms,而 1 KiB 数组那组每 op 分配 1 064 字节、单次 GC 只要 0.6 ms。差在 Cleaner 的引用处理。 - 源码层面的原因是四步构造里两步全局串行:
Bits.reserveMemory的 CAS 循环抢三个全局原子量(Bits.java:188-203),Cleaner.create走private static synchronized Cleaner add(jdk/internal/ref/Cleaner.java:76)。释放侧对应static synchronized remove(:85)。 new SecureRandom()的构造成本在两个 LTS 之间差 5 倍:JDK 21 每次 846 到 1198 ns、分配 2 016 字节,JDK 25 是 219 到 365 ns、408 字节。算法相同(都是 NativePRNG),-Xint下差距不变,所以差在实例化路径,不在 JIT。- 有锁池的借还成本几乎与对象无关(单线程 26 到 32 ns,16 线程 40 到 61 ns),它只随线程数变;构造成本决定了池化的收益方向。
- JDK 自己的池只缓存不可变对象:
IntegerCache缓存[-128,127](Integer.java:932-937、:1003-1007),数组随 CDS 归档,成本挪到构建期;ThreadLocalMap把缓存挂在Thread上,键弱引用、值强引用,线程活得越久按得越牢。 - 测量侧的一个坑:把反逃逸的出口放在共享
volatile上,8 线程以上这条缓存行就成了所有策略的共同瓶颈,ThreadLocal 池从 212 M 掉到 95 M;改成每线程独占槽位后同一份代码跑到 894 M。
参考资料
- ByteBuffer.allocateDirect (Java SE 25)
- DirectByteBuffer (Java SE 25)
- ThreadLocal (Java SE 25)
- Integer.valueOf (Java SE 25)
- ReentrantLock (Java SE 25)
- ThreadMXBean (Java SE 25)
- GarbageCollectorMXBean (Java SE 25)
- SecureRandom (Java SE 21) / Java SE 25
- JEP 444: Virtual Threads
- Netty PooledByteBufAllocator(4.1 分支源码)
- 相关篇目:享元:共享不可变状态、单例的五种写法与代价、原型:拷贝的四条路、工厂方法:创建动作的成本、被语言吃掉的那些模式
系列索引:设计模式系列