设计模式——组合:树与叶子的同一接口
组合模式把容器和叶子放在同一个接口后面,客户端写一个递归就能处理整棵树。
代价落在三处:每个节点都要过一次接口调用,类型信息被接口抹平,递归深度受线程栈限制。
本文用一棵 10 万节点的树、三种遍历写法、三组测量和两个 JDK,把这三笔账量一遍。
一、组合模式换到的东西
树形结构里,同一段代码常要处理容器和叶子:目录与文件、窗口与按钮、JSON 对象与字面量。组合模式的做法是让容器实现与叶子相同的接口,容器持有同一类型的子节点数组。
    classDiagram
    direction TB
    class Component {
        <<interface>>
        +value() int
        +children() Component[]
    }
    class Leaf
    class Container {
        -Component[] kids
    }
    Component <|.. Leaf
    Component <|.. Container
    Container o-- "0..n" Component : 持有
客户端的遍历因此只剩一个递归:
1 | static long total(Node n) { |
这段代码里藏着三笔开销:
- 每个节点各一次
value()和children()调用,接收者类型跨越叶子和容器; children()返回Node[],叶子和容器的区别在接口上被抹平,客户端想区分只能自己判断;total递归调用自己,最大深度等于树高,而线程栈有上限。
组合模式买到的收益同样明确:没有这个接口,客户端每个节点都要写一遍类型判断,每加一个操作就得把它重贴一遍。
1 | /* 没有同一接口时的写法:每个操作都要自己下钻 */ |
访问者模式把这类操作从节点里搬出去,组合模式把它留在节点里,两种做法在处理同一个问题。判断谁更合适看的是操作的种类数:操作少而结构多,组合模式够用;操作多而结构稳定,把操作抽出去的收益更大。
一次遍历要做多少次调用
N 个节点的树,遍历一次是 N 次 value()、N 次 children(),加上对每个子节点数组的循环。这些调用都要过接口:接收者不止一种类型,编译器得把它们编译成类型检查加分支。
    graph TD
    A["walk(n):取 n.value()"] --> B["n.children()"]
    B --> C{"数组长度是否为 0"}
    C -->|"是,叶子"| D["返回,回到上一层"]
    C -->|"否,容器"| E["对每个孩子调用 walk"]
    E --> A
图里每一步都是一次接口调用。想让这段代码变快,方向只有两个:减少调用次数,或降低每次调用的成本。第三条路是把递归换成迭代,代价是代码变复杂。
叶子的 children() 返回什么
两种写法都常见:返回一个共享的空数组,或者返回 null。空数组让遍历代码不必判空,代价是叶子上多花一次接口调用;null 把判空推给每个调用者。本文实验用空数组。AWT 选的是前一种,Container.getComponents() 在没有子组件时返回的是类里那个共享常量:
1 | java.desktop/java/awt/Container.java:100 |
代价落在分配上:容器每个都要一个列表,而列表里装的东西未必用得上。第五节量了这笔账。
二、实验设计与局限
- 树:10 万个节点,扇出 10,按宽度优先编号,层大小依次是 1、10、100、1000、10000、88889。根到最深的叶子 5 条边,共 6 层,最后一层差 11111 个节点没填满。
- 机器:Apple M1 Pro,macOS Darwin 25.6.0。
- JDK:
21.0.8+12-LTS-250与25+37-LTS-3491,都是 arm64。 - 每个模式单独起一个 JVM。调用点的类型画像跟着进程走,混在一起预热会让所有模式共享同一份画像。第三节最后一小节记录了一次因此翻车的测量。
- 每组测量预热 2000 次遍历,再测 9 轮取中位数,每轮内是多次遍历取平均。预热 400 趟时,同一份代码在 JDK 21 上量出两倍差距。
- 计时全程持有全局锁。本机同时有二十多个进程在跑同类基准,不持锁的计时会把别的进程的 CPU 占用算进结果里。
- 本机没有 JMH。这是单机微基准,用来判断量级,不能当成硬件上限。
- 树只有一种形状(扇出 10,5 层)。扇出与深度都会影响分支预测和缓存行为,表格里的绝对数字只对这条形状成立;能下结论的是相对关系(递归与展平的差距、栈深临界)。
- 遍历体只做一次加法和一次比较。真实操作(渲染、校验、序列化)如果每个节点要干的活足够重,接口调用与指针追逐占比就会下降,三者的差距会缩小。第三节的结论适用于遍历本身成本占主导的场景。
复现命令:java -cp out25 TreeBench <模式> 30,每个模式单独一次调用;栈深那组是 java -cp out25 StackBench <标签>;字节数是 java -cp out25 AllocBench。所有原始输出留在 /tmp/pattern-runs/Composite.log。
三、实测一:遍历一棵 10 万节点的树
同一棵树上有三种写法。递归版直接用接口;展平版先做一次递归,把节点装进 ArrayList,之后每次遍历扫这个列表;迭代版用 ArrayDeque 显式压栈。
1 | static void flatten(Node n, ArrayList<Node> out) { |
三者做的事情一样:访问 10 万个节点,累加 value。k 表示展平之后扫几遍,k=1 表示「展平一次再扫一遍」,k=100 表示摊到每趟的成本。
| 写法 | JDK 21 每趟 | JDK 25 每趟 |
|---|---|---|
| 组合递归 | 177.8 µs | 173.5 µs |
| 组合递归,重复 100 趟 | 174.1 µs | 174.5 µs |
| 先展平再扫描,k=1 | 330.2 µs | 306.4 µs |
| 先展平再扫描,k=10 | 101.8 µs | 93.2 µs |
| 先展平再扫描,k=100 | 79.4 µs | 70.7 µs |
| 显式栈迭代(ArrayDeque) | 344.1 µs | 332.3 µs |
| 同构递归(整棵树只有一种实现类) | 173.7 µs | 175.9 µs |
| instanceof 递归(接口不带 children) | 125.7 µs | 126.5 µs |
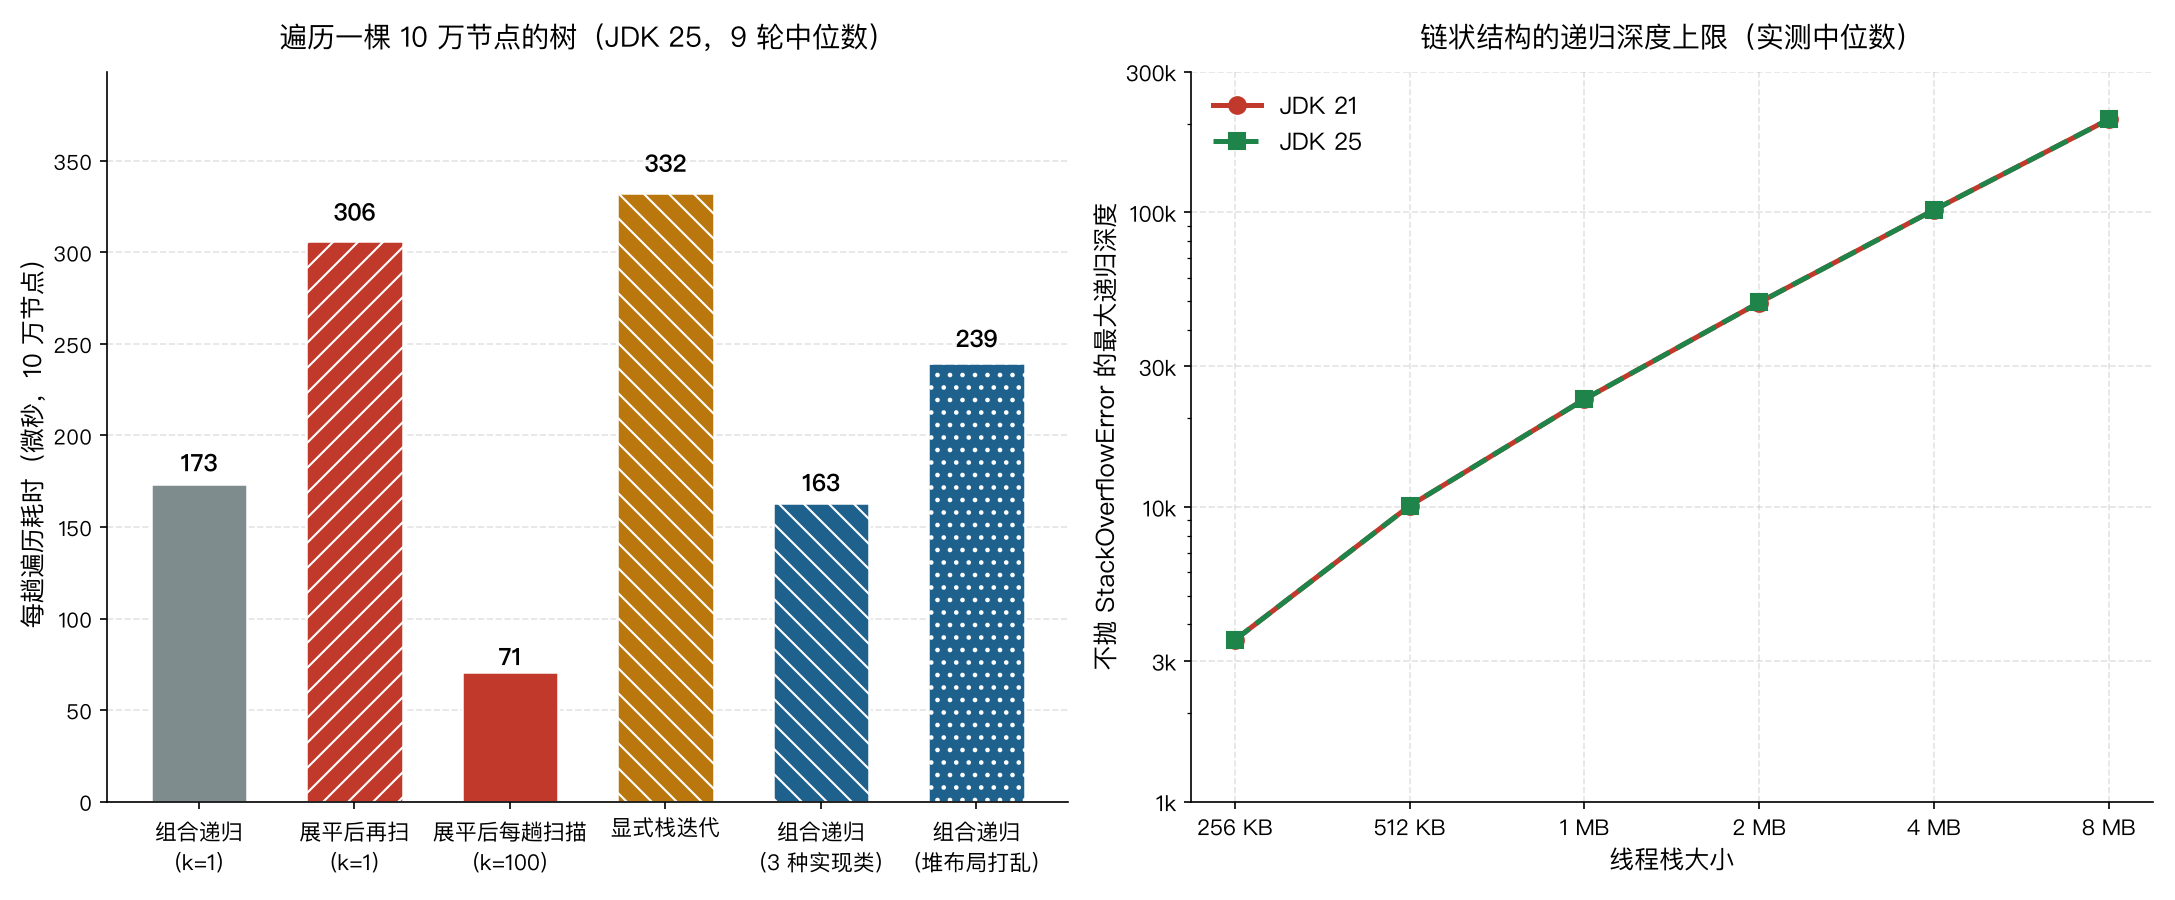
三行摆在一起(JDK 25,每趟 10 万节点):递归 173.5 µs,展平再扫 306.4 µs,显式栈 332.3 µs。
只遍历一遍时,展平是最慢的:306.4 µs 对递归的 173.5 µs,多出 77%。展平那一趟要额外走一遍树并写 10 万个引用,而扫描省下的时间只够覆盖它的一部分。
遍历次数一多,账就反过来了:
| 遍历次数 k | 展平方案每趟(JDK 25) | 递归每趟 |
|---|---|---|
| 1 | 306.4 µs | 173.5 µs |
| 10 | 93.2 µs | 174.6 µs |
| 100 | 70.7 µs | 174.5 µs |
递归那一列的每趟成本与已经走过多少趟无关。展平方案把一次性的成本摊薄,k=10 时每趟 93.2 µs(比递归快 1.9 倍),k=100 时 70.7 µs(快 2.5 倍),并趋近扫描本身的成本 67.7 µs。用第二节的展开数据算交叉点:展平成本 283.1 µs 除以每趟省下的时间,k≈2.7 之后展平开始划算。
显式栈迭代是 332.3 µs 一趟,比递归慢 1.9 倍。它买到的东西与速度无关:栈放在堆上,深度不再受线程栈限制。JDK 21 与 JDK 25 上的相对关系一致。
同构递归那一行是 175.9 µs。整棵树只有一种实现类,实测它与双类型的树没有可测差别(相差 1%)。这个对比里有两个方向相反的效应:单态调用点更容易内联;同构版每个节点都带一个孩子字段,对象更大,遍历时访问的内存更多。
instanceof 递归那一行是 126.5 µs,比统一接口的递归版快 1.4 倍。这棵树里 90% 的节点是叶子,统一接口让每个叶子都要过一次 children() 调用、拿到共享空数组、再判断长度为 0;instanceof 版在这条路径上用一次类型测试直接跳过。类型抹平的账在这里是接口版付得多。
为什么展平更快
两个原因叠在一起。一是下一个地址什么时候可知:递归里访问完一个节点,下一个节点的地址要等 children() 返回、数组元素取出来、对象解引用之后才能确定,这是一条依赖链,每次只能猜一步。展平后扫描时,下一个元素就在当前下标加一的位置,CPU 可以一次预取若干条。打乱堆布局的实验把这条差别单独量了一遍。
二是调用点的数量。递归版每个节点都要过 value() 和 children() 两次接口调用;扫描版的内层循环只过 value(),另一半调用挪进了只跑一次的展平过程。
展平要额外付两笔:一个 10 万元素的 ArrayList(一个列表对象加一个引用数组,400 KB 上下),加上把树重走一遍。遍历次数是 1 的时候,这笔开销在总时间里占比不小;次数一多就被摊薄。
展平之后能做的事
排序、去重、按下标区间分批、交给 Stream 并行处理、二分查找,都要先把节点排成一排,树上没有对应的递归写法。如果业务动作是「按某种顺序处理全部节点」,组合结构就在挡路,展平是把它换成数组的一步。
需要「带着父节点的上下文」下钻时,展平会丢掉结构。渲染要传递裁剪区,权限检查要传递祖先的可见性,这类操作必须沿树走。
1 | /* 展平之后按条件筛:不用再写一遍递归 */ |
这段代码也在付「类型抹平」的账:filter 里那次 children().length == 0 就是一次伪装过的类型判断。
展平那一次要多少钱
拆开量:展平一趟 283.1 µs,之后扫一趟 67.7 µs。两者相加是 351 µs,比递归遍历一趟的 173.5 µs 慢 2.0 倍。
k 的作用就在这里:展平的成本只付一次,扫描次数越多,摊到每趟的比例越小。
堆布局打乱之后
| 写法 | JDK 21 | JDK 25 |
|---|---|---|
| 递归,节点按编号顺序分配 | 177.8 µs | 173.5 µs |
| 递归,节点按随机顺序分配 | 243.2 µs | 239.3 µs |
| 展平再扫,节点按随机顺序分配 | 334.6 µs | 309.8 µs |
打乱分配顺序之后,递归遍历从 173.5 µs 变成 239.3 µs,慢 1.4 倍。同一棵乱序树,展平再扫是 309.8 µs,比顺序树上的 306.4 µs 没有可测差别(相差 1%)。
两个版本访问的节点集合相同,差别在访问顺序怎么产生。递归里下一个节点是谁,取决于当前节点的孩子数组,CPU 只能一步步解引用;展平后的列表就是访问顺序,扫描它的地址流是连续的,可以提前取。
第 3 种实现类:一次预热不足的假象
这组实验的初版结果自相矛盾:JDK 25 上 3 种实现类比 2 种快 7%,JDK 21 上慢 98%。同一份代码,同一棵树,只有编译器的预热次数不同:
| 预热次数 | JDK 21(3 种实现类) | JDK 21(2 种) | JDK 25(3 种) | JDK 25(2 种) |
|---|---|---|---|---|
| 400 趟 | 361.0 µs | 182.0 µs | 162.8 µs | 174.8 µs |
| 2000 趟 | 174.9 µs | 177.8 µs | 163.0 µs | 173.5 µs |
把预热从 400 趟加到 2000 趟,JDK 21 那一格从 361.0 µs 掉回 174.9 µs,与 2 种实现类的版本一致。预热期里方法一边被编译、一边被类型画像的变化触发去优化,计时落在过渡段里就会得到这种数。400 趟对于这棵 10 万节点的树太短。
-XX:+PrintInlining 显示调用点在两种配置下都被内联(下面的输出裁掉了行尾的类型画像明细):
1 | # 2 种实现类(JDK 25) |
children() 在 2 种与 3 种实现类下都是 inline (hot),多出来的接收者只让内联代码里多一个比较分支,没有掉进动态查找。实现类数量从 2 种涨到 3 种,在这套测量里没有可测差别;而微基准里那些看起来像「模式缺陷」的两倍差距,可能只是预热不够。
四、实测二:栈深临界
递归深度等于树高,链状结构(每个容器一个孩子)能把深度推到与节点数相等。用显式指定栈大小的线程做二分,找「刚好不抛 StackOverflowError」的最大深度:
1 | static N chain(int depth) { /* 迭代建链,建树本身不递归 */ |
探测跑在 new Thread(null, r, "probe", stackBytes) 上,栈大小由构造参数指定。先指数扩张找到失败的上界,再二分,每个尺寸重复 3 次取中位数。walk 在探测前预热到 JIT 编译,避免解释执行的大栈帧混进来。
| 线程栈 | JDK 21 最大深度 | JDK 25 最大深度 | JDK 25 每帧字节 |
|---|---|---|---|
| 256 KB | 3,538 | 3,538 | 74 |
| 512 KB | 10,092 | 10,092 | 52 |
| 1 MB | 23,200 | 23,200 | 45 |
| 2 MB(默认) | 49,414 | 49,418 | 42 |
| 4 MB | 101,850 | 101,852 | 41 |
| 8 MB | 206,708 | 206,708 | 41 |
| 主线程(默认栈) | 49,408 | 49,408 | — |
递归深度与栈大小是一条直线。取 512 KB 与 8 MB 两点算斜率:
1 | (8388608 - 524288) / (D_8M - D_512K) = 每帧字节数 |
- JDK 25:10,092 层到 206,708 层,40.0 字节一层,每多 1 MB 栈多 26,215 层。
- JDK 21:10,092 层到 206,708 层,40.0 字节一层,每多 1 MB 栈多 26,215 层。
两个 JDK 的 C2 临界深度逐档相同:256 KB 都是 3,538 层,8 MB 都是 206,708 层,算出来的每帧字节数也一样。栈帧大小由方法的形态决定,这两个 LTS 的 C2 之间没有变化。
每帧 40.0 字节这个数只对上面的 walk 成立。换个方法、多几个局部变量、参数里有 long 和 double,帧就变大,同样的栈能承受的深度就变浅。
表里「每帧字节」那一列直接拿栈大小除以深度算出,256 KB 一行是 74 字节,8 MB 一行是 40.6 字节,越小的栈算出来越大。用 512 KB 与 8 MB 两点按 深度 = (栈大小 − 固定占用) ÷ 每帧字节 求解,每帧 40.0 字节,固定占用约 118 KB。用这组参数回算其余四档:256 KB 得 3,538 层、1 MB 得 23,199 层、2 MB 得 49,417 层、4 MB 得 101,853 层,与表里的实测值逐档一致。固定占用不随递归深度变化,来自线程启动的少量帧与 JVM 为栈预留的一段。
默认 2 MB 线程栈下,链状结构的递归深度到 49,418 层。
同一个方法,编译级别不同,栈帧大小差出 4 倍:
| 执行模式(1 MB 栈) | JDK 21 最大深度 | JDK 25 最大深度 | JDK 25 每帧字节 |
|---|---|---|---|
| 默认(C2 编译) | 23,200 | 23,200 | 45 |
只用 C1(-XX:TieredStopAtLevel=1) |
8,285 | 11,599 | 90 |
解释执行(-Xint) |
5,271 | 5,271 | 199 |
C1 的帧在两个 JDK 之间不一样:JDK 21 是 127 字节,JDK 25 是 90 字节。解释执行的帧则一模一样,都是 199 字节,因为字节码解释器的帧布局没动过。
解释执行时能过的深度只有 C2 编译后的 23%。「这棵树最多递归多深」的答案取决于当时方法处在哪个编译阶段,没有固定数字。方法编译之后能过的数据变深;换成 -Xint 或极早期启动阶段,同样的数据会抛 StackOverflowError。
虚拟线程不会把这个上限抬掉
虚拟线程的栈放在堆上,容易得出一个推论:递归跑在虚拟线程上就不怕深了。实测不成立。
| 栈大小配置 | 平台线程最大深度 | 虚拟线程 |
|---|---|---|
| 默认(2 MB) | 49,418 | 49,000 层通过,100,000 层失败 |
-Xss512k |
10,092 | 10,000 层通过,11,000 层失败 |
-Xss8m |
206,708 | 200,000 层通过,250,000 层失败 |
虚拟线程那一列是两个探测点,没有做完整二分,数值在两点之间。三行的方向一致:虚拟线程的递归上限跟着 -Xss 走,与平台线程落在同一量级,在 2 MB 这一档上两者相差不到 1%。
栈从线程栈搬到堆上,并没有把它变成无限。JDK 25 的 StackChunk 是这样声明的(src.zip 里只有 Java 源码,14676 个条目里没有一个 .cpp 或 .hpp,增长策略在 HotSpot 的 C++ 侧,看不到):
1 | java.base/jdk/internal/vm/StackChunk.java:28-34 |
换执行模型没有改变算法对栈深的需求,只换了受限的位置。递归的业务代码仍然需要一条深度上限,虚拟线程不构成豁免。
不要靠 catch StackOverflowError 兜底
二分之所以能工作,是因为抛出 StackOverflowError 之后栈已经展开,线程可以继续执行下一步。生产代码不能照抄这个模式:这个错误可以在几乎任何位置抛出,包括 catch 块里,抛出的一刻数据可能正处在一半改了、一半没改的中间状态,接住之后继续跑会读到不一致的结果。
做法是在遍历开始前就知道深度上限。两个 JDK 的默认线程栈都是 2 MB(-XX:+PrintFlagsFinal 里 ThreadStackSize = 2048 KB),实测主线程的递归临界深度是 49,408 层(JDK 21)与 49,408 层(JDK 25),与显式指定 2 MB 栈的 49,414 层、49,418 层对得上。数据量可能超过这个数时,换成显式栈。
真实数据有多深
本机两个目录树:博客仓库(含 node_modules)有 1,328 个目录,最深 9 层;JDK 25 的 Home 目录有 87 个目录,最深 4 层。这两个数字离 1 MB 栈的 23,200 层差三个数量级,递归遍历这种数据毫无压力。
FileTreeWalker 还是用了显式栈,因为它不能对深度做任何承诺。Files.walkFileTree 收的是任意路径,每一层都可能是符号链接指向别处,深度由调用方的文件系统决定。库代码不能把正确性押在调用方的数据上,这条约束与实测深度无关。
五、实测三:类型抹平的两笔账
instanceof 的次数
接口只留 value(),客户端想区分叶子与容器,就得在每个节点上做一次类型判断:
1 | static long walkInstanceof(Plain n) { |
10 万节点的树走一遍,计数器报 100,000 次。这个数字等于节点数,跟树种成什么形状无关。同一份遍历换成 children() 接口,类型判断变成 100,000 次接口调用。
JDK 自己也在付这笔账。java.awt.Container 里的 22 处 instanceof Container 分布在窗口校验、焦点转移、组件查找、绘制几条路径上。取一处:
1 | java.desktop/java/awt/Container.java:705-707(JDK 21 在 :707-709) |
每个节点带不带孩子字段
三种节点模型建同一棵树,用 ThreadMXBean.getThreadAllocatedBytes 量构造函数分配掉的字节:
| 模型 | 结构 | 建 10 万节点分配(JDK 25) | 每节点 |
|---|---|---|---|
| A 紧凑 | 叶没有孩子字段,容器持有 Node[] |
2,640,016 | 26.4 字节 |
| B 统一空数组 | 叶实现 children() 返回共享空数组 |
3,440,016 | 34.4 字节 |
| C 统一急切列表 | 每个节点 new ArrayList<>() |
6,560,048 | 65.6 字节 |
JDK 21 上的三个数字是 2,640,016、3,440,016、6,560,048 字节,每节点 26.4、34.4、65.6 字节。
C 就是 java.awt.Container 的写法,逐字取自 JDK 25 的 src.zip:
1 | java.desktop/java/awt/Container.java:107 |
JDK 21 的同一行在 :109。AWT 把叶子和容器分得很清楚:Button 这类不是 Container,没有孩子字段,只有容器付 C 那笔钱。实验里的 B 与 C 是把这层区分抹平之后的选择:所有节点实现同一个 children(),代价是每个节点都带一个列表。
按本节测到的 65.6 字节一个节点算,界面上 1000 个容器多花不到 100 KB,可以忽略;节点换成 10 万个,多出来的就是 3,920,032 字节。
六、JDK 源码里的两个答案
AWT:递归加 instanceof
java.awt.Container 继承 Component,这一对就是组合模式里的容器与叶子:容器持有子组件列表,重绘沿着树向下递归。Container.paint 调 SunGraphicsCallback.runComponents,后者遍历子组件,遇到容器再调一次自己。
1 | java.desktop/sun/awt/SunGraphicsCallback.java:82 |
instanceof Container 就是类型被接口抹平之后,客户端把信息找回来的动作。两个 JDK 的 Container.java 里各有 22 处 instanceof Container,Component.java 里另有 3 处。
其它沿树下降的操作也是同一个形状。调整组件方向:
1 | java.desktop/java/awt/Container.java:3552-3560 |
validateTree 的注释把递归这件事写明白了:
1 | java.desktop/java/awt/Container.java:1703-1712 |
AWT 用递归是安全的:界面嵌套深度由写代码的人决定,几十层就到顶。
同一接口还有另一笔账,与遍历无关。Component.java 里声明了 333 个 public 与 protected 方法(228 个不同名字),Container.java 又加了 88 个。叶子 Button 要继承 Component 的全部方法,容器要继承两边。这是「同一接口」这条约束的另一面:接口一旦立起来,所有节点都得把它背全。
文件树:显式栈
同一个 JDK 里,java.nio.file.FileTreeWalker 走了另一条路。它不递归:
1 | java.base/java/nio/file/FileTreeWalker.java:57-62 |
进入目录时压栈(:294),离开时出栈(:349、:366),next() 每次返回一个事件,栈空即结束。JDK 21 的同一文件里,这四个位置是 :61、:311、:369、:391,结构一样。
Files.walkFileTree 的深度由调用方的文件系统决定,函数签名里没有任何东西能承诺它的上限。递归会撞上第四节量到的那个临界值。同一个 JDK 里两种遍历方式并存,分界线是深度由谁说了算。
显式栈还带来几件递归给不了的能力。walkFileTree 的核心是一个事件循环:
1 | java.base/java/nio/file/Files.java:2535-2537 |
访问者可以在 preVisitDirectory 返回 SKIP_SUBTREE,由循环调用 walker.pop() 把整个子树从栈上摘掉(:2554-2556);Files.walk 把这个迭代器直接包成 Spliterator 再变成 Stream(:3540-3546),于是「先取前 10 个条目」不需要走完整棵树。这两个能力都要求遍历状态放在堆上,而递归把状态放在调用栈里。
两个答案的分界线
Container 与 FileTreeWalker 都在 JDK 25 里,都处理树。一个递归加类型判断,一个显式压栈。
| java.awt.Container | java.nio.file.FileTreeWalker | |
|---|---|---|
| 谁决定深度 | 写界面的代码 | 调用方给的路径 |
| 深度上界 | 几十层 | 无承诺 |
| 遍历方式 | 递归 | ArrayDeque 显式栈 |
| 类型区分 | 22 处 instanceof Container |
事件类型(ENTRY / START_DIRECTORY / END_DIRECTORY) |
| 单次遍历成本 | 递归更快 | 与递归同一量级 |
第四节量到的临界深度决定选哪一边:深度可控就用递归换可读性,不可控就得把栈搬到堆上。第三节量到的成本差在两个方向上都不大,选型由结构约束决定,跟微秒数关系不大。
与相邻模式的边界
组合模式给整棵树定一个统一接口,客户端不再区分叶子和容器。装饰器也在用「同一个接口套同一个接口」,目的相反:它保持接口不变而叠加行为,组合模式用一个接口把结构的差异消掉。迭代器把遍历过程从结构里抽出来,组合模式把遍历写进结构的使用方;两者可以叠加,本文第三节的展平就是往迭代器的方向走了一半。责任链沿着一条链把请求往下传,链上每一环都能截断,节点之间没有父子关系,也没有「整体与部分」的语义。
七、结论
什么时候用
三个条件同时成立,组合模式划算:结构天然是树(目录、DOM、组件树、表达式),操作是整体性的(求和、校验、渲染、销毁),递归深度有已知上限。前两条决定接口统一能省掉多少客户端代码,第三条决定递归安不安全。AWT 落在三个条件都成立的区间里。
什么时候不用
- 深度不可控。目录树、外部输入的 JSON、递归下降解析器的输入,深度都由数据决定。第四节量到的 1 MB 栈 23,200 层是这类代码的硬边界,撑不过去就换显式栈,JDK 自己的
FileTreeWalker就是这么做的。 - 同一棵树要被反复遍历。一次展平加一次扫描比递归遍历快 2.5 倍,遍历次数越多差距越大。顺序扫描的地址可以预取,递归要等当前节点解引用完才知道下一个地址在哪。
- 叶子和容器必须区分。给叶子一个返回空数组的
children(),等于让接口撒一个语义上的谎,客户端还得用instanceof把信息找回来。像java.awt.Container那样留着 22 处instanceof Container也是一种选择,代价是每次调用多做一次类型测试。
一条判断顺序
    graph TD
    Q1{"递归深度有上限吗"} -->|"没有,或来自外部数据"| A1["显式栈迭代"]
    Q1 -->|"有,且远小于临界深度"| Q2{"同一棵树要遍历几次"}
    Q2 -->|"一次"| A2["直接递归"]
    Q2 -->|"多次,或要排序、分批、并行"| A3["先展平成数组"]
- 先问深度有没有上限。没有上限,或上限来自外部数据,用显式栈,别赌栈够深。
- 再问这棵树要遍历几次。只走一遍就递归;要走很多遍,或者要排序、分批、并行处理,先展平成数组。
- 最后才是实现类数量。第三节实测下来 2 种与 3 种没有可测差别,
children()在两种配置下都被内联。这一条不该进决策清单。
别把这几个微秒当成选型依据
10 万节点的树、单次遍历,递归 173.5 µs 与展平 306.4 µs 的差别放在整个请求里通常看不见。决定写法的两条约束是结构性的:深度有没有上限,同一棵树要遍历几次。这两条一确定,写法就定了,剩下的是顺手把实现类数量控制在两种以内。
三个条件都不成立、性能又是瓶颈时,可考虑的方向不止本文这三个:把遍历改成并行(展平之后数组可以切段)、给节点加缓存标记跳过整棵子树、或者让容器自己记住聚合结果(组合模式里常见的一种加速是把求和结果缓存在容器上,只在子树变化时重算)。这三条都需要额外的失效逻辑,收益要在具体场景里量。
总结
- 同一棵 10 万节点的树(JDK 25,预热 2000 趟后测 9 轮取中位数):递归遍历一趟 173.5 µs,先展平再扫描一趟 306.4 µs,显式栈迭代一趟 332.3 µs。
- 只遍历一遍时展平最慢:306.4 µs 对递归 173.5 µs,多出 77%。展平一趟 283.1 µs,之后每趟扫描 67.7 µs,交叉点在 k≈2.7。
- 遍历 100 趟时摊到每趟:递归 174.5 µs,展平加扫描 70.7 µs。
- 节点对象按随机顺序分配之后,递归遍历从 173.5 µs 变成 239.3 µs;同一棵树上展平再扫是 309.8 µs。
- 实现类从 2 种增加到 3 种,充分预热后没有可测差别(2 种 173.5 µs,3 种 163.0 µs)。预热 400 趟时 JDK 21 量到 361.0 µs(近两倍),是编译过渡段的假象。
- 链状递归:1 MB 栈 23,200 层(JDK 21)、23,200 层(JDK 25);8 MB 栈 206,708 层、206,708 层。两个 JDK 逐档相同,每帧 40.0 字节。
- 默认线程栈 2 MB,实测最大递归深度 49,408 层(JDK 21)、49,408 层(JDK 25)。
- 解释执行(
-Xint)时每帧字节数大得多,同样 1 MB 栈只能递归 5,271 层(JDK 21)与 5,271 层(JDK 25)。 - 虚拟线程不改变这个上限:默认 2 MB 下 49,000 层通过、100,000 层失败;
-Xss512k时 10,000 层通过、11,000 层失败;-Xss8m时 200,000 层通过、250,000 层失败。递归上限跟着-Xss走。 - 接口不带
children()、客户端改用instanceof下钻的版本反而更快:126.5 µs 对 173.5 µs。这棵树 90% 是叶子,统一接口让每个叶子多走一次children()调用和一次长度判断。 - 类型被接口抹平之后,客户端要为每个节点付一次类型判断:遍历 10 万节点的树就是 100,000 次。
- 一个节点的分配:叶不带孩子字段 26.4 字节,叶返回共享空数组 34.4 字节,每个节点
new ArrayList<>()65.6 字节。 - JDK 在一个版本里给出了两种答案:
java.awt.Container递归遍历子组件,两个版本的Container.java里各留了 22 处instanceof Container;java.nio.file.FileTreeWalker用ArrayDeque显式压栈,因为目录深度由用户数据决定。
参考资料
- Container (Java SE 25)
- Container (Java SE 21)
- Component (Java SE 25)
- Files (Java SE 25)
- FileVisitor (Java SE 25)
- Files.walkFileTree (Java SE 25)
- Thread (Java SE 25):构造参数 stackSize
- ThreadMXBean.getThreadAllocatedBytes (Java SE 25)
- OpenJDK 源码仓库:本文所有行号摘自
$JAVA_HOME/lib/src.zip(JDK 25 与 JDK 21)
系列索引:设计模式系列