设计模式——模板方法:钩子的成本
模板方法把流程写死在父类,把可变的步骤留给子类。子类通常只需要实现一个方法。
其余步骤是带默认实现的钩子,默认体在源码里经常是空的,读起来不要钱。
本文量两件事:8 个空钩子在 1 亿次调用下的开销,以及InputStream的默认实现把一个批量读请求拆成逐字节调用之后,48 MiB 数据要多付多少。
一、骨架与钩子
模板方法把一段流程拆成两种方法:父类实现的骨架方法,子类实现的步骤方法。步骤方法里,一部分是抽象方法,子类必须实现;另一部分是带默认实现的钩子,子类想改才改。
    classDiagram
    direction TB
    class Template {
        +run() final
        #step()*
        #hook1()
        #hook2()
        #hook3()
    }
    class ImplA
    class ImplB
    Template <|-- ImplA
    Template <|-- ImplB
    note for Template "run() 按固定顺序调用 step 与 hook,子类只看到 hook"
JDK 的类文档自己用 hook 这个词。ThreadPoolExecutor 有一节标题就是 “Hook methods”,写的是 beforeExecute、afterExecute、terminated 这三个 protected 方法(JDK 25 ThreadPoolExecutor.java:241-251)。三者的默认实现都是空方法体(:1920、:1971、:1979)。
模板方法在 JDK 里最常见的形态是:抽象方法只留一个,其余全是钩子。
| 类 | 子类必须实现 | 钩子(带默认实现) |
|---|---|---|
InputStream |
read() |
read(byte[],int,int)、read(byte[])、skip、available、close、transferTo |
AbstractList |
get(int)、size() |
set、add、indexOf、iterator、clear、removeRange |
ThreadPoolExecutor |
无 | beforeExecute、afterExecute、terminated |
这三个类跟教科书里“固定算法骨架”的写法有出入,共同点是把扩展点做成带默认实现的方法,把必须实现的部分压到一个或两个抽象方法上。
JDK 自己怎么写这些子类
在 JDK 25 的 src.zip 里对 14,671 个 .java 文件统计 extends 关系和批量方法的实现(方法声明后带方法体才算实现):
| 基类 | 子类数 | 实现了批量入口 | 没实现 |
|---|---|---|---|
InputStream |
40 | 38 | 2 |
OutputStream |
26 | 23 | 3 |
Reader |
19 | 19 | 0 |
Writer |
18 | 16 | 2 |
Reader 那一行是零:它的抽象方法就是 read(char[],int,int),子类漏掉编译不过。InputStream 那一行有 2 个:它的抽象方法是单字节的 read(),批量入口是钩子,覆写与否编译器不管。漏掉的两个是 ProcessBuilder 里的 NullInputStream 和 DataTransferer 里的 ReencodingInputStream,都是边角实现。避免这个坑只能靠人自觉。
统计口径:在源码里找形如 class X ... extends 基类 的声明,再看同一个文件里有没有带方法体的批量方法声明,byte b[] 这种 C 风格数组写法也算。Reader 和 Writer 的批量方法是抽象方法,编译器会强制子类实现它们。
默认实现是 JDK 对这份成本的回应:抽象方法每多一个,所有子类的实现成本就多一份。read(byte[],int,int) 的默认实现让一个只能逐字节输出的流(解压、解密、协议解码这些内部环节)只写一个方法就能接进整条 IO 链。JDK 把便利留给了子类写作者,把代价推给了没有覆写的调用方。
二、怎么测的
- 机器:Apple M1 Pro,macOS Darwin 25.6.0
- JDK:
21.0.8+12-LTS-250与25+37-LTS-3491,都是 arm64。源码引用逐字取自各自lib/src.zip里的文件,行号是逐个unzip -p出来的 - 没有 JMH。每个变体单独起一个 JVM,先预热再计时。钩子实验每次计时调用 1 亿次,跑 5 轮取中位数;数据流实验每个变体跑 5 轮取中位数
- 计时期间持有全局文件锁,同一时刻只有一个实验在跑。机器上还有 21 个并行任务在编译和写文件,绝对数值整体偏大,结论只建立在同一批实验内部的量级和方向上
- 三个口径:耗时用
System.nanoTime;调用次数在流实现内部自增计数;分配字节数用com.sun.management.ThreadMXBean#getThreadAllocatedBytes - 内联情况用
-XX:+UnlockDiagnosticVMOptions -XX:+PrintInlining打印,引用的是 JDK 25 的输出 - 数据源是 48 MiB 的 Java 堆数组(50,331,648 字节)。把 IO 排除掉,是为了让第二个实验量的是默认实现本身;系统调用那一侧已经在装饰器篇里量过,结论不复用
被测的骨架在两个变体里逐字节相同,唯一变量是钩子的数量和运行时接收者的类型数量。
局限
- 没有 JMH,数字用
System.nanoTime取中位数。绝对值和用 JMH 测出来的不会一样 - 机器上有其他任务在跑。钩子实验 5 轮之间的极差大多在 3% 以内,耗时 1 到 3 ms 的数据流变体波动更大,个别轮次能差出一倍。钩子实验里用来下结论的最小差是双实现的 4.546 ns,比该实验的波动大一个量级;数据流实验的结论建立在 20 倍以上的差上
- 数据源是堆数组,JIT 能把默认实现和子类方法一起内联,这比真实 IO 场景更有利。真实文件流上每字节一次
read(2),量级已经在装饰器篇里给过 - 钩子数量和子类数量是仅有的两个变量,没有覆盖继承深度、接口默认方法、泛型桥方法这些情况
三、实测一:1 个钩子与 8 个空钩子
被测的骨架
1 | public static abstract class Eight { |
另一个骨架把 8 个钩子减到 1 个,其余完全相同。四个子类分别继承两个骨架,覆写 body 和全部钩子,钩子的方法体是空的:
1 | static final class A8 extends Eight { |
计时循环把接收者放在数组里轮换:
1 | for (long i = 0; i < N; i++) acc += r[(int) (i & mask)].run(i); |
mono 只实例化 1 个子类,bi 实例化 2 个,mega 实例化 4 个。三个变体做的计算完全相同,区别只在 JIT 在调用点能看到几种接收者类型。项目里“有几种子类”就是这么决定调用点形状的。
结果
| 变体 | 实现数 | JDK 21 每次调用 | JDK 25 每次调用 |
|---|---|---|---|
| 1 个钩子 | 1 | 0.920 ns | 0.918 ns |
| 8 个钩子 | 1 | 0.914 ns | 0.928 ns |
| 1 个钩子 | 2 | 1.618 ns | 1.617 ns |
| 8 个钩子 | 2 | 6.085 ns | 6.163 ns |
| 1 个钩子 | 4 | 6.402 ns | 5.765 ns |
| 8 个钩子 | 4 | 25.223 ns | 23.483 ns |
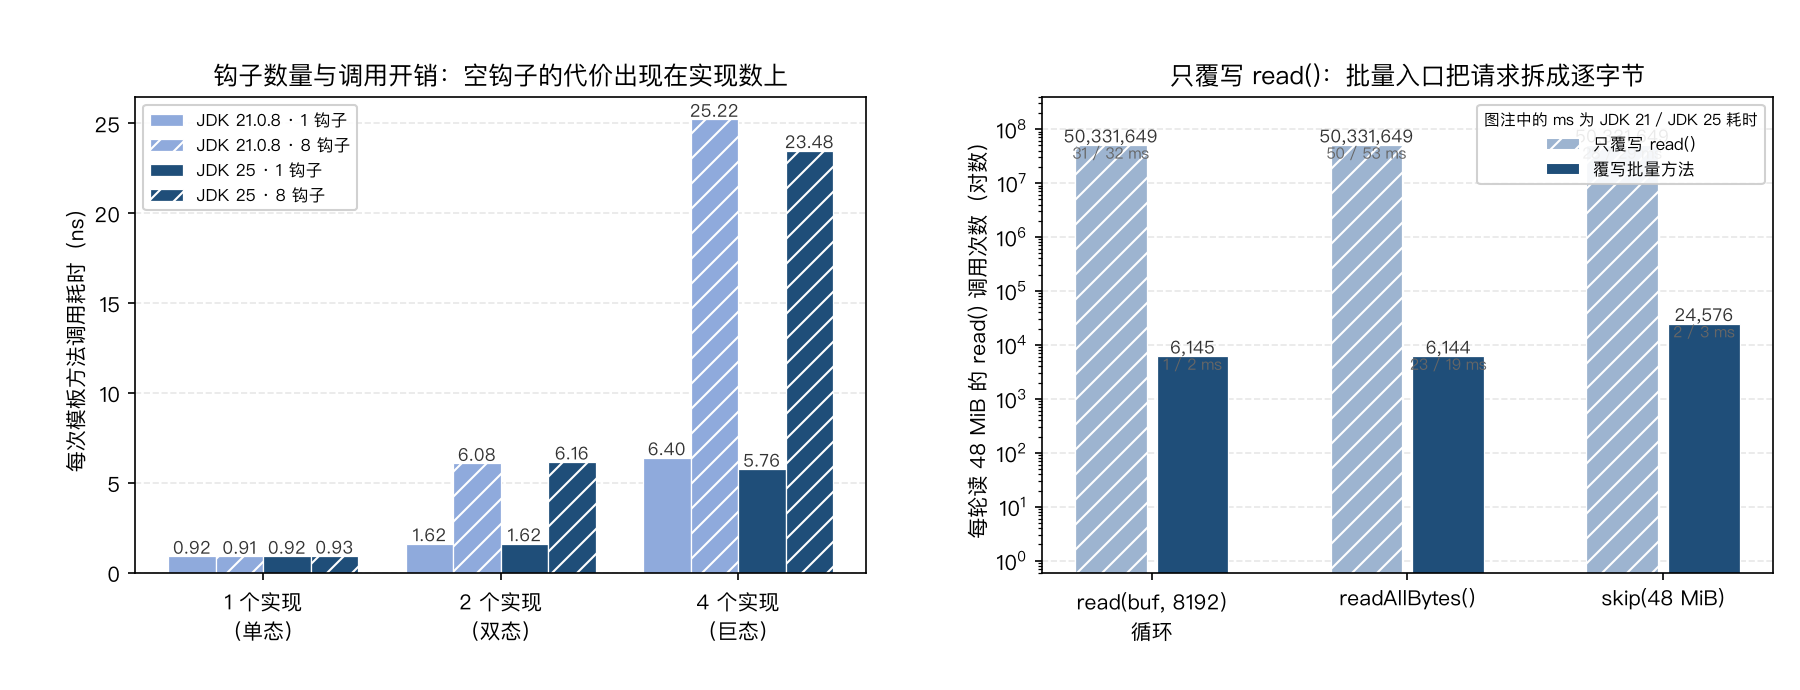
同一列里 1 个钩子和 8 个钩子的差,就是 7 个空钩子的价钱:
| 实现数 | JDK 21 差值 | JDK 25 差值 | 每个空钩子 |
|---|---|---|---|
| 1 | -0.006 ns | 0.010 ns | 0.001 ns |
| 2 | 4.467 ns | 4.546 ns | 0.649 ns |
| 4 | 18.821 ns | 17.718 ns | 2.53 ns |
只有一个实现时,7 个空钩子的差落在测量分辨力以内,两个 JDK 上都是这个结果。两个实现时每个空钩子贵 0.65 ns。四个实现时每个空钩子 2.53 ns,8 个钩子把每次调用从 5.765 ns 推到 23.483 ns,多出来的开销超过骨架本身。
为什么差在这些地方
用 -XX:+UnlockDiagnosticVMOptions -XX:+PrintInlining 打印 JDK 25 上 HookCost$Eight::run 的内联决定。单实现变体里 8 个钩子全部被内联:
1 | @ 8 HookCost$A8::h1 (1 bytes) inline (hot) |
同一个骨架在四实现变体里,8 个钩子的调用点全部放弃内联:
1 | @ 8 HookCost$Eight::h1 (1 bytes) failed to inline: virtual call |
C2 在调用点上最多记住两种接收者类型做投机内联,超过就走通用虚调用。双实现变体的输出印证了这条上限:C2 先后内联两个实现,同一个调用点在编译结果里换过一次绑定(原始输出是一行,这里拆开):
1 | @ 8 HookCost$A8::h1 (1 bytes) inline (hot) |
三个变体的差别就在内联决定里:
- 单实现:方法体空,内联之后整段消失,8 个钩子测不出代价
- 双实现:C2 保留类型检查再内联,7 组检查和分支留在了编译结果里,每次调用都要执行
- 四实现:直接放弃内联,每个钩子是一次查虚表、跳转、返回
两个 JDK 上的编译参数一致,MaxInlineSize = 35、FreqInlineSize = 325、TypeProfileMajorReceiverPercent = 90,都可以用 -XX:+PrintFlagsFinal 核对。骨架方法本身不大,run 最终被整体内联进计时循环,所以表里的数字不含额外的方法调用开销。
两个 JDK 给出的结果几乎一样:单实现的差是 -0.006 ns 与 0.010 ns,双实现是 4.467 ns 与 4.546 ns,四实现是 18.821 ns 与 17.718 ns。每个变体 5 轮之间的极差大多在 3% 以内,四实现那一行是 2% 到 4%。同一代 HotSpot 的类型 profile 投机内联策略在两个 LTS 之间没有变化。
    graph TD
    Q["钩子调用点"] --> C{"运行时接收者类型数"}
    C -->|"1 种"| I["投机内联,空方法体被消除"]
    C -->|"2 种"| B["类型检查 + 内联,每次留一组比较和分支"]
    C -->|"3 种以上"| V["放弃内联,每次真实虚调用"]
    I --> Z["8 个空钩子测不出代价"]
    B --> Y["每个钩子不到 1 ns"]
    V --> X["每个钩子 2 到 3 ns,与钩子数量线性累加"]
怎么用到自己的代码上
把 -XX:+UnlockDiagnosticVMOptions -XX:+PrintInlining 加到启动参数上,在输出里找骨架方法的名字,钩子的价钱就写在里面:
- 看到
inline (hot),钩子不要钱 - 看到
failed to inline: virtual call,钩子按每次 2 到 3 ns 计价,乘以调用次数就是它的总价
这条检查只对已经跑热的代码有意义,C2 要等调用计数上来才会编译。冷路径上的钩子不用管。
四、实测二:InputStream 的默认实现
InputStream 的抽象方法只有一个:
1 | public abstract int read() throws IOException; // JDK 25 InputStream.java:182 |
批量读是钩子,默认实现是逐字节循环(JDK 25 :283-307):
1 | public int read(byte b[], int off, int len) throws IOException { |
read(byte[] b) 也是钩子,转调批量读(JDK 25 :221-223),javadoc 的 @implSpec 写着 “same effect as read(b, 0, b.length)”(:204-209)。
这个设计对子类很友好:只要实现 read() 就能工作,所有批量入口都会自动退化成一层循环加逐字节调用。read() 是抽象方法,编译器强制子类实现;批量读是钩子,编译器不会提醒子类跳过了它。
被测的两种流
1 | static class ByteAtATime extends InputStream { // 只覆写 read() |
消费端用同一个 8192 字节缓冲反复调用 read(buf, 0, 8192),直到 48 MiB 读完。计数在流内部做,计的是 read() 和 read(byte[],int,int) 被调用的次数。
结果
| 消费方式 | 实现 | 流内部 read() 次数 |
流内部批量方法次数 | JDK 21 | JDK 25 |
|---|---|---|---|---|---|
read(buf,8192) 循环 |
只覆写 read() |
50,331,649 | 走默认实现,未计数 | 31.1 ms | 32.1 ms |
read(buf,8192) 循环 |
覆写批量读 | 0 | 6,145 | 1.4 ms | 1.6 ms |
readAllBytes() |
只覆写 read() |
50,331,649 | 走默认实现,未计数 | 49.9 ms | 52.6 ms |
readAllBytes() |
覆写批量读 | 0 | 6,144 | 23.4 ms | 18.7 ms |
skip(48 MiB) |
只覆写 read() |
50,331,649 | 走默认实现,未计数 | 28.0 ms | 29.1 ms |
skip(48 MiB) |
覆写批量读 | 1 | 24,576 | 1.7 ms | 3.0 ms |
48 MiB 是 50,331,648 字节。只覆写 read() 时,消费端每个 8192 字节的批量请求都被拆成 8192 次单字节调用,一轮读下来 50,331,649 次,耗时是覆写批量方法的 20.1 倍(JDK 25)与 22.2 倍(JDK 21)。最后一行里那个 1 是消费代码接着调的 in.read(),跳过之后返回 -1。
三个消费入口的退化是同一件事:
read(buf, 0, 8192)直接落在默认实现的循环上readAllBytes()转调readNBytes(Integer.MAX_VALUE)(JDK 25InputStream.java:347-349),后者分配 16384 字节的临时数组(:58的DEFAULT_BUFFER_SIZE、:407),在循环里调read(buf, nread, ...)(:411-412)。这个调用同样落在默认实现上skip()的默认实现分配一个 2048 字节的MAX_SKIP_BUFFER_SIZE数组(:56、:547-548),反复调read(skipBuffer, 0, size)(:550)
三条路径上的调用次数都对得上。readAllBytes() 每次读满 16384 字节的临时缓冲(48 MiB 分成 3072 块),缓冲填满时 Math.min(buf.length - nread, remaining) 变成 0,于是每块还要发一次长度为 0 的探测读,计数是 6144;skip() 的批量调用次数 24,576 正好是 48 MiB 除以 2048。子类作者只要漏掉批量读,所有批量入口一起变慢,而每个入口的默认实现在源码里分散在三个地方。
transferTo(OutputStream) 也走同一条路:它分配 DEFAULT_BUFFER_SIZE 大小的缓冲,循环调 read(buffer, 0, DEFAULT_BUFFER_SIZE)(JDK 25 :790-795)。
同一张表里 readAllBytes() 的批量变体比 read(buf,8192) 循环慢得多:18.7 ms 对 1.6 ms。这部分开销与流无关,出在 readNBytes 的实现上:它把 3072 个 16384 字节的块先攒在 ArrayList 里(:401、:429-432),读完再分配一个 48 MiB 的结果数组把块拼起来(:447-455),那次拼接和 48 MiB 的分配就是多出来的时间。用 readAllBytes() 处理几十 MiB 的输入时,多出来的是内存和一次全量拷贝。
自己写 InputStream 时该怎么办
覆写批量方法,并按契约处理边界:len == 0 返回 0,只在到达末尾时返回 -1。Objects.checkFromIndexSize 那行检查也照着抄,调用方传越界参数时抛出的异常类型才和 JDK 一致。
    graph TD
    A["写一个 InputStream 子类"] --> B{"数据能一次给出多字节吗"}
    B -->|"能"| C["覆写 read(byte[],int,int),用 arraycopy 交付"]
    C --> D["read() 可以留给默认实现,或者覆写它转发到批量读"]
    B -->|"不能,一次只出一个字节"| E["只覆写 read(),接受批量入口的逐字节代价"]
    A --> F["无论如何都覆写 available()"]
available() 也落在这类必须覆写的方法里:ByteArrayInputStream 之类的实现覆写它返回剩余字节数,BufferedInputStream 返回缓冲里还没消费的字节数。
默认实现里的两个隐藏行为
逐字节循环里的 catch (IOException ee) { }(JDK 25 :304-305)把循环中途的异常吞掉,直接返回已经读到的字节数:第一次 read() 抛出的异常会传给调用方,第二次及以后的不会。
available() 的默认实现返回 0(:650-652):
1 | public int available() throws IOException { |
调用方用 in.available() > 0 判断“有没有数据可以立刻读”时,只覆写 read() 的流拿到的就是 0。这个钩子没有分派代价,默认实现直接把这项能力关掉了。
反向的默认实现
同一个 JDK 里,Reader 把方向反了过来。read(char[],int,int) 是抽象方法(JDK 25 Reader.java:398),单字符的 read() 是钩子,实现方式是每次分配一个 char[1](:345-351):
1 | public int read() throws IOException { |
子类实现批量读之后单字符入口能用,代价是每次调用一次数组分配。用 ThreadMXBean#getThreadAllocatedBytes 数一下,逐字符读 48 Mi 个字符:
| 路径 | 单字节调用次数 | 分配字节数 | 平均每次 | JDK 25 耗时 |
|---|---|---|---|---|
Reader.read() 逐字符 |
50,331,648 | 1,207,959,576 | 24.0 字节 | 230.7 ms |
read(char[],int,int) 批量 |
0 | 0 | 0 | 8.2 ms |
分配没有走标量替换:read(cb, 0, 1) 是虚调用,逃逸分析证明不了数组不外传,加 -XX:-EliminateAllocations 之后数字一模一样,两个 JDK 的计数也一致。48 Mi 个字符换来 1.13 GiB 的垃圾。
OutputStream 与 InputStream 同向:write(byte[],int,int) 是钩子,默认实现循环调 write(int)(JDK 25 OutputStream.java:163-169),javadoc 里写着 “Subclasses are encouraged to override this method and provide a more efficient implementation.”。一个只覆写 write(int) 的输出流,写 48 MiB 会产生 5033 万次分派。
“谁抽象、谁默认”得主动选:抽象方法的位置决定子类必须实现什么,钩子的位置决定哪条入口有默认退路、退路有多贵。Reader 把抽象方法放在批量入口上,所有子类都被逼着去实现它,单字符入口付一次分配。InputStream 把抽象方法放在单字节入口上,子类写起来省事,批量入口的性能全靠子类作者自觉。
五、另外两个钩子
AbstractList
AbstractList 把 get(int) 留成抽象方法(JDK 25 AbstractList.java:122),size() 继承自 AbstractCollection,同样是抽象方法(AbstractCollection.java:82)。两者之上的方法是钩子:
indexOf(Object)创建listIterator()逐个比较(AbstractList.java:186-198)lastIndexOf(Object)从size()位置反向迭代(:212-224)clear()调removeRange(0, size())(:244-246)- 内部类
Itr的next()调get(i)(:369-381)
1 | public E next() { |
子类实现两个方法,换来迭代、查找、清空、子列表这些行为。代价是每个元素的访问都是一次 get(i)。数据放在数组里的实现能让 JIT 内联掉它,放在链表上的实现每次 get(i) 都要走 i 步,indexOf 因此从 O(n) 变成 O(n²)。默认实现只保证语义正确。
ThreadPoolExecutor
三个钩子的调用点在 runWorker 里,包在任务执行的两侧(JDK 25 ThreadPoolExecutor.java:1088-1094):
1 | try { |
terminated() 在状态机走到 TERMINATED 时调用(:701)。类文档里那节 “Hook methods” 说的是它们的用途:重置 ThreadLocal、收集统计、写日志(:241-251)。javadoc 还附了一条约定,子类覆写时要调用 super.beforeExecute、super.afterExecute、super.terminated,嵌套覆写才不会互相覆盖(:1913-1915、:1929-1931、:1975-1977)。
这三个钩子的成本在这里可以忽略:每次任务执行各调一次,而任务本身要做的事情比一次虚调用贵得多。JDK 25 源码里继承 ThreadPoolExecutor 的类只有 ScheduledThreadPoolExecutor 一个,它没有覆写 beforeExecute 与 afterExecute,覆写的是另一个包内钩子 onShutdown()(ScheduledThreadPoolExecutor.java:376,调用点在 ThreadPoolExecutor.java:1346)。PausableThreadPoolExecutor 和 ExtendedExecutor 这两个名字出现在类文档的示例代码里,不是 JDK 的类。
这两个例子的差价来自一条三项乘法:
1 | 分派成本 × 每次执行的钩子数 × 调用频率 |
ThreadPoolExecutor 的三个钩子每次任务各调一次,唯一的子类也没有覆写它们,第三项以任务为单位,前两项小到量不出来。InputStream 的批量读三项全中:分派成本由子类数量决定,钩子数每次调用一次,调用频率按字节算。同一个模式,位置不同,价格差出几个量级。
六、结论
什么时候用
- 骨架稳定、步骤有几个明确的变体,且运行时子类数量能控制在两个以内。实测里两个实现时每个空钩子贵 0.65 ns,骨架基本白拿
- 钩子所在的路径调用频率不高。
ThreadPoolExecutor的三次调用摊在每个任务上,量不出来 - 需要给第三方留扩展点,且默认行为必须存在。
InputStream的默认批量读保证了只实现read()的流也能被readAllBytes()使用,代价只有性能
什么时候不用
- 钩子在热路径上,且程序里会有三个以上子类。实测每个空钩子 2.53 ns,8 个钩子让每次调用从 5.765 ns 变成 23.483 ns
- 只有一个变体。这时候抽象类的分派成本全价支付,收益为零。同一台机器上量过抽象类钩子与传函数的差别(3 千万次行处理):JDK 21 上 6.07 ns 对 7.29 ns,JDK 25 上 6.05 ns 对 6.64 ns,两种写法在同一数量级(见总纲)
- 步骤的默认实现是一条慢路径,而子类作者看不出这一点。
InputStream的批量读就是这样:接口要求实现read(),默认实现把批量入口接在它上面,漏覆写不报错,功能也正常,只有调用次数差 8192 倍、耗时差 20.1 倍
一条判断顺序
    graph TD
    A["要写一个带骨架的类"] --> B{"步骤有几个变体"}
    B -->|"1 个"| C["直接写一个类,或者传一个函数"]
    B -->|"2 个以上"| D{"钩子会不会出现在热路径"}
    D -->|"不会,调用频率低"| E["模板方法,钩子随便加"]
    D -->|"会"| F{"运行时子类数量"}
    F -->|"1 到 2 个"| G["先写,用 PrintInlining 确认钩子被内联"]
    F -->|"3 个以上"| H["数钩子数量:每个 2 到 3 ns,乘调用次数"]
    H --> I{"成本可接受"}
    I -->|"可接受"| E
    I -->|"不可接受"| J["把可变步骤收敛成一个方法,或者改成组合"]
    A --> K{"谁是抽象方法,谁是默认实现"}
    K --> L["抽象方法放在调用最频繁的入口上;默认实现的退路要量一遍"]
最后一问针对 InputStream 这类库代码。写库的时候,钩子的默认实现就是 API 契约的一部分,契约的方向决定所有子类的性能上限。写业务代码时方向由自己定,选错了最多损失一次重构。
改法
看到 failed to inline: virtual call 并且钩子在热路径上时,有三条路:
- 把钩子数收敛到一个。骨架里留一次
hook()调用,具体要做的几件事交给子类内部决定。这是最小改动:
1 | public final long run(long x) { |
- 换成组合。把可变步骤抽成接口,骨架持有它,单实现下 JIT 一样能内联,多实现时的代价与模板方法相同,但类层次不再膨胀(对照见策略)
- 让子类数量不超过两个。这属于设计问题:三个以上实现同时活跃的类层次,该重新看一遍
第一条路不是随处可用。钩子列表写进 API 契约之后(ThreadPoolExecutor 的三个钩子、InputStream 的批量读),改不动,只能接受或另起类型。
钩子成本按场景对照:
| 场景 | 分派成本 | 每次执行的钩子数 | 调用频率 | 结论 |
|---|---|---|---|---|
ThreadPoolExecutor.beforeExecute |
内联,唯一继承它的类没有覆写 | 3 | 每个任务一次 | 忽略 |
AbstractList.get |
子类决定 | 1 | 每个元素一次 | 数组实现免费,链表实现退化成 O(n²) |
InputStream 批量读 |
0,子类自己实现 | 1 | 每 8192 字节一次 | 漏覆写等于每字节一次分派 |
总结
- 模板方法把必须实现的方法压到一个或两个,其余步骤做成带默认实现的钩子。JDK 的三个例子:
InputStream只有一个抽象方法read(),AbstractList有两个(get、size),ThreadPoolExecutor一个都没有,三个钩子全是空默认体 - JDK 25 源码里
extends InputStream的子类 40 个,38 个实现了批量读;Reader的子类 19 个,19 个都实现,因为它的抽象方法就放在批量入口上 - 1 亿次调用的实测:单实现时 1 个钩子与 8 个空钩子的耗时差在测量分辨力以内;双实现时每个空钩子贵 0.65 ns;四实现时每个空钩子 2.53 ns。8 个钩子在四实现下把每次调用从 5.765 ns 推到 23.483 ns(JDK 25)
PrintInlining给出的机制:单实现时 8 个钩子调用点全部inline (hot),四实现时全部failed to inline: virtual call。两个 JDK 的MaxInlineSize都是 35、FreqInlineSize都是 325、TypeProfileMajorReceiverPercent都是 90InputStream.read(byte[],int,int)的默认实现是逐字节循环(JDK 25InputStream.java:283-307)。子类只覆写read()时,48 MiB 的批量读产生 50,331,649 次read()调用,覆写批量方法后是 6,145 次,耗时差 20.1 倍(JDK 25)readAllBytes()、skip()、transferTo()都从默认实现里向下调批量读(:347-349、:539-558、:790-795),退化程度一样。available()的默认实现返回 0(:650-652)- 默认实现里的
catch (IOException ee) { }(:304-305)会让循环中途的异常静默变成“读到一部分” Reader的方向相反:抽象方法放在read(char[],int,int)(Reader.java:398),单字符入口每次分配一个char[1](:345-351),48 Mi 个字符分配 1.13 GiB,平均每次 24.0 字节,-XX:-EliminateAllocations不影响计数。OutputStream与InputStream同向(OutputStream.java:163-169)- 钩子的成本可以按
分派成本 × 钩子数 × 调用频率估。三项里任意一项接近零,模板方法就没有可测代价
参考资料
- InputStream (Java SE 25)
- InputStream (Java SE 21)
- OutputStream (Java SE 25)
- Reader (Java SE 25)
- AbstractList (Java SE 25)
- AbstractCollection (Java SE 25)
- ThreadPoolExecutor (Java SE 25)
- HotSpot Inlining 相关参数(PrintFlagsFinal 输出)
- Java Microbenchmark Harness
系列索引:设计模式系列