设计模式——命令:撤销栈与队列化
doc.insert(pos, text)编译之后只剩一条 invokevirtual,方法一返回,这次调用就没有任何痕迹了。
命令模式把这一行换成new InsertCmd(doc, pos, text),这次调用变成内存里的一个值:能入栈做撤销、入队做排队、写盘做重放。
10 万次操作、四种形态,量的是耗时、分配字节与延迟,以及撤销栈里「记快照」和「记反向操作」两条路的内存差。
一、把调用变成对象
一个方法调用在编译后活在栈帧里。接收者、参数、要做什么,都散在字节码的指令序列上,方法一旦返回,这些信息就没了。要撤销它,得在调用之前自己把原位字符记下来;要排队,得把它包进一个 lambda 交给别人;要记录,得在旁边再写一行日志。
命令模式把这一行换成 new InsertCmd(doc, pos, text):调用发生的时间和执行的时间分开,这次调用就成了内存里的一个值。
撤销、排队、记录都建立在这个值上:
- 撤销:入栈,回滚时按逆序对每条执行相反的操作。
- 排队:入队,由另一个线程按自己的节奏取走执行。
- 记录与重放:写进日志或消息,读回来再执行一遍。
把调用变成对象,代价分两块:对象要占字节,要活到被执行的那一刻,编译器就不能再把它优化掉;跨线程要同步,队列的锁和 park/unpark 落在关键路径上。
    flowchart LR
    A["调用点<br/>new InsertCmd(doc, pos, text)"] --> B{逃逸分析}
    B -->|不逃逸| C["标量替换<br/>0 字节 / 0 额外时间"]
    B -->|逃逸| D["堆上的对象<br/>实测 24 到 40 字节"]
    D --> E["撤销栈<br/>每条 +4 字节引用"]
    D --> F["队列<br/>每次 put/take 一次锁"]
    D --> G["日志 / 重放<br/>+ 序列化"]
    E --> H["undo() 逆序回滚"]
    F --> I["另一线程 exec()"]
    G --> J["读回后 exec()"]
图里左半边是要测的量,右半边是三个用途各自收费的位置。
二、实验设计
四个形态一共不到 60 行代码,做同一件事:给一个 long 累加器加一个 1 到 8 之间的增量,循环 10 万次。
1 | // 形态一:直接调用 |
四个形态的命令类一共长这样:
1 | interface Cmd { void exec(); } |
撤销版本的 prev 在构造时抓取,排队版本的时间戳和序号在入队前写好。四个形态之间唯一的差别,是这两个字段从哪里来。
形态四生产者循环里那次 System.nanoTime() 是给延迟测量用的:吞吐和分配在去掉它的那一轮测,延迟在带它的那一轮测。带时间戳那一轮的吞吐是 127.0 ns/op,不带时间戳的是 125.0 ns/op,打点本身在这个形态里测不出额外成本。表格里的吞吐用不带时间戳的那一轮。
增量写成 1 + (i & 7),是为了不让 JIT 把循环折掉:增量是常数时,JIT 会把整个循环折成一个乘法,10 万次迭代消失。带上循环变量以后,每次加法都必须执行。每轮跑完打印累加值当校验和(日志里的 checksum=),它每轮不同,说明计算没有被优化掉。
把调用包成对象只为「换一种算法」,是策略要解决的问题;命令关心的是这一次调用本身能不能被存下来、排队、重放。
测量条件:
- 机器 Apple M1 Pro,macOS 26.6.2(Darwin 25.6.0),arm64。
- JDK
21.0.8+12-LTS-250与25+37-LTS-3491,各形态单独起一个 JVM。 -Xms512m -Xmx512m,预热 10 轮后测 5 轮,取中位数。- 每操作分配字节用
com.sun.management.ThreadMXBean.getThreadAllocatedBytes;队列形态由生产者和消费者各自在自己的线程里读,两个数相加。 - 计时循环持全局文件锁运行。本次有 22 个 agent 在这台机器上并行跑各自的实验,不串行化会因为抢 CPU 把数据搅乱。
延迟单独测:在每次操作两侧各打一次 System.nanoTime(),10 万个样本排序取分位数。这个测量有地板。空打点循环 10 万次的 p50 是 0ns、p99 是 42ns,这台机器上 nanoTime 的分辨力在 42ns 左右。耗时不到 1ns 到几 ns 的形态,单次延迟测不出来,只能信总时间;延迟分布只对微秒级的形态有分辨力。这个限制决定了后面哪些结论能下、哪些不能下。
口径与限制:
- 本机没有 JMH,这是单机微基准,给的是量级和方向,绝对数字不能当硬件上限看。
- 1 到 3ns 之间的差在这台机器上不可靠。直接调用和命令对象落在同一个量级,谁快 1ns 取决于编译器这一轮怎么展开循环,不取决于形态。
- 分配字节是精确计数(
ThreadMXBean按线程统计,不受 GC 影响),这一列可以当硬数据看。 - 队列形态的延迟在轮与轮之间的波动很大,原因写在第三节。
- 每个数字都是一次具体运行的产物,本文所有数值来自本次运行的原始输出,未经挑选。
三、实测一:四种形态
| 形态 | JDK 21 ns/op | JDK 25 ns/op | 分配字节/op | p50 延迟 | p99 延迟 |
|---|---|---|---|---|---|
| 直接调用 | 0.71 | 0.83 | 0.00 | 0ns | 42ns |
| 命令对象(不逃逸) | 0.71 | 0.70 | 0 | 0ns | 42ns |
| 命令对象(关掉逃逸分析) | 4.46 | 4.23 | 24 | 0ns | 42ns |
| 命令对象 + 撤销栈 | 4.75 | 4.76 | 36 | 0ns | 42ns |
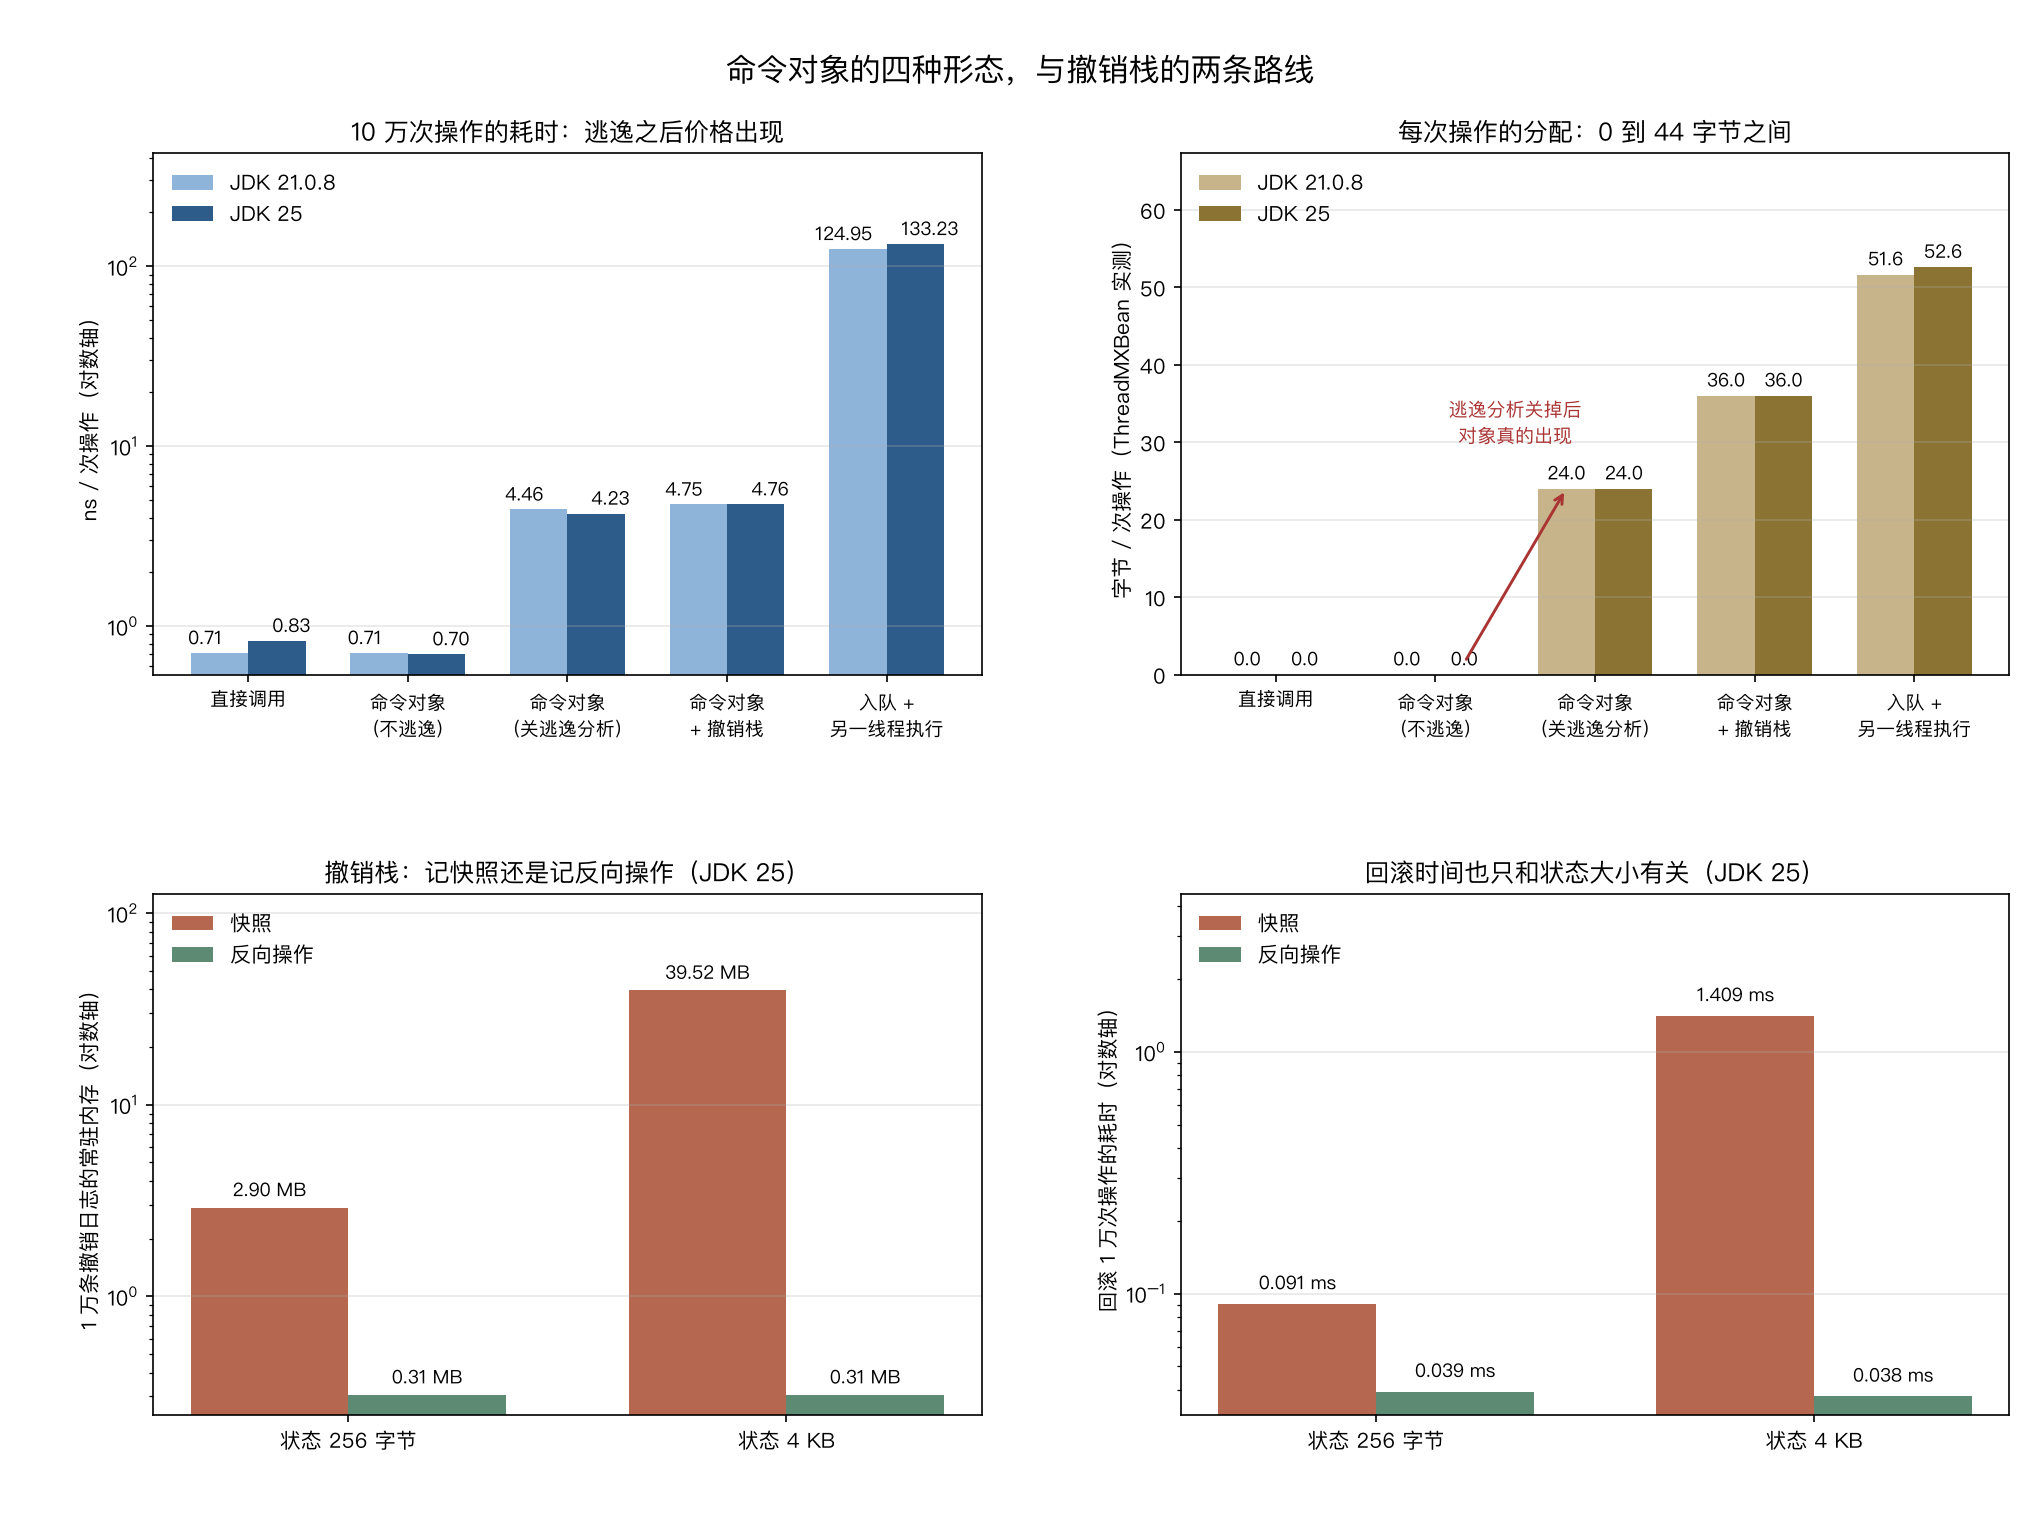
| 入队 + 另一线程执行 | 125.0 | 133.2 | 52.6 | 60.0µs | 0.21ms |
单独量三个命令对象本身的字节数(只创建、放进预分配数组,不入栈不入队):AddCmd 24 字节,带一个 prev 的 UndoCmd 32 字节,带时间戳和序号的 QueueCmd 40 字节。两个 JDK 上这三个数一样。
命令对象在不逃逸时是免费的
第二行的分配字节是 0.00,精确的零。JIT 把命令对象标量替换了:new AddCmd(c, d) 这个对象从来没有在堆上出现过,被拆成了两个局部变量。耗时和直接调用同一个量级(1ns 上下),谁快谁慢在这台机器的测量分辨力之内。
同一份代码加 -XX:-DoEscapeAnalysis 关掉逃逸分析,价格马上出现:每个对象 24 字节,耗时从 0.71 涨到 4.46,JDK 21 上涨 6.3 倍,JDK 25 上涨 6.0 倍。
只要对象不逃逸,把调用包成对象不花什么钱。 你写的那 40 行命令类,编译器会替你把它变回一个方法调用。
逃逸之后价格出现,而且不在操作本身
第四行把命令压进撤销栈,命令对象的引用要活到回滚那一刻,逃逸分析就失效了。分配变成 36 字节/操作:UndoCmd 对象 32 字节,撤销栈的引用数组每个槽 4 字节。第五行入队,QueueCmd 40 字节,整条流水线实测 52.6 字节/操作。
撤销功能的全部内存开销,就是一个 24 字节的对象加一个引用槽。
字段就是账单价
命令对象的大小可以直接从字段算出来,实测值和算出来的值对得上:
| 形态 | 字段 | 算法 | 实测字节/个 |
|---|---|---|---|
AddCmd |
接收者引用 + long 增量 | 12 + 4 + 8 = 24 | 24.00 |
UndoCmd |
再加一个 long prev | 12 + 4 + 8 + 8 = 32 | 32.00 |
QueueCmd |
再加 long 入队时刻 + int 序号 | 12 + 4 + 8 + 8 + 4 = 36,对齐到 40 | 40.00 |
对象头 12 字节(压缩类指针),引用 4 字节,字段按对齐规则重排。prev 存的是「撤销需要什么」,时间戳和序号存的是「排队需要什么」;这两个字段是调用变成对象之后才多出来的,不属于业务数据。
命令对象需要设计的地方也只有字段:撤销信息、排队信息、追踪信息,每加一个,每次操作就多付一份字节。
排队把延迟交出去
第五行的耗时是 125.0 ns/op,是直接调用的 176 倍。消费者线程做的是同一件事,两个线程没有把工作量变小,队列的锁、put 和 take 的同步、每操作一个 40 字节的对象,全部落在关键路径上。
队列把生产和消费在时间上解耦,价格记在延迟上:
- p50 延迟 60.0µs,p99 0.21ms,max 0.33ms。
- 队列峰值水位打到容量上限(8192/8192),生产者被背压挡住过。
- 同一份代码在 5 轮之间,p50 差出 7.2 倍。
延迟由队列水位决定。一条命令在队列里等待的时间,等于排在它前面的所有命令的处理时间之和;水位由生产者和消费者的相对速度决定,和操作本身无关。把容量从 8192 放到 131072 以后,生产者几乎不再被背压挡住,峰值水位涨到 48544,p50 延迟从 60.0µs 涨到 234.6µs,吞吐在同一个水平(125.0 对 152.3 ns/op)。
队列化交出的控制权是「每次操作要等多久」。 平均延迟、尾延迟、延迟的抖动,全由另一个线程的进度决定。要压住尾部,能调的只有队列容量上限和消费者并行度,这两样都不在调用点的代码里。
队列不减少工作量。它把两个阶段的时间重叠起来:同步执行时,总时间是两者之和;入队之后,总时间由较慢的那一侧决定,再加上水位乘消费速度。本实验里两个阶段都只做一次加法和一次队列操作,成本同一个量级,重叠省下的部分被同步开销吃掉。队列在消费者明显更慢(写磁盘、发网络请求、调远程接口)时才划算,那时它买到的是「生产者不必陪着消费者等」。
用队列之前要定三件事:
- 容量。有界队列的容量就是背压的界限。本实验里生产者被挡在 8192 这个水位上,水位越高延迟越大,这两条一起动。
- 谁负责重试。
put被挡住时生产者只能在原地等。生产者的上游如果也不能等(比如网络 IO 线程),就得换成offer加丢弃或落盘,或者再加一级缓冲。 - 消费者要不要有序。命令对象可以被多个消费者并行执行,前提是命令之间可交换。有依赖的命令要么进同一个消费者,要么在命令里带上依赖关系。
延迟分布的形状
把 5 轮测量的分位数并排看,max 是 p50 的 5.4 倍,而耗时(ns/op)5 轮都稳定。同一个程序、同一种操作,延迟可以差一个数量级,吞吐稳定。排队系统的延迟分布长尾:一条命令要等多久,取决于它入队那一刻队伍有多长,而队伍长度是两个线程速度差的积分。
要让尾延迟收敛,只有一个办法:把水位压住。容量调小、消费者加快、或者干脆让生产者自己按消费者的速度走。这三条都在队列外面,调用点的代码管不了。
队列容量的选择
本实验用 8192,这个数字没有调优,作用是让生产者和消费者发生背压:峰值水位打到 8192,说明生产者至少在部分时间里比消费者快,put 被 park 过。容量就是允许积压的深度,选得越大,平均等待时间越长。
两个 JDK 上的差别
两个 JDK 上四个形态的耗时都落在同一量级:直接调用 0.71 ns 对 0.83 ns,命令对象 0.71 对 0.70,关掉逃逸分析后 4.46 对 4.23,撤销栈 4.75 对 4.76,队列 125.0 对 133.2(JDK 21 与 JDK 25)。分配字节这一列两套 JDK 一致:直接调用与命令对象都是 0,强制分配时都是 24,撤销栈都是 36,队列是 51.6 对 52.6。撤销实验里快照 4KB 的回滚耗时 JDK 21 是 1.473ms、JDK 25 是 1.409ms,反向操作两边都是 0.038ms。队列形态两个 JDK 的差异同样在这个量级。
四、撤销栈里放什么
撤销有两种记法。一种是在改之前给整个状态拍一张快照,回滚时整张拷回去;另一种只记这次改动碰过的东西,回滚时精确还原。快照实现简单,代价与状态大小成正比;反向操作省内存,前提是操作可逆。
把「状态快照」当成独立模式讨论,是备忘录的范围;这里只关心它在命令对象上挂了几个字段、每个字段多贵。命令对象是一次性的,创建、执行、入栈之后不再复用;要把可变对象重复利用,那是对象池的取舍。
实验:一个 int[] 状态对象,10,000 次 a[i] = v,每次操作前按其中一种方式记一条日志,然后按逆序回滚全部 10,000 条。状态规模取 64 个 int(256 字节)和 1024 个 int(4KB)两种。回滚完成后逐元素比对,两条路线的结果都必须与初始值一致(实测都是 restored=true)。
| 撤销路线 | 状态 256 字节 | 状态 4KB |
|---|---|---|
| 快照:日志字节/操作 | 304 | 4144 |
| 快照:10,000 条日志总量 | 3.0MB | 41.4MB |
| 快照:回滚 10,000 次耗时 | 0.091ms | 1.409ms |
| 反向:日志字节/操作 | 32 | 32 |
| 反向:10,000 条日志总量 | 320KB | 320KB |
| 反向:回滚 10,000 次耗时 | 0.039ms | 0.038ms |
快照路线里,每条日志是「一个 272 字节的 int[] 拷贝 + 一个 32 字节的命令对象」,状态 4KB 时是「一个 4112 字节的数组 + 32 字节对象」。反向路线里每条日志是「被改的下标 + 改前旧值」,32 字节,和状态多大没有关系。
代价在几个维度上同时拉开:
- 内存:状态 4KB 时,快照 10,000 条要 41.4MB,反向只要 320KB,差 130 倍。状态再大一点,倍数跟着涨。
- 回滚时间:快照要把每个拷贝整张拷回去,回滚耗时与状态大小成正比(0.091ms 对 1.409ms);反向只写一个 int,两种状态规模下分别是 0.039ms 和 0.038ms。
- 前进时间:快照在每次操作前多一次全量拷贝,状态 4KB 时前进耗时是反向的 16 倍。
两条路线的命令类也只有这一点区别:
1 | final class SnapCmd extends UCmd { // 快照 |
构造函数的最后一行就是两种策略的全部区别:一行 clone(),或者一次读旧值。回滚方向上,一个整张 arraycopy 回去,一个写一个 int。
选哪条路,取决于操作能不能反:
a[i] = v能反,记(i, 旧值)。v += d也能反,记-d,连旧值都不用。append(s)只有在记了长度、而且知道尾部恰好是追加内容时才可逆;一旦操作的是超大文档,反向日志仍然要存那串内容,等于存了增量。delete(range)要恢复就必须存被删的内容,退化成快照。- 复合操作(一次用户动作改了三处)要变成一个可逆单元,否则回滚会停在中间状态。
撤销栈是两个栈
用户按了撤销之后再输入新内容,被撤销的那条分支就永远回不来了。撤销栈上有一个游标执行这条规则:游标后面是已撤销、还能重做的部分,前面是已经执行的;新操作进来时,游标后面的部分整段丢掉。
UndoManager 的类注释(第 103 到 107 行)把这条规则写死了:
1 | * Adding an edit to an <code>UndoManager</code> results in |
丢掉的那些条目也要占内存:重做深度和撤销深度是两份预算。做撤销功能时通常只算「能撤多少步」,漏掉「能重做多少步」,两份预算同时在。
数据完整地重放一遍,还有第二个前提:命令对象要能被序列化,而且序列化格式是有版本的公开契约。ForkJoinTask 的类注释(第 196 到 199 行)说得更直接:
1 | * <p>ForkJoinTasks are { Serializable}, which enables them to be |
任务体只在执行前或执行后可以被序列化,执行中的状态不保证能序列化。写日志或者发给别的进程的重放,拿到的都是「还没执行」的那份,改过的字段不在里面。
记录与重放为什么绕不开命令对象
日志、审计、事件溯源、跨进程重放,都是事后重新执行一次已经发生过的调用。重放要求把这次调用的全部输入写下来:接收者是谁、参数是什么、顺序是什么。方法调用本身不留这些东西,要在调用发生之前把它们变成数据。
代价有两块。一块是序列化本身,另一块是版本:命令对象一旦写进日志,它的字段就成了公开契约,加字段、改语义都要考虑读旧日志的程序。这条约束比内存账单更难还。
五、JDK 里的证据
java.base/java/lang/Runnable.java(JDK 25,全文件 44 行),第 28 到 44 行:
1 | /** |
一个无参无返回的方法,加上一个给别人调用的名字。命令对象的最小定义就是这样,剩下的都是往里加字段。
java.base/java/util/concurrent/Executor.java 第 39 到 42 行:
1 | * An object that executes submitted { Runnable} tasks. This |
「把任务的提交和任务怎么跑解耦」,这一句就是队列化的定义。解耦的那一侧是提交点,另一侧是线程模型;两边唯一的接口是那个 Runnable 对象。
java.base/java/util/concurrent/ExecutorService.java 第 57 到 59 行,以及第 233 行:
1 | * <p>Method { submit} extends base method { |
1 | <T> Future<T> submit(Callable<T> task); |
submit 比 execute 多出来的那一个 Future,就是把「这次调用」的句柄交回给提交方。命令对象一旦入队,调用方手里就只剩这个句柄。
java.base/java/util/concurrent/ForkJoinTask.java(JDK 25),第 503 到 518 行:
1 | /** |
第 1285 行:
1 | protected abstract boolean exec(); |
任务体是子类实现的一个方法(exec,返回「是否已完成」),执行它的是框架的 doExec,外面裹着一层 status 状态机。命令对象进了框架之后,第一件事是管理自己的状态,执行排在第二步。
java.base/java/lang/invoke/LambdaMetafactory.java 第 71 到 77 行:
1 | * <p>Capture may involve allocation of a new function object, or may return |
捕获可能分配一个新函数对象,也可能复用一个已有的。这正好对上实测:lambda 形态在不逃逸时分配 0 字节,一旦逃逸就是每个 24 到 40 字节。你没法从源码判断这次捕获分不分配,只能看它有没有逃出去。
同一段的第 53 到 54 行还写了另一半:
1 | * <p>Linkage may involve dynamically loading a new class that implements |
链接阶段要么动态加载一个新类,要么复用一个已有的类。这解释了实测里 lambda 和具名类的字节数一模一样:LambdaMetafactory 在链接阶段就把实现类准备好了,每次迭代发生的是一次捕获,产出的实例字段和具名类完全相同。
java.base/java/lang/invoke/MethodHandle.java 第 97 到 104 行:
1 | * A Java method call expression naming { invokeExact} or { invoke} |
命令对象最后要落到一次调用上。invokeExact 的签名多态把「调用什么」推迟到运行时,LambdaMetafactory 是 invokedynamic 的引导方法。这两个机制合起来,是 JVM 对「把调用变成值」的底层支持:最小的命令对象(44 行的 Runnable)和最快的命令对象(被标量替换掉的 lambda)走的是同一条路。
java.desktop/javax/swing/undo/UndoManager.java。这是 JDK 自带的撤销栈,第 150 到 158 行:
1 | /** |
第 288 到 292 行:
1 | public synchronized void setLimit(int l) { |
默认上限是 100 条。JDK 自己写撤销栈,第一版就带了一个上限和一个淘汰策略:trimForLimit(第 194 行)保留以游标为中心的一段,把两端多出来的旧条目丢掉,丢掉时对每条调用 die()(第 255 行)。
六、结论
三样东西各自的价码
| 买到的东西 | 每操作成本 | 代价落在哪 |
|---|---|---|
| 撤销(反向操作) | 32 字节 + 回滚时间 | 撤销栈内存,操作必须可逆 |
| 撤销(快照) | 4 × 状态大小 + 32 字节 | 内存与状态成正比,前进和回滚各拷一次 |
| 排队 | 40 字节 + 一次锁 + 微秒级延迟 | 延迟交给队列水位,调用点控制不了 |
| 记录 / 重放 | 与撤销同级,另加序列化 | 日志体积、版本兼容 |
| 只是包一层(不逃逸) | 0 字节,耗时同量级 | 无 |
先算预算,再选实现
做撤销功能先把两个数字定下来:要能撤多少步、每条撤销记录有多大。两者相乘就是它的常驻内存。
文档编辑器,状态 4KB,撤销 100 步:快照路线 100 × 4112 字节 ≈ 411KB,反向路线 100 × 32 字节 ≈ 3.2KB。撤销 10,000 步:快照 41.4MB,反向 320KB。41.4MB 是一个进程能感觉到的内存,320KB 是噪声。
同一个编辑器如果每步操作的是「标点补全」这种小改动,反向记录里还要带上那几个字符,每条从 32 字节涨到 100 字节上下,仍然和 41MB 差两个数量级。快照路线的优势只在状态很小或者操作不可逆时才出现。
什么时候用
- 调用要在执行之前拿到手:撤销、排队、日志与重放、把操作发给另一个进程。这几种需求都要同一个表示,命令对象是这个表示的标准形态。
- 撤销栈:先看操作可不可逆。可逆就记反向操作,32 字节一条,和状态大小无关。不可逆、或者状态很小(几十字节)而操作很复杂时,用快照。
- 排队:当调用方不能等执行方(UI 事件、任务队列、跨线程的写路径)时才用。用的时候给出队列容量上限,否则水位没有边界。
什么时候不用
- 只需要一个函数值。
Runnable、Consumer、Supplier这些接口就是命令的抽象,不必再定义一个单方法的Command接口。实测里 lambda 形态和具名类形态的分配字节相同(不逃逸都是 0,强制分配都是 24),耗时也在同一个量级,多定义一个接口换不来收益。 - 同步调用、只转发一层。没有栈、没有队列、没有日志,命令对象唯一的产出是多一次对象分配(24 字节)和一层间接调用。
- 操作本身很重时,队列的开销占比小,可以用;操作在纳秒级时,队列的开销是操作本身的几十倍。 判据是两条成本的比例。
- 撤销深度不设上限。状态 4KB、撤销 10,000 步就是 41.4MB 的常驻内存;
UndoManager的默认值 100 是个经验值,不是随便定的。
一条判断顺序
    flowchart TD
    Q0["一次操作"] --> Q1{"执行之前<br/>需要拿到这次调用吗"}
    Q1 -->|不需要| A1["直接调用<br/>0 字节"]
    Q1 -->|需要| Q2{"由谁执行"}
    Q2 -->|同一个线程| A2["命令对象 + 撤销栈 / 日志"]
    Q2 -->|另一个线程 / 进程| A3["命令对象 + 队列<br/>40 字节 + 锁 + 水位延迟"]
    A2 --> Q3{"操作可逆吗"}
    Q3 -->|可逆| A4["记反向操作<br/>32 字节一条,与状态无关"]
    Q3 -->|不可逆| A5["记快照<br/>4 × 状态大小一条<br/>必须设上限"]
总结
- 10 万次操作四个形态的耗时(JDK 25):直接调用 0.83 ns,命令对象 0.70 ns,命令对象加撤销栈 4.76 ns,入队后另一线程执行 133.2 ns。
- 分配字节/操作:直接调用 0,命令对象 0(被标量替换),命令对象加撤销栈 36.0,入队 52.6。三个命令对象本身的实测大小是 24、32、40 字节。
- 关掉逃逸分析后,同一个命令对象形态的分配立刻变成 24 字节/操作,耗时涨 6.3 倍(JDK 21)与 6.0 倍(JDK 25)。命令对象的价格由「逃没逃出去」决定,跟它是不是对象无关。
- 排队形态的 p50 延迟 60.0µs,p99 0.21ms,队列峰值水位 8192(容量 8192),吞吐 125.0 ns/op,是直接调用的 176 倍。延迟由水位决定,水位由两个线程的相对速度决定。
- 撤销 10,000 次操作:反向操作 32 字节/条、总量 320KB、回滚 0.039ms(256 字节状态)与 0.038ms(4KB 状态),与状态大小无关;快照 256 字节状态 304 字节/条、总量 3.0MB,4KB 状态 4112 字节/条、总量 41.4MB,回滚耗时 1.409ms。
Runnable(JDK 25 的java.base/java/lang/Runnable.java)全文件 44 行,方法体只有一个run()。命令的最小定义。ForkJoinTask.doExec(:507-518)在执行任务体的前后维护status,exec()是子类实现的protected abstract boolean(:1285)。命令对象进框架后第一件事是状态管理。UndoManager的默认上限是 100 条(:156),超过就调trimForLimit(:194)以游标为中心裁掉两端的旧条目,每条调一次die()(:247、:255)。JDK 自己的撤销栈带淘汰策略。
参考资料
- Runnable (Java SE 25)
- Executor (Java SE 25)
- ExecutorService (Java SE 25)
- ForkJoinTask (Java SE 25)
- LambdaMetafactory (Java SE 25)
- MethodHandle (Java SE 25)
- UndoManager (Java SE 25)
- ArrayBlockingQueue (Java SE 25)
- com.sun.management.ThreadMXBean#getThreadAllocatedBytes
- java 命令参考:-XX:+DoEscapeAnalysis
- 设计模式——策略:换成函数之后没有变快
- 设计模式——备忘录:快照的边界
系列索引:设计模式系列